SQL-Ex blog
SQL CASE: знать и избегать малоизвестных неприятностей
Неприятности с CASE? Действительно?
Нет, пока вы не столкнетесь с 3 неприятными проблемами, которые могут вызвать ошибки во время выполнения и ухудшить производительность.
Если вы пролистаете подзаголовки, чтобы увидеть эти проблемы, я не буду вас винить. Читатели, к которым я также отношусь, нетерпеливы.
Я уверен, что вы уже знакомы с основами SQL CASE, поэтому я не буду мучит вас длинным введением. Давайте углубимся в понимание того, что происходит под капотом.
1. SQL CASE не всегда оценивается последовательно
Выражения в SQL CASE по большей части оцениваются последовательно или слева направо. Хотя совсем другое дело, когда они используются с агрегатными функциями. Давайте рассмотрим пример:
Вышеприведенный код выглядит обычно. Если я спрошу вас, какой результат будет получен, вы, вероятно, ответите 1. Визуальная проверка скажет нам это, поскольку переменная @value установлена в 0. Если @value равна 0, то результат равен 1.
Но не в этом случае. Вот действительный результат, полученный в SQL Server Management Studio:
Когда условное выражение использует агрегатные функции типа MAX() в SQL CASE, они оцениваются в первую очередь. Таким образом, MAX(1/@value) вызывает ошибку деления на нуль, поскольку @value равна 0.
Ситуация становится еще более неприятной, когда скрыта. Я объясню это позже.
2. Простое выражение SQL CASE оценивается многократно
Хороший вопрос. Действительно, здесь вообще нет никаких проблем, если вы используете литералы или простые выражения. Но если вы используете подзапросы в качестве условного выражения, вы сильно удивитесь.
Прежде, чем проверять пример ниже, лучше восстановить отсюда копию базы данных. Мы будем использовать её в последующих примерах.
Теперь рассмотрим следующий очень простой пример:
Очень простой, правда? Он возвращает 1 строку с одним столбцом данных. STATISTICS IO показывает минимальное число логических чтений.
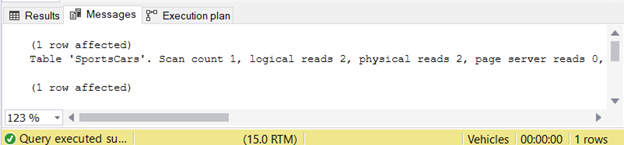
Рис.1. Логические чтения таблицы SportsCars до использования запроса в качестве подзапроса в SQL CASE
Замечание для непосвященных. Чем больше логических чтений, тем медленнее запрос. О логических чтениях можно почитать здесь.
План выполнения тоже показывает простой процесс:
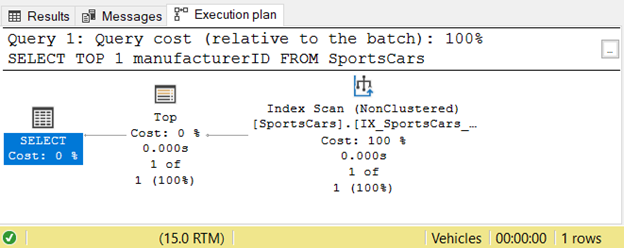
Рис.2. План выполнения для запроса к SportsCar до его использования как подзапроса в SQL CASE
Давайте теперь поместим этот запрос в выражение CASE:
Анализ
Скрестите пальцы, поскольку сейчас логические чтения увеличатся в 4 раза.

Рис.3. Логические чтения после использования подзапроса в SQL CASE
Удивительно! По сравнению всего с двумя логическими чтениями на рис.1 мы получили в 4 раза больше. Таким образом, запрос стал в 4 раза медленнее. Как это могло произойти? Мы видим подзапрос только в одном месте.
Но это не конец истории. Посмотрите план выполнения:
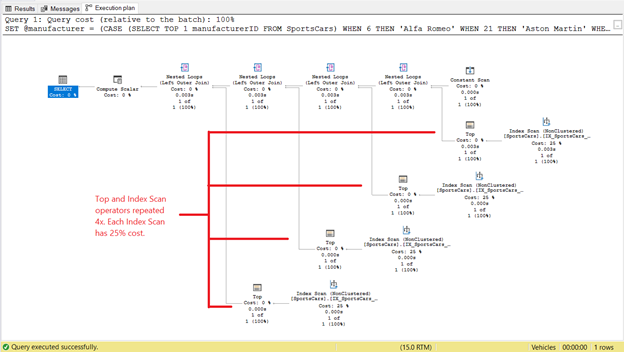
Рис.4. План выполнения после использования простого запроса в качестве выражения подзапроса в SQL CASE
Мы видим 4 экземпляра операторов Top и Index Scan на рис.4. Если каждый Top и Index Scan потребляет 2 логических чтения, это объясняет, почему число логических чтений стало 8 на рис.3. И, поскольку каждый Top и Index Scan имеют 25% стоимости, это подтверждает сказанное.
Но это еще не все. Свойства оператора Compute Scalar показывают, как обрабатывается весь оператор.

Рис.5. Свойства Compute Scalar показывают 4 выражения CASE WHEN
Мы видим 3 выражения CASE WHEN в свойстве Defined Values оператора Compute Scalar. Это выглядит так, как будто простое выражение CASE стало поисковым выражением CASE типа:
Хорошее исправление? Давайте посмотрим логические чтения в STATISTICS IO:

Рис.6. Логические чтения после извлечения подзапроса из выражения CASE
Мы видим меньше логических чтений в модифицированном запросе. Извлечение подзапроса и присвоение результата переменной получается значительно лучше. Что насчет плана выполнения? Посмотрите ниже:
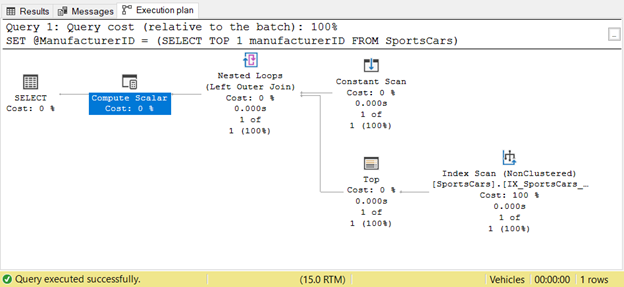
Рис.7. План выполнения после извлечения подзапроса из выражения CASE
Оператор Top и Index Scan появляются однажды, а не 4 раза. Замечательно!
На заметку: Не используйте подзапрос в качестве условия в операторе CASE. Если необходимо получить значение, поместите сначала результат подзапроса в переменную. Затем используйте эту переменную в выражении CASE.
Эти три встроенные функции тайно преобразуются в SQL CASE
Я использовал Immediate IF, или IIF, в Visual Basic и Visual Basic for Applications. Это является также эквивалентом тернарного оператор в C#: ? : .
Эта функция принимает условие и возвращает 1 из 2 аргументов в зависимости от результатов условия. И эта функция также имеется в T-SQL.
Но это просто обертка более длинного выражения CASE. Откуда нам это известно? Давайте проверим пример.
Результатом этого запроса является ‘No’. Однако проверьте план выполнения, а также свойства Compute Scalar.
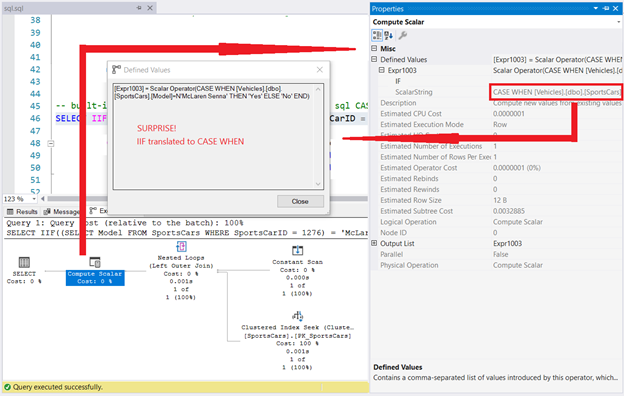
Рис.8. IIF оказывается CASE WHEN в плане выполнения
Поскольку IIF является CASE WHEN, как вы думаете, что произойдет, если выполнить что-то подобное этому?
Будет получена ошибка деления на нуль, если @noOfPayments равен нулю. То же самое происходило в первом случае, рассмотренном ранее.
Вы можете спросить, что вызывает эту ошибку, поскольку результатом запроса является TRUE, и должно получиться 83333.33. Опять вернитесь к случаю 1.
Таким образом, если вы столкнулись с такой ошибкой при использовании IIF, виноват SQL CASE.
COALESCE
COALESCE — это также сокращенная форма выражения SQL CASE. Она оценивает список значений и возвращает первое не-NULL значение. Вот пример, который показывает, что подзапрос вычисляется дважды.
Давайте посмотрим план выполнения и свойство Defined Values оператора Compute Scalar.
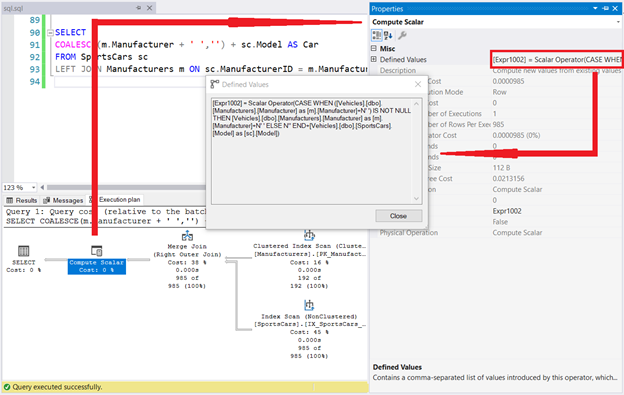
Рис.9. COALESCE преобразуется в SQL CASE в плане выполнения
Разумеется SQL CASE. Нигде не упоминается COALESCE в окне Defined Values. Это доказывает тайный секрет этой функции.
Но это не все. Сколько раз вы увидели [Vehicles].[dbo].[Styles].[Style] в окне Defined Values? ДВАЖДЫ! Это согласуется с официальной документацией Microsoft. Представьте, что один из аргументов в COALESCE является подзапросом. Тогда получаем удвоение логических чтений и замедление выполнения.
CHOOSE
Наконец, CHOOSE. Она подобна функции CHOOSE в MS Access. Она возвращает одно значение из списка значений на основе позиции индекса. Она также действует как индекс массива.
Давайте посмотрим, сможем ли мы получить трансформацию в SQL CASE в примере. Проверьте нижеприведенный код:
Это наш пример с CHOOSE. Теперь давайте посмотрим план выполнения и свойство Defined Values в операторе Compute Scalar:

Рис.10. Как видно в плане выполнения CHOOSE преобразуется в SQL CASE
Вы видите ключевое слово CHOOSE в окне Defined Values на рис.10? Как насчет CASE WHEN?
Подобно предыдущим примерам, эта функция CHOOSE есть просто оболочка для более длинного выражения CASE. И поскольку запрос имеет 2 пункта для CHOOSE, ключевые слова CASE WHEN появляются дважды. Смотрите в окне Defined Values красные прямоугольники.
Однако CASE WHEN появлялось более двух раз. Это происходит из-за выражения CASE во внутреннем запросе CTE. Если посмотреть внимательно, эта часть внутреннего запроса также появляется дважды.
Функция SQL UCASE ()
() Функция UCASE значение поля преобразуется в верхний регистр.
SQL UCASE) синтаксис (
Синтаксис для SQL Server
Демонстрационная база данных
В этом уроке мы будем использовать w3big образец базы данных.
Ниже приводится выбранные "сайты" таблица данных:
SQL UCASE () примеры
Следующий оператор SQL выбран из "Веб-сайты" таблицы "имя" и столбец "URL", а столбец значения преобразования "имя" в верхнем регистре:
Функция UCASE (UPPER)
Функция UCASE (UPPER) переводит строку в верхний регистр (то есть из маленьких букв делает большие).
См. также команду LCASE (LOWER), которая переводит строку в нижний регистр.
Синтаксис
Примеры
Все примеры будут по этой таблице workers, если не сказано иное. Подчеркивание имитирует пробелы:
| id айди |
name имя |
age возраст |
salary зарплата |
|---|---|---|---|
| 1 | Дима | 23 | 300 |
| 2 | Петя | 24 | 400 |
| 3 | Вася | 25 | 500 |
Пример
В данном примере строка name преобразуется к верхнему регистру с помощью UCASE:
SQL запрос выберет следующие строки:
| id айди |
name имя |
age возраст |
salary зарплата |
|---|---|---|---|
| 1 | ДИМА | 23 | 300 |
| 2 | ПЕТЯ | 24 | 400 |
| 3 | ВАСЯ | 25 | 500 |
Пример
В данном примере строка name преобразуется к верхнему регистру с помощью UPPER: