Traffic Shaping
Шейпинг — ограничение пропускной способности канала для отдельного узла сети ниже технических возможностей канала до узла. Шейпинг обычно используется как средство ограничения максимального потребления трафика со стороны узла сети.
Устройство (или программу), осуществляющую ограничение скорости называют шейпер.
Простейший алгоритм
Алгоритм шейпинга для сетей, работающих с пакетами (фреймами) данных, обычно заключается в создании очереди пакетов от клиента. В единицу времени пропускаются пакеты общим объёмом не более N байт (где N — выставленное ограничение). В случае, если объём передаваемых данных превышает выделенную клиенту пропускную способность и очередь заполнена, лишние пакеты не принимаются. За счёт ненулевого размера очереди в начале соединения возможно временное превышение ограничения по скорости.
В случае поддержки
См. также
-
(один из алгоритмов шейпинга)
Wikimedia Foundation . 2010 .
Смотреть что такое «Traffic Shaping» в других словарях:
Traffic shaping — (also known as packet shaping ) is the control of computer network traffic in order to optimize or guarantee performance, lower latency, and/or increase usable bandwidth by delaying packets that meet certain criteria. [… … Wikipedia
Traffic-Shaping — ist eine Funktion eines Rechnernetzes zur Steuerung des Datenflusses von IP Paketen, ATM Zellen, Ethernet Frames oder anderen Transfereinheiten nach definierten Kriterien. Es ist unidirektional, das heißt es arbeitet im Gegensatz zur… … Deutsch Wikipedia
Traffic Shaping — ist ein Telekommunikations Verfahren bei dem beim Senden der Datenfluss von IP Paketen, ATM Zellen, Ethernet Frames oder anderen Transfereinheiten nach definierten Kriterien gesteuert wird. Es ist unidirektional, das heißt, es arbeitet im… … Deutsch Wikipedia
Traffic shaping — ist ein Telekommunikations Verfahren bei dem beim Senden der Datenfluss von IP Paketen, ATM Zellen, Ethernet Frames oder anderen Transfereinheiten nach definierten Kriterien gesteuert wird. Es ist unidirektional, das heißt, es arbeitet im… … Deutsch Wikipedia
Traffic shaping — Le Traffic shaping ou régulation de flux est le contrôle du volume des échanges sur un réseau informatique dans le but d’optimiser ou de garantir les performances, une latence plus basse ou d’augmenter la bande passante utilisable en retardant… … Wikipédia en Français
Traffic shaping — Este artículo o sección tiene un estilo difícil de entender para los lectores interesados en el tema. Si puedes, por favor edítalo y contribuye a hacerlo más accesible para el público general, sin eliminar los detalles técnicos que interesan a… … Wikipedia Español
traffic shaping — noun The technique of slowing down Internet packet flow rate by narrowing the bandwidth to avoid a possible system overload … Wiktionary
traffic shaping — ● ►en loc. m. ►NET Contrôle de la bande passante utilisée … Dictionnaire d’informatique francophone
Traffic-Shaper — Traffic Shaping ist ein Telekommunikations Verfahren bei dem beim Senden der Datenfluss von IP Paketen, ATM Zellen, Ethernet Frames oder anderen Transfereinheiten nach definierten Kriterien gesteuert wird. Es ist unidirektional, das heißt, es… … Deutsch Wikipedia
Traffic policing — is monitoring network traffic for conformity with a traffic contract and if required, dropping traffic to enforce compliance with that contract. Traffic sources which are aware of a traffic contract sometimes apply Traffic Shaping in order to… … Wikipedia
Каждому по потребностям: ограничение полосы пропускания на Linux-овом шлюзе
Разделение, ограничение и управление трафиком — актуальная и сложная задача,
которую обычно возлагают на дорогостоящее специальное сетевое оборудование. Но
решить ее можно и с помощью подсистемы Linux-ядра Traffic Control, не
уступающей по возможностям Cisco IOS.
Допустим, существует офис некой компании X, и в нем числится около ста
сотрудников, каждый из которых может выходить в интернет через шлюз. Скорость
внешнего канала составляет 100 Мбит. Системный администратор справился с
настройкой шлюза в силу своих способностей – что и посчитал достаточным для
правильного функционирования сети. К чему это привело? К увольнению
недальновидного (или ленивого) админа.
Со временем большинство сотрудников начали жаловаться на "тормоза" интернета,
а другие, наоборот, заметили, что могут качать торренты в рабочее время на очень
внушительных скоростях. Говоря админским языком, в сети образовались заторы,
вызванные теми, кто в тот момент активно ее использовал. Стомегабитный канал
распределялся неравномерно между пользователями, и каждый мог занять его весь.
Остальным приходилось ждать.
Краткий сценарий
Решение проблемы: разделение канала между сотрудниками с ограничением
скорости! Сеть будет функционировать на "5+", если каждый сотрудник получит в
распоряжение отдельный канал, скорость которого будет составлять 1 Мбит. Тогда
отдельно взятый интернет-пользователь не сможет занять больше причитающейся ему
доли и отобрать часть канала у других. С точки зрения компании, это еще и
отличный способ экономии (после разделения канала оказывается, что его суммарная
пропускная способность даже излишне высока) и ведения статистики по трафику для
отдельно взятого сотрудника.
Обычно для разделения канала с ограничением скорости используются возможности
операционной системы IOS, на которой функционирует сетевое оборудование Cisco
(дешевые решения от других производителей, таких, как Dlink, Trendnet и Netgear,
вообще не обладают такой возможностью). Однако особой необходимости тратить
баснословные суммы на аппаратные шлюзы от Cisco нет. Ядро Linux уже более пяти
лет как содержит в себе код сложной и весьма функциональной подсистемы
управления трафиком Traffic Control, которая по некоторым параметрам даже
обходит IOS.
Подсистема Traffic Control
Подсистема Traffic Control поддерживает множество методов
классификации, приоритезации, разделения и ограничения трафика (как исходящего,
так и входящего). Она очень гибка в настройке, но сложна в понимании. Поэтому мы
уделим значительную часть статьи теоретическому материалу и лишь затем приступим
к решению задачи с помощью HTB – одной из наиболее гибких и популярных дисциплин
Traffic Control.
Подсистема управления трафиком Linux позволяет делать следующее:
- Shaping. Шейпинг — ограничение трафика, задержка пакетов с
целью создания желаемой скорости передачи. Может использоваться не только для
"сужения" исходящего канала, но и для сглаживания бросков во время пиковых
нагрузок. - Scheduling. Планирование – упорядочивание типов трафика в
канале. Позволяет избегать задержек для критичных типов трафика (QoS). - Policing. Политика входящего трафика. Позволяет ограничить
входящий трафик путем уничтожения превысивших лимит пакетов. Помогает бороться
с DDoS.
Отметим, что ограничение без потерь возможно только в отношении исходящего
трафика. Стек протоколов TCP/IP не предусматривает возможности заставить
удаленную сторону слать пакеты медленнее (и это правильно).
В обработке трафика участвуют три ключевых сущности: дисциплины обработки
пакетов, классы и фильтры. Настройка эффективной системы ограничения трафика
невозможна без понимания механизмов их работы, роли и связи друг с другом. Мы в
подробностях рассмотрим каждую из них:
- Дисциплина обработки пакетов (qdisc) — очередь пакетов и
закрепленный за ней алгоритм обработки. - Класс (class) — логический контейнер, который может
содержать несколько подклассов или дисциплину. - Фильтр (filter) — механизм классификации трафика.
В простейшем варианте путь пакета от приложения до удаленного конца
соединения выглядит так. Приложение генерирует (пользуясь услугами библиотек и
ядра) сетевой пакет и отдает его ядру, которое помещает пакет в очередь FIFO
(первым пришел, первым ушел). Драйвер сетевой карты время от времени обращается
к специальному алгоритму ядра, который извлекает из очереди пакет и отдает его
драйверу. Далее пакет уходит к адресату. Все просто.
Linux действует таким же образом. Но формат представления очереди и алгоритм
ее обработки, в совокупности называемые дисциплиной обработки пакетов, в нем
заменяемы! По умолчанию используется дисциплина pfifo_fast, реализующая очередь
FIFO. Пользуясь утилитой tc, администратор может заменить ее на другую
дисциплину, которая будет переупорядочивать пакеты (планирование), задерживать
их на определенное время (шейпинг) или выполнять другие действия.
Дисциплины классов
Traffic Control не был бы столь гибким, если бы не позволял разбивать
трафик на классы с помощью классовой дисциплины и набора ее подклассов.
Схематически классовая дисциплина очень похожа на файловую систему, c тем лишь
исключением, что ее корень или классы (каталоги) могут содержать либо дисциплину
(файл), либо подклассы (подкаталоги). Одно из двух. Классовые дисциплины и
классы предназначены для построения дерева выбора. Сначала весь трафик
разбивается на несколько общих классов (например, трафик до Отдела-1, трафик до
специализированных внутренних серверов и т.д.), а затем каждый из них
разбивается на несколько подклассов (например, трафик до DNS-сервера Отдела-1),
за которыми уже могут быть закреплены дисциплины.
Чтобы управлять тем, дисциплиной какого класса будет обработан определенный
тип трафика, классовые дисциплины позволяют подключать к себе фильтры. Это дает
возможность "завернуть" определенный трафик в один из ее подклассов. Фильтры
используют классификаторы для идентификации пакетов нужного типа и как бы
говорят ядру: "Этот вид трафика должен обрабатываться с помощью дисциплины вот
этого класса". Существует несколько разных классификаторов. Самыми популярными
являются u32 и fw. Первый позволяет выделять пакеты по исходящим адресам и
адресам назначения, портам, парам "хост:порт", типам протокола и типу сервиса.
Второй классифицирует пакеты путем чтения маркировок, записанных брандмауэром
iptables/netfilter (цель MARK).
За каждым сетевым интерфейсом должны быть закреплены две особые дисциплины:
корневая дисциплина (root qdisc) и входящая дисциплина (ingress qdisc). В первую
помещается весь исходящий трафик (по умолчанию используется дисциплина
pfifo_fast). Во вторую — входящий.
Для идентификации дисциплин и классов используются дескрипторы. Они состоят
из старшего и младшего номеров. Первый — это произвольное число, однако все
классы, имеющие общего родителя, должны иметь одинаковый старший номер. Младший
номер используется либо для произвольной идентификации классов, либо для
указания на то, что объект является дисциплиной (номер 0). Специальный
дескриптор ffff:0 зарезервирован для входящей дисциплины.
Утилита tc
Для конфигурирования подсистемы управления трафиком предназначена утилита tc
из пакета iproute2. Она принимает набор команд в качестве аргументов, с помощью
которых можно создавать классы, привязывать к ним дисциплины и добавлять
фильтры. Синтаксис ее похож на синтаксис команды ipfw из операционной системы
FreeBSD, так что знакомые с ним быстро освоятся.
Для примера рассмотрим простейший вариант использования:
# tc qdisc add dev eth0 root tbf rate 256kbit \
latency 50ms burst 1540
Эта команда устанавливает ограничение для всего исходящего трафика в 256
Кбит/с. Разберем подробнее все аргументы tc:
- qdisc add — добавляем новую дисциплину (для удаления используй del).
- dev eth0 — указываем устройство, к которому будет привязана дисциплина.
- root — наша дисциплина корневая (будет обрабатываться весь трафик).
- tbf — имя дисциплины.
- rate 256kbit latency 50ms burst 1540 — параметры, специфичные для данной
дисциплины: rate — ограничение скорости, latency — максимальный "возраст"
пакета в очереди, burst — размер буфера.
Проще говоря, команда подключает дисциплину tbf в качестве корневой на
интерфейсе eth0 и задает ей несколько параметров. Token Bucket Filter (TBF) —
это бесклассовая дисциплина, которая передает поступающие пакеты с заданной
скоростью.
Способ указания скоростей и других величин в утилите tc несколько отличается
от общепринятого, поэтому следующую табличку придется запомнить:
Формат указания скорости в утилите tc
mbps = 1024 kbps = 1024 * 1024 bps => Байт/с
mbit = 1024 kbit => Кбит/с
mb = 1024 kb = 1024 * 1024 b => Байт
Заменить стандартную корневую дисциплину на любую бесклассовую совсем
несложно, но на таком коне далеко не уедешь. Для создания разветвленной системы
управления трафиком нужны классовые дисциплины, классы, фильтры и целое дерево
дисциплин. Чтобы настроить все это, может понадобиться не один десяток команд.
Мы рассмотрим несколько вводных примеров, перед тем как перейти к обсуждению
дисциплины HTB.
Пример дерева дисциплин
Классовая дисциплина prio предназначена для классификации трафика с помощью
фильтров или приоритезации. По умолчанию prio содержит три класса, в каждом из
которых находится обычная дисциплина FIFO. Когда сетевая карта обращается за
очередным пакетом, проверяется класс :1. Если он не содержит пакетов,
проверяется класс :2 и только в последнюю очередь — :3. Получается, что пакеты
класса :1 получают наивысший приоритет, а :3 — наименьший. Решение о том, в
какой класс направить трафик, дисциплина prio принимает на основе поля TOS
сетевого пакета.
Подключим дисциплину prio в качестве корневой и назначим ей имя (дескриптор)
"1:0":
# tc qdisc add dev eth0 root handle 1:0 prio
Результат этой команды: дисциплина prio, подключенная в качестве корня, и три
класса (1:1, 1:2 и 1:3) внутри нее, к каждому из которых подключена дисциплина
FIFO.
Мы вольны заменить любую из дисциплин, подключенных к классам, чем и
воспользуемся для подключения дисциплины sfq с дескриптором "10:0" к классу
"1:1":
# tc qdisc add dev eth0 parent 1:1 handle 10:0 sfq
Это обеспечит справедливое разделение канала между интерактивными
приложениями (они имеют наивысший приоритет). Чтобы остальные приложения, такие
как менеджеры закачек и torrent-клиенты (которые обычно шлют пакеты с меньшим
приоритетом в поле TOS), не мешали интерактивным, ограничим для них скорость:
# tc qdisc add dev eth0 parent 1:2 handle 20:0 tbf \
rate 512kbit buffer 3200 limit 3000
# tc qdisc add dev eth0 parent 1:3 handle 30:0 tbf \
rate 256kbit buffer 6400 limit 3000
Такая схема будет плохо работать в реальной жизни, но для примера вполне
годится.
Теперь сделаем так, чтобы весь SSH-трафик имел наивысший приоритет. Для этого
закрепим за корневой дисциплиной prio фильтр, который будет перенаправлять
пакеты с портом назначения 22 в дисциплину класса "1:1".
# tc filter add dev eth0 parent 1:0 protocol ip prio 1 \
u32 match ip dport 22 0xffff flowid 1:1
Рассмотрим подробнее механизм подключения фильтров.
- filter add — Добавляем фильтр.
- dev eth0 — Указываем устройство.
- parent 1:0 — Дескриптор родителя.
- protocol ip — Протокол, с которым будет работать фильтр.
- prio 1 — Присваиваем классифицированному трафику приоритет 1 (наивысший).
- u32 — Используемый классификатор.
- match ip dport 22 0xffff — Параметры классификатора. В данном случае
указание отбирать пакеты с портом назначения 22. - flowid 1:1 — Отфильтрованные пакеты должны иметь класс "1:1" и
обрабатываться с помощью его дисциплины.
Это все. Мы получили разветвленную систему управления трафиком, выполнив
всего пять команд.
Классовая дисциплина HTB
Еще в первый релиз системы Traffic Control была включена классовая
дисциплина CBQ (Class-Based Queue), предназначенная для реализации сложных
систем управления и ограничения трафика. CBQ завоевала большую популярность
благодаря своей гибкости, но была очень сложна, запутана и обладала рядом
ограничений (тут и необходимость заранее указывать максимальную пропускную
способность канала, и неэффективный алгоритм шейпинга).
Поэтому в скором времени появилась более эффективная и простая в
использовании альтернатива под названием HTB (Hierarchical Token
Bucket). Классовая дисциплина HTB предназначена для разделения полосы
пропускания между различными видами трафика, каждому из которых может быть
предоставлена полоса гарантированной ширины. Она не обладает гибкостью CBQ, но
гораздо более проста в настройке и лишена ее недостатков. Именно на HTB сегодня
принято строить сложные и эффективные системы ограничения трафика.
Рассмотрим применение HTB на примере, представленном в начале статьи, но
более усложненном. Допустим, у нас есть шлюз на Linux, интерфейс eth1 которого
смотрит наружу, а eth0 — во внутреннюю сеть. Ширина канала — 100 Мбит. Задача:
разделить канал между сотрудниками компании так, чтобы директор и сотрудники
IT-отдела могли выходить в интернет без скоростных ограничений, маркетологи
получили ограничение в 2 Мбит/c каждый, менеджеры — 1 Мбит/c, секретари — 512
Кбит/c, а все остальные — 256 Кбит/c.
Есть два варианта решения. Первый: составить огромную таблицу IP-адресов и
создать специальные правила ограничений для каждого адреса (с точки зрения
системы HTB это будет выглядеть как огромный набор классов и фильтров, по одному
на каждый адрес). Второй: разбить всех потребителей канала на мета-группы,
каждую из которых выделить в отдельную подсеть (директор и IT-отдел —
172.16.1.0, маркетологи — 172.16.2.0, менеджеры — 172.16.3.0, секретари —
172.16.4.0, остальные — 172.16.5.0). Для каждой подсети назначить суммарное для
всех ее членов ограничение со справедливым разделением канала.
Мы же создадим симбиоз этих двух систем, когда трафик сначала будет
разбиваться на подклассы, соответствующие подсетям, а уже потом на отдельные
классы для каждого пользователя.
Для начала создадим работоспособную систему, основанную только на втором
варианте решения задачи. Подключим дисциплину HTB в качестве корневой:
# tc qdisc add dev eth0 root handle 1: htb default 15
Опция "default 15" говорит о том, что весь неклассифицированный фильтрами
трафик должен быть обработан с помощью дисциплин класса "1:15". Создадим
корневой класс, под который будет попадать весь трафик (это нужно для реализации
заимствования):
# tc class add dev eth0 parent 1: classid 1:1 htb \
rate 100mbps ceil 100mbps
Создадим в нем пять подклассов для пяти наших подсетей. Директору и IT-отделу
выделим 30-мегабитный канал с возможностью его расширения (заимствования) вплоть
до 100 Мбит в случаях, когда остальные каналы не заняты:
# tc class add dev eth0 parent 1:1 classid 1:11 \
htb rate 30mbps ceil 100mbps
Для маркетологов выделим 20-мегабитный канал:
# tc class add dev eth0 parent 1:1 classid 1:12 \
htb rate 20mbps
Менеджерам – 10 Мбит/с:
# tc class add dev eth0 parent 1:1 classid 1:13 htb rate 10mbps
Секретарям – 5 Мбит/с:
# tc class add dev eth0 parent 1:1 classid 1:14 htb rate 5mbps
И – 40 Мбит/с на всех остальных:
# tc class add dev eth0 parent 1:1 classid 1:15 htb rate 40mbps
По умолчанию к вновь созданным классам подключены дисциплины, реализующие
очередь FIFO. Это нам не подходит. Чтобы канал равномерно распределялся между
всеми участниками подсети, мы должны подключить к ним дисциплину sfq:
# tc qdisc add dev eth0 parent 1:11 handle 10:0 sfq perturb 10
# tc qdisc add dev eth0 parent 1:12 handle 20:0 sfq perturb 10
# tc qdisc add dev eth0 parent 1:13 handle 30:0 sfq perturb 10
# tc qdisc add dev eth0 parent 1:14 handle 40:0 sfq perturb 10
# tc qdisc add dev eth0 parent 1:15 handle 50:0 sfq perturb 10
Теперь подключим фильтры, которые будут классифицировать трафик:
# tc filter add dev eth0 protocol ip parent 1:0 prio 1 \
u32 match ip src 172.16.1.0/24 flowid 1:11
# tc filter add dev eth0 protocol ip parent 1:0 prio 1 \
u32 match ip src 172.16.2.0/24 flowid 1:12
# tc filter add dev eth0 protocol ip parent 1:0 prio 1 \
u32 match ip src 172.16.3.0/24 flowid 1:13
# tc filter add dev eth0 protocol ip parent 1:0 prio 1 \
u32 match ip src 172.16.4.0/24 flowid 1:14
Для "всех остальных" фильтр не нужен, потому как мы уже указали дефолтовый
класс неклассифицированного трафика.
Все, система будет работать, но не обеспечит жесткого ограничения для каждого
пользователя (если, например, в определенный момент времени интернетом будет
пользоваться только один менеджер, ему достанутся все 10 Мбит, отведенные для
всех менеджеров). Жесткое ограничение можно реализовать, если вместо дисциплин
подключить к классам другие классы HTB, по одному на каждого пользователя, и
создать соответствующие фильтры.
Для примера, установим ограничение в 256 Кбит/с для пользователя,
находящегося в подсети "все остальные". Сначала добавим к "классу-подсети" новый
"класс-пользователь":
# tc class add dev eth0 parent 1:15 classid 1:150 \
htb rate 256kbps
# tc filter add dev eth0 protocol ip parent 1:15 prio 1 \
u32 match ip src 172.16.1.32 flowid 1:150
Подключать к классу дисциплину нет необходимости, так как по умолчанию к нему
уже подключена дисциплина FIFO. Подобные команды придется выполнить в отношении
каждого пользователя, не забывая давать им уникальные дескрипторы класса. При
желании все это нетрудно упаковать в простой скрипт, который будет проходить по
списку IP-адресов и выполнять связку команд для каждого адреса.
Ограничение скорости передачи трафика. Policer или shaper, что использовать в сети?
Когда речь заходит об ограничении пропускной способности на сетевом оборудовании, в первую очередь в голову приходят две технологи: policer и shaper. Policer ограничивает скорость за счёт отбрасывания «лишних» пакетов, которые приводят к превышению заданной скорости. Shaper пытается сгладить скорость до нужного значения путём буферизации пакетов. Данную статью я решил написать после прочтения заметки в блоге Ивана Пепельняка (Ivan Pepelnjak). В ней в очередной раз поднимался вопрос: что лучше – policer или shaper. И как часто бывает с такими вопросами, ответ на него: всё зависит от ситуации, так как у каждой из технологий есть свои плюсы и минусы. Я решил разобраться с этим чуточку подробнее, путём проведения нехитрых экспериментов. Полученные результаты подкатом.
И так, начнём с общей картинки разницы между policer и shaper.
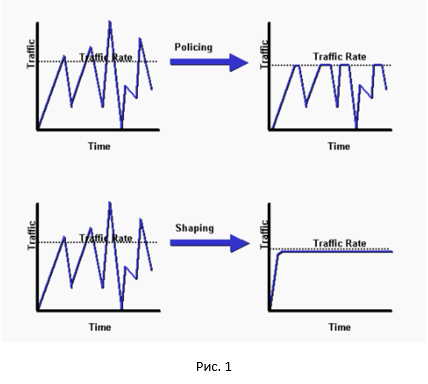
Как видно, policer срезает все пики, shaper же делает сглаживание нашего трафика. Достаточно неплохое сравнение между policer и shaper можно найти здесь.
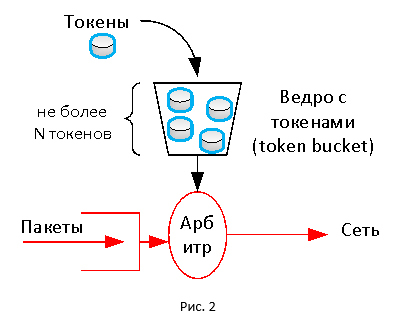
Обе технологии в своей основе используют механизм токенов (token). В этом механизме присутвует виртуальное ограниченное по размеру ведро (token bucket), в которое с некой регулярностью поступают токены. Токен, как проездной, расходуется для передачи пакетов. Если токенов в ведре нет, то пакет отбрасывается (могут выполняться и другие действия). Таким образом, мы получаем постоянную скорость передачи трафика, так как токены поступают в ведро в соответствии с заданной скоростью.
Скорость сессии обычно меряется в отведённый промежуток времени, например, за 5 сек или 5 минут. Брать мгновенное значение бессмысленно, так как данные всегда передаются на скорости канала. При этом если мы будем делать усреднение за разные временные интервалы, мы получим разные графики скорости передачи данных, так как трафик в сети не равномерный. Я думаю, любой с этим сталкивался, строя графики в системе мониторинга.
Механизм токенов позволяет обеспечить гибкость в настройке ограничения скорости. Размер ведра влияет на то, как мы будем усреднять нашу скорость. Если ведро большое (т.е. токенов там может скопиться много), мы позволим трафику сильнее «выпрыгивать» за отведенные ограничения в определённые моменты времени (эквивалент усреднения на большем промежутке времени). Если размер ведра маленький, то трафик будет более равномерный, крайне редко превышая заданный порог (эквивалент усреднения на маленьком промежутке времени).
В случае policer’а наполнение ведра происходит каждый раз, когда приходит новый пакет. Количество токенов, которые загружаются в ведро, зависит от заданной скорости policer’а и времени, прошедшего с момента поступления последнего пакета. Если токенов в ведре нет, policer может отбросить пакеты или, например, перемаркировать их (назначить новые значения DSCP или IPP). В случае shaper’а наполнение ведра происходит через равные промежутки времени независимо от прихода пакетов. Если токенов не хватает, пакеты попадают в специальную очередь, где ждут появления токенов. За счёт этого имеем сглаживание. Но если пакетов приходит слишком много, очередь shaper’а в конечном счёте переполняется и пакеты начинают отбрасываться. Стоит отметить, что приведённое описание является упрощённым, так как и policer и shaper имеют вариации (детальный разбор данных технологий займёт объём отдельной статьи).
Эксперимент
А как это выглядит на практике? Для этого соберём тестовый стенд и проведём следующий эксперимент. Наш стенд будет включать устройство, которое поддерживает технологии policer и shaper (в моём случае – это Cisco ISR 4000; подойдёт устройство любого вендора аппаратное или программное, которое поддерживает данные технологии), генератор трафика iPerf и анализатор трафика Wireshark.
Сначала посмотрим на работу policer. Настроим ограничение скорости равным 20 Мбит/с.
В iPerf запускаем генерацию трафика в рамках четырёх потоков, используя протокол TCP.
Средняя скорость составила 17.1 Мбит/с. Каждая сессия получила разную пропускную способность. Обусловлено это тем, что настроенный в нашем случае policer не различает потоки и отбрасывает любые пакеты, которые превышают заданное значение скорости.
С помощью Wireshark собираем дамп трафика и строим график передачи данных, полученный на стороне отправителя.
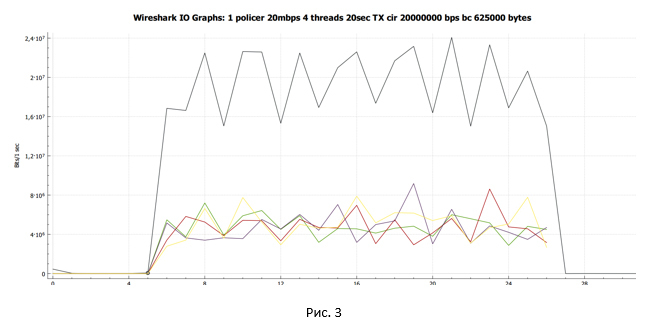
Чёрная линия показывают суммарный трафик. Разноцветные линии – трафик каждого потока TCP. Прежде чем делать какие-то выводы и углубляться в вопрос, давайте посмотрим, что у нас получится, если policer заменить на shaper.
Настроим shaper на ограничение скорости 20 Мбит/с.
При настройке используем автоматическое выставляемое значение размера ведра токенов BC и BE равное 8000. Но меняем размер очереди с 83 (по умолчанию в версии IOS XE 15.6(1)S2) на 200. Сделано это сознательно, чтобы получить более чёткую картину, характерную для shaper’а. На этом вопросе мы остановимся более подробно в подкате «Влияет ли глубина очереди на нашу сессию?».
В iPerf запускаем генерацию трафика в рамках четырёх потоков, используя протокол TCP.
Средняя скорость составила 19.3 Мбит/с. При этом каждый поток TCP получил примерно одинаковую пропускную способность.
С помощью Wireshark собираем дамп трафика и строим график передачи данных, полученный на стороне отправителя.
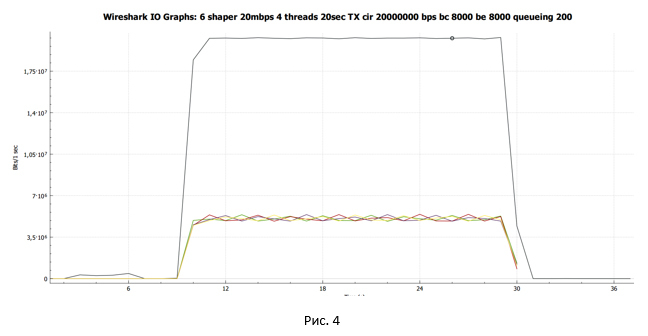
Чёрная линия показывают суммарный трафик. Разноцветные линии – трафик каждого потока TCP.
Сделаем первые промежуточные выводы:
- В случае policer полезная пропускная способность составила 17.1 Мбит/с. Каждый поток в разные моменты времени имел разную пропускную способность.
- В случае shaper полезная пропускная способность составила 19.3 Мбит/с. Все потоки имели примерно одинаковую пропускную способность.
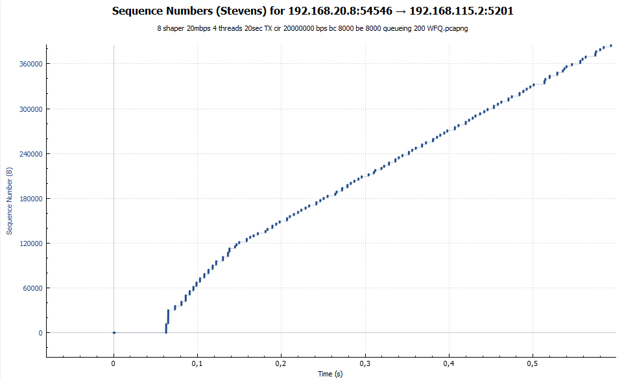
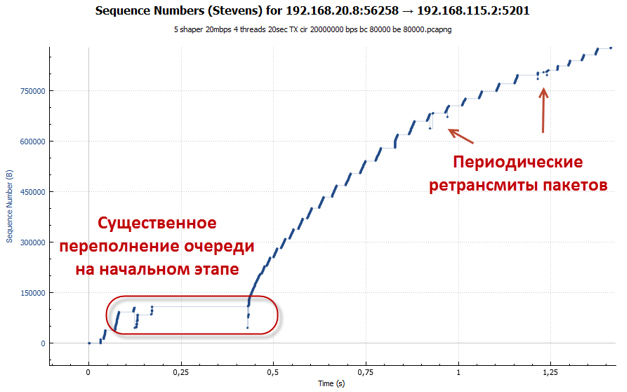
Начнём c графиков, на которых отображаются пакеты с привязкой ко времени их передачи. Первый график – policer’а, второй – shaper’а.
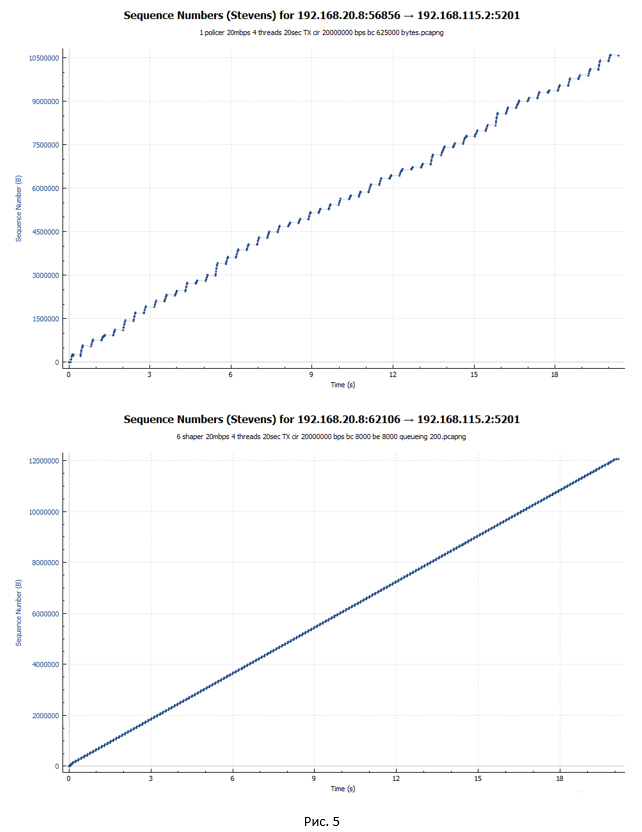
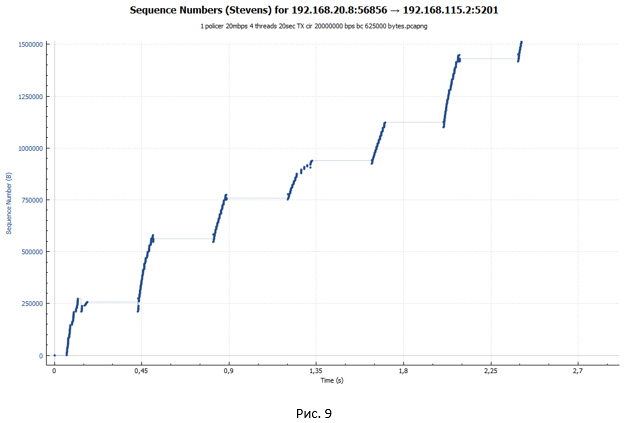
Из графиков видно, что пакеты в случае shaper передаются более равномерно по времени. При этом в случае policer видны скачкообразные разгоны сессии и периоды пауз.
Анализ TCP сессии при работе policer
Посмотрим поближе на сессию TCP. Будем рассматривать случай policer’а.
Протокол TCP в своей работе опирается на достаточно большой набор алгоритмов. Среди них для нас наиболее интересными являются алгоритмы, отвечающие за управление перегрузками (congestion control). Именно они отвечают за скорость передачи данных в рамках сессии. ПК, на котором запускался iPerf, работает под управлением Windows 10. В Windows 10 в качестве такого алгоритма используется Compound TCP (CTCP). CTCP в своей работе позаимствовал достаточно многое из алгоритма TCP Reno. Поэтому при анализе TCP сессии достаточно удобно посматривать на картинку с состояниями сессии при работе алгоритма TCP Reno.
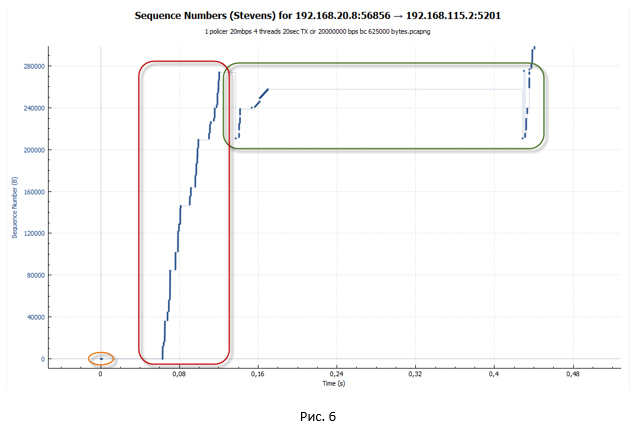
На следующей картинке представлен начальный сегмент передачи данных.
-
На первом этапе у нас устанавливается TCP сессия (происходит тройное рукопожатие).
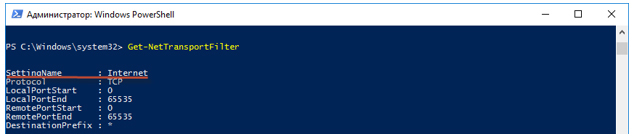
Чтобы посмотреть параметры TCP, можно воспользоваться PowerShell.
Смотрим, какой глобальный шаблон TCP используется в нашей системе по умолчанию.
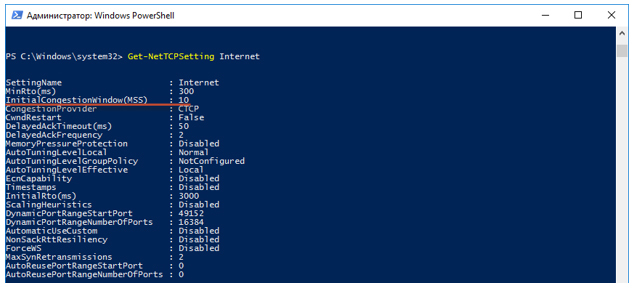
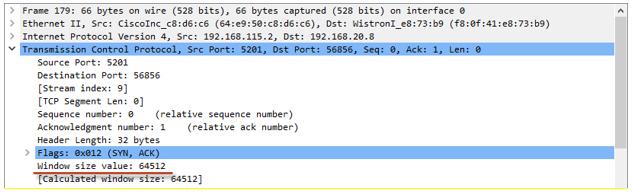
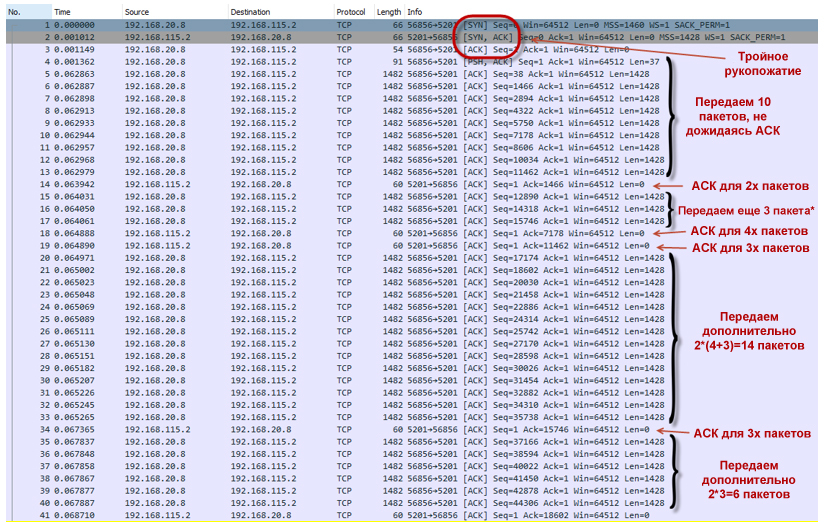
В режиме TCP slow-start размер окна (cwnd) увеличивается каждый раз при получении ACK. При этом оно не может превысить значение awnd. За счёт такого поведения, мы имеем практически экспоненциальный рост количества передаваемых пакетов. Наша TCP сессия разгоняется достаточно агрессивно.
- ПК устанавливает TCP-соединение (№1-3).
- Отправляет 10 пакетов (№4-13), не дожидаясь подтверждения (ACK), так как cwnd=10*MSS.
- Получает ACK (№14), который подтверждает сразу два пакета (№4-5).
- Увеличивает размер окна Cwnd=(10+2)*MSS=12*MSS.
- Отправляет дополнительно три пакета (№15-17). По идее ПК должен был отправить четыре пакета: два, так как он получил подтверждение на два пакета, которые были переданы ранее; плюс два пакета из-за увеличения окна. Но в реальности на самом первом этапе система шлёт (2N-1) пакетов. Найти ответ на этот вопрос мне не удалось. Если кто-то подскажет, буду благодарен.
- Получает два ACK (№18-19). Первое ACK подтверждает получение удалённой стороной четырёх пакетов (№6-9). Второе — трёх (№10-12).
- Увеличивает размер окна Cwnd=(12+7)*MSS=19*MSS.
- Отправляет 14 пакетов (№20-33): семь новых пакетов, так как получили ACK на семь ранее переданных пакетов, и ещё семь новых пакетов, так как увеличилось окно.
- И так далее.
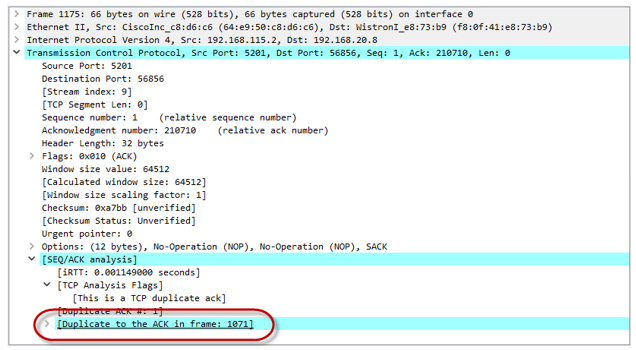
После получения трёх Dup ACK наша TCP сессия переходит в фазу восстановления после потери (loss recovery, включающую алгоритмы Fast Retransmit/Fast Recovery). Отправитель устанавливает новое значение ssthresh = cwnd/2 (32K) и делает окно cwnd = ssthresh+3*MSS.
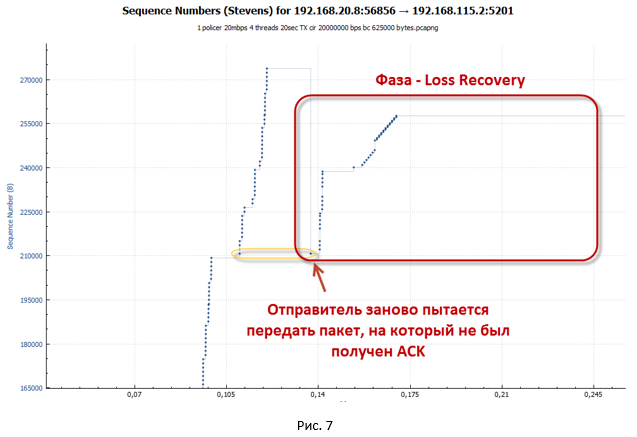
Как только было отправлено количество пакетов, укладывающихся в окно cwnd, система останавливается. Для продолжения передачи данных ей нужны новые ACK (не Dup ACK). Но ACK не приходят. Все повторные пакеты отбрасываются policer’ом, так в ведре закончились токены, а времени, чтобы их восполнить, прошло слишком мало.
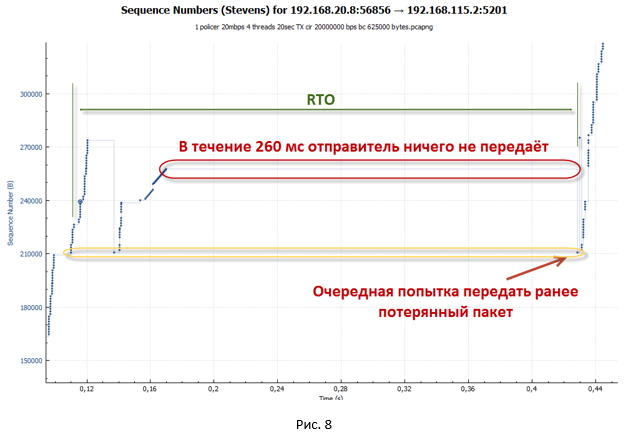
В алгоритме Compound TCP для регулирования скорости передачи используется окно отправителя (sending window — wnd), которое зависит от двух взвешенных величин: окна перегрузки (cwnd) и окна задержки (delay window — dwnd). Cwnd, как и раньше, зависит от полученных ACK, dwnd зависит от величины задержки RTT (round trip time). Окно wnd растёт только один раз за период времени RTT. Как мы помним, в случае slow-start окно cwnd росло при получении каждого ACK. Поэтому в режиме congestion avoidance сессия разгоняется не так быстро.
Анализ TCP сессии при работе shaper
Теперь давайте посмотрим поближе на сегмент передачи данных для случая shaper. Для наглядности возьмём аналогичный масштаб, как и для графика policer на Рис.6.
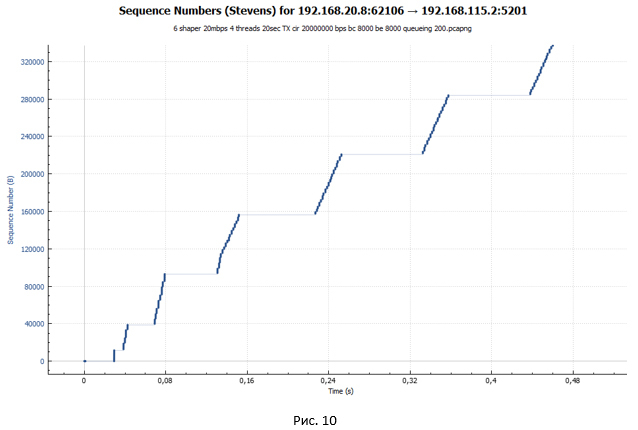
Из графика мы видим всё ту же лесенку. Но размер ступенек стал существенно меньше. Однако если приглядеться к графику на Рис. 10, мы не увидим небольших «волн» на конце каждой ступеньки, как это было на Рис. 9. Такие «волны» были следствием потери пакетов и попыток их передачи заново.
Рассмотрим начальный сегмент передачи данных для случая shaper.
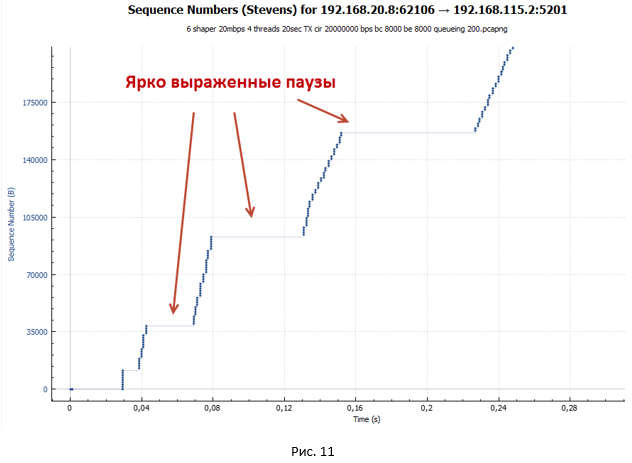
Происходит установление сессии. Далее начинается разгон в режиме TCP slow-start. Но этот разгон более пологий и имеет ярко выраженные паузы, которые увеличиваются в размере. Более пологий разгон обусловлен тем, что размер ведра по умолчанию для shaper всего (BC+BE) = 20 000 байт. В то время как для policer размер ведра — 625 000 байт. Поэтому shaper срабатывает существенно раньше. Пакеты начинают попадать в очередь. Растёт задержка от отправителя к получателю, и ACK приходят позже, чем это было в случае policer. Окно растёт существенно медленнее. Получается, что чем больше система передаёт пакетов, тем больше их накапливается в очереди, а значит, тем больше задержка в получении ACK. Имеем процесс саморегуляции.
Через некоторое время окно cwnd достигает значения awnd. Но к этому моменту у нас накапливается достаточно ощутимая задержка из-за наличия очереди. В конечном итоге при достижении определённого значения RTT наступает равновесное состояние, когда скорость сессии больше не меняется и достигает максимального значения для данного RTT. В моём примере среднее RTT равно 107 мс, awnd=64512 байт, следовательно, максимальная скорость сессии будет соответствовать awnd/RTT= 4.82 Мбит/с. Примерно такое значение нам и выдал iPerf при измерениях.
Но откуда берутся ярко выраженные паузы в передаче? Давайте посмотрим на график передачи пакетов через устройство с shaper в случае, если у нас всего одна TCP сессия (Рис.12). Напомню, что в нашем эксперименте передача данных происходит в рамках четырёх TCP сессий.
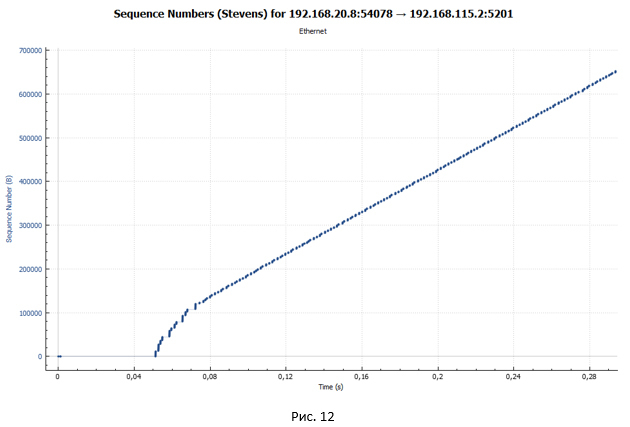
На этом графике очень хорошо видно, что нет никаких пауз. Из этого можно сделать вывод, что паузы на Рис.10 и 11 обусловлены тем, что у нас одновременно передаётся четыре потока, а очередь в shaper одна (тип очереди FIFO).
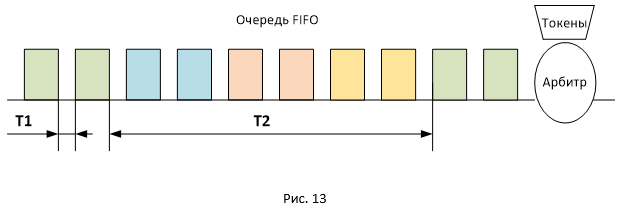
На Рис.13 представлено расположение пакетов разных сессий в очереди FIFO. Так как пакеты передаются пачками, они будут располагаться в очереди таким же образом. В связи с этим задержка между поступлением пакетов на приёмной стороне будет двух типов: T1 и T2 (где T2 существенно превосходит T1). Общее значение RTT для всех пакетов будет одинаковым, но пакеты будут приходить пачками, разнесёнными по времени на значение T2. Вот и получаются паузы, так как в момент времени T2 никакие ACK к отправителю не приходят, при этом окно сессии остаётся неизменным (имеет максимальное значение равное awnd).
Логично предположить, что, если заменить одну общую очередь FIFO на несколько для каждой сессии, никаких ярко выраженных пауз не будет. Для такой задачи нам подойдёт, например, очередь типа Weighted Fair Queuing (WFQ). В ней для каждой сессии создаётся своя очередь пакетов.
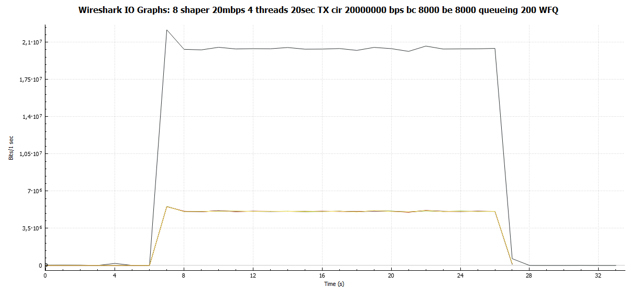
Из общего графика мы сразу видим, что графики всех четырёх TCP сессий идентичны. Т.е. все они получили одинаковую пропускную способность.
А вот и наш график распределения пакетов по времени передачи ровно в том же масштабе, что и на Рис. 11. Никаких пауз нет.
Стоит отметить, что очередь типа WFQ позволит нам получить не только более равномерное распределение пропускной способности, но и предотвратить «забивание» одного типа трафика другим. Мы всё время говорили про TCP, но в сети также присутствует и UDP трафик. UDP не имеет механизмов подстройки скорости передачи (flow control, congestion control). Из-за этого UDP трафик может с лёгкостью забить нашу общую очередь FIFO в shaper’е, что драматически повлияет на передачу TCP. Напомню, что, когда очередь FIFO полностью заполнена пакетами, по умолчанию начинает работать механизм tail-drop, при котором отбрасываются все вновь пришедшие пакеты. Если у нас настроена очередь WFQ, каждая сессия пережидает момент буферизации в своей очереди, а значит, сессии TCP будут отделены от сессий UDP.
Самый главный вывод, который можно сделать после анализов графиков передачи пакетов при работе shaper’а – у нас нет потерянных пакетов. Из-за увеличения RTT скорость сессии адаптируется к скорости shaper’а.
Конечно! Изначально (если кто-то об этом ещё помнит) мы изменили глубину очереди с 83 (значение по умолчанию) на 200 пакетов. Сделали мы это для того, чтобы очереди хватило для получения достаточного значения RTT, при котором суммарная скорость сессий становиться примерно равна 20 Мбит/с. А значит, пакеты «не вываливаются» из очереди shaper’а.
При глубине в 83 пакета очередь переполняется быстрее, нежели достигается нужное значение RTT. Пакеты отбрасываются. Особенно ярко это проявляется на начальном этапе, когда у нас работает механизм TCP slow-start (сессия разгоняется максимально агрессивно). Стоит отметить, что количество отброшенных пакетов несравнимо меньше, чем в случае с policer, так как увеличение RTT приводит к тому, что скорость сессии растёт более плавно. Как мы помним, в алгоритме CTCP размер окна в том числе зависит от значения RTT.
Графики утилизации пропускной способности и задержки при работе policer и shaper
В заключение нашего небольшого исследования построим ещё несколько общих графиков, после чего перейдём к анализу полученных данных.
График утилизации пропускной способности:
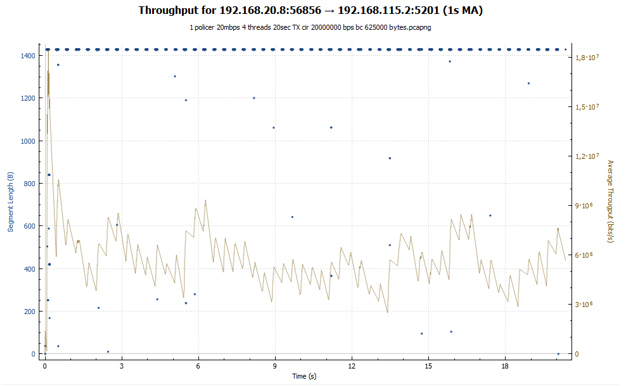
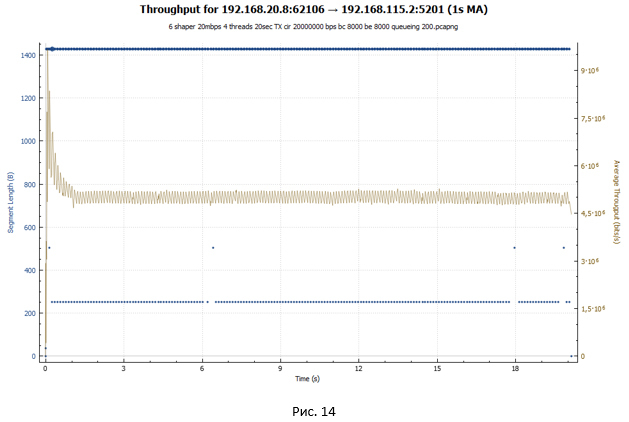
В случае policer мы видим скачкообразный график: сессия разгоняется, потом наступают потери, и её скорость падает. После чего всё повторяется снова. В случае shaper наша сессия получает примерно одинаковую пропускную способность на протяжении всей передачи. Скорость сессии регулируется за счёт увеличения значения RTT. На обоих графиках вначале можно наблюдать взрывной рост. Он обусловлен тем, что наши вёдра изначально полностью заполнены токенами и TCP-сессия, ничем не сдерживаемая, разгоняется до относительно больших значений (в случае shaper это значение в 2 раза меньше).
График задержки RTT для policer и shaper (по-хорошему, это первое о чём мы вспоминаем, когда говорим про shaper):
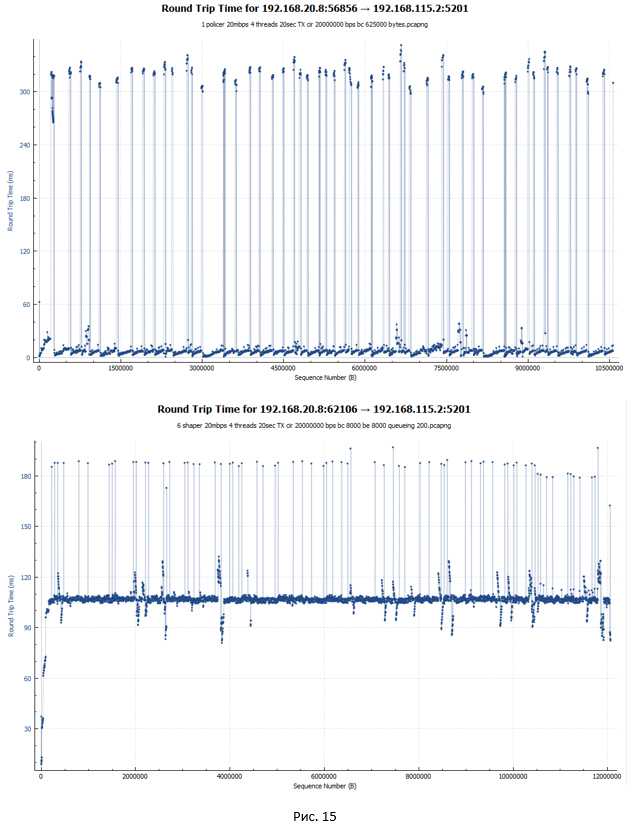
В случае policer (первый график) задержка RTT для большинства пакетов минимальна, порядка 5 мс. На графике также присутствуют существенные скачки (до 340 мс). Это как раз моменты, когда пакеты отбрасывались и передавались заново. Тут стоит отметить, как Wireshark считает RTT для TCP трафика. RTT – это время между отправкой оригинального пакета и получением на него ACK. В связи с этим, если оригинальный пакет был потерян и система передавала пакет повторно, значение RTT растёт, так как точкой отсчёта является в любом случае момент отправки оригинального пакета.
В случае shaper задержка RTT для большинства пакетов составила 107 мс, так как они все задерживаются в очереди. Есть пики до 190 мс.
Выводы
Итак, какие итоговые выводы можно сделать. Кто-то может заметить, что это и так понятно. Но наша цель была копнуть чуточку глубже. Напомню, что в эксперименте анализировалось поведение TCP-сессий.
-
Shaper предоставляет нам на 13% больше полезной пропускной способности, чем policer (19.3 против 17.1 Мбит/с) при заданном ограничении в 20 Мбит/с.
Если policer настроен ближе к получателю, наша сеть фактически занимается прокачкой бесполезного трафика, который будет в итоге отброшен policer’ом. Например, в разрезе глобальной сети интернет это может является проблемой, так как трафик режется зачастую ближе к получателю.
Вообще наличие очереди может достаточно негативно сказываться на работе приложений – так называемый эффект излишней сетевой буферизации (Bufferbloat). Поэтому с глубиной очереди надо быть аккуратными.
В этом году при поддержке Google было проведено исследование, в котором анализировался негативный эффект работы policer’а в сети интернет. Было определено, что от 2% до 7% потерь видео трафика по всему Миру вызвано срабатыванием policer’а. Потери пакетов при непосредственной работе policer’а составили порядка 21%, что в 6 раз больше, чем для трафика, который не подвержен срабатыванию данной технологии. Качество видео трафика, который подвергся обработке policer’ом, хуже, чем в случае, если policer не срабатывал.
Для борьбы с негативным эффектом работы policer’а предлагаются следующие меры в зависимости от точки их применения.
- В policer’е уменьшить размер ведра (burst size). Это приведёт к тому, что TCP сессия не сможет слишком сильно разогнаться, пока есть свободные токены, и быстрее начнёт адаптацию под реальную пропускную способность.
- Вместо policer’а использовать shaper (с небольшой глубиной очереди).
- Использовать и shaper, и policer одновременно. В этом случае shaper располагается чуть раньше, чем policer. Shaper задерживает пакеты, сглаживая колебания. Из-за такой задержки policer успевает аккумулировать достаточное количество токенов, чтобы передавать трафик. Потери в таком случае минимизируются.
Для контент-провайдеров предлагается ограничивать скорость отправки трафика на сервере, чтобы избегать включения policer’а. Но на практике оценить реальную скорость канала не всегда просто. Второй метод — избегать взрывной передачи трафика за счёт модификации алгоритмов TCP: использовать TCP Pacing (отправлять пакеты с привязкой к RTT, а не к моменту получения ACK) и изменить схему работы фазы loss recovery (на каждый полученный ACK слать только один новый пакет).