Юникод
Юникод является стандартом кодировки символов по всему миру. Система использует Юникод исключительно для обработки символов и строк. Подробное описание всех аспектов Юникода см. в разделе «Стандарт Юникода».
По сравнению с более старыми механизмами обработки символьных и строковых данных Юникод упрощает локализацию программного обеспечения и улучшает многоязычную обработку текста. С помощью Юникода для представления символьных и строковых данных в приложениях можно включить универсальные возможности обмена данными для глобального маркетинга, используя один двоичный файл для каждого возможного символьного кода. Юникод выполняет следующие действия:
- Позволяет использовать любое сочетание символов, нарисованных из любого сочетания скриптов и языков, в одном документе.
- Определяет семантику для каждого символа.
- Стандартизирует поведение скрипта.
- Предоставляет стандартный алгоритм для двунаправленного текста.
- Определяет перекрестные сопоставления с другими стандартами.
- Определяет несколько кодировок одного набора символов: UTF-7, UTF-8, UTF-16 и UTF-32. Преобразование данных из этих кодировок без потерь.
Юникод поддерживает множество скриптов, используемых языками по всему миру, а также большое количество технических символов и специальных символов, используемых при публикации. Поддерживаемые сценарии включают в себя, но не ограничиваются латиницами, греческими, кириллицами, ивритом, арабским, Деванагари, тайским, Хань, Хангулом, Хирагана и Катаканой. Поддерживаемые языки включают, но не ограничиваются, немецкий, французский, английский, греческий, русский, иврит, арабский, хинди, тайский, китайский, корейский и японский. Юникод в настоящее время может представлять подавляющее большинство символов в современном компьютере, используемых по всему миру, и продолжает обновляться, чтобы сделать его еще более полным.
Функции с поддержкой Юникода описаны в соглашениях о прототипах функций. Эти функции используют кодировку UTF-16 (расширенный символ), которая является наиболее распространенной кодировкой Юникода и используется для собственной кодировки Юникода в Windows операционных системах. Каждое значение кода является 16 битами в ширину, в отличие от более старого подхода к кодовой странице к символьным и строковым данным, в котором используются 8-разрядные значения кода. Использование 16 бит позволяет напрямую кодирование 65 536 символов. На самом деле, вселенная символов, используемых для транскрибирования человеческих языков, даже больше, чем это, и кодовые точки U+D800 в диапазоне от U+D800 до U+DFFF используются для формирования суррогатных пар, которые составляют 32-разрядные кодировки дополнительных символов. Дополнительные сведения см. в разделе суррогатов и дополнительных символов .
Набор символов Юникода включает множество объединяющих символов, таких как U+0308 (» ); сочетание dieresis или umlaut. Юникод часто может представлять один и тот же глиф в форме «‘composed» или «‘decomposed»: например, составная форма «Ä» — это единая кодовая точка Юникода «Ä» (U+00C4), а ее разложенная форма — «A» + «ъ» (U+0041 U+0308). Юникод не определяет составную форму для каждого глифа. Например, вьетнамский нижний регистр «o» с обходом и тильдой («ỗ») представлен U+006f U+0302 U+0303 (o + Circumflex + Tilde). Дополнительные сведения о сочетании символов и связанных проблем см. в разделе «Использование нормализации Юникода для представления строк».
Для совместимости с 8-разрядными и 7-разрядными средами Юникод также можно закодировать как UTF-8 и UTF-7 соответственно. Хотя функции с поддержкой Юникода в Windows используют UTF-16, можно также работать с данными, закодированными в кодировке UTF-8 или UTF-7, которые поддерживаются в Windows как кодовые страницы многобайтового набора символов.
Новые приложения Windows должны использовать UTF-16 в качестве внутреннего представления данных. Windows также обеспечивает расширенную поддержку кодовой страницы, а смешанное использование в одном приложении возможно. Даже новые приложения на основе Юникода иногда должны работать с кодовыми страницами. Причины этого рассматриваются в code Pages.
Приложение может использовать функции MultiByteToWideChar и WideCharToMultiByte для преобразования строк на основе кодовых страниц и строк Юникода. Хотя их имена относятся к «MultiByte», эти функции работают одинаково хорошо с однобайтовой кодировкой (SBCS), двухбайтовой кодировкой (DBCS) и многобайтовой кодировкой (MBCS).
Как правило, приложение Windows должно использовать UTF-16 внутри системы, преобразуя только как часть «тонкого слоя» через интерфейс, который должен использовать другой формат. Этот метод защищает от потери и повреждения данных. Каждая кодовая страница поддерживает разные символы, но ни один из них не поддерживает полный спектр символов, предоставляемых Юникодом. Большинство кодовых страниц поддерживают разные подмножества, которые кодируются по-разному. Кодовые страницы для UTF-8 и UTF-7 являются исключением, так как они поддерживают полный набор символов Юникода, а преобразование между этими кодировками и UTF-16 без потерь.
Данные, преобразованные непосредственно из кодировки, используемой одной кодовой страницей в кодировку, используемую другой, могут быть повреждены, так как одно и то же значение данных на разных кодовой странице может закодировать другой символ. Даже если приложение преобразуется как можно ближе к интерфейсу, следует тщательно подумать о диапазоне данных для обработки.
Данные, преобразованные из Юникода в кодовую страницу, подвергаются потере данных, так как данная кодовая страница может не представлять каждый символ, используемый в конкретных данных Юникода. Поэтому обратите внимание, что WideCharToMultiByte может потерять некоторые данные, если целевая кодовая страница не может представлять все символы в строке Юникода.
При модернизации устаревших приложений на основе кодовой страницы для использования Юникода можно использовать универсальные функции и макрос TEXT для поддержки единого набора источников, из которых компилируются две версии приложения. Одна версия поддерживает Юникод, а другая — с Windows кодовыми страницами. С помощью этого механизма можно преобразовать даже очень большие приложения из Windows кодовых страниц в Юникод, сохраняя источники приложений, которые можно компилировать, создавать и тестировать на всех этапах преобразования. Дополнительные сведения см. в соглашениях по прототипам функций.
Символы и строки Юникода используют типы данных, отличные от типов символов и строк на основе кодовой страницы. Наряду с рядом макросов и соглашений об именовании это различие сводит к минимуму вероятность случайного смешивания двух типов символьных данных. Это упрощает проверку типа компилятора, чтобы гарантировать использование только значений параметров Юникода с функциями, ожидающими строки Юникода.
Юникод: необходимый практический минимум для каждого разработчика
Юникод — это очень большой и сложный мир, ведь стандарт позволяет ни много ни мало представлять и работать в компьютере со всеми основными письменностями мира. Некоторые системы письма существуют уже более тысячи лет, причём многие из них развивались почти независимо друг от друга в разных уголках мира. Люди так много всего придумали и оно зачастую настолько непохоже друг на друга, что объединить всё это в единый стандарт было крайне непростой и амбициозной задачей.
Чтобы по-настоящему разобраться с Юникодом нужно хотя бы поверхностно представлять себе особенности всех письменностей, с которыми позволяет работать стандарт. Но так ли это нужно каждому разработчику? Мы скажем, что нет. Для использования Юникода в большинстве повседневных задач, достаточно владеть разумным минимумом сведений, а дальше углубляться в стандарт по мере необходимости.
В статье мы расскажем об основных принципах Юникода и осветим те важные практические вопросы, с которыми разработчики непременно столкнутся в своей повседневной работе.
Зачем понадобился Юникод?
До появления Юникода, почти повсеместно использовались однобайтные кодировки, в которых граница между самими символами, их представлением в памяти компьютера и отображением на экране была довольно условной. Если вы работали с тем или иным национальным языком, то в вашей системе были установлены соответствующие шрифты-кодировки, которые позволяли отрисовывать байты с диска на экране таким образом, чтобы они представляли смысл для пользователя.
Если вы распечатывали на принтере текстовый файл и на бумажной странице видели набор непонятных кракозябр, это означало, что в печатающее устройство не загружены соответствующие шрифты и оно интерпретирует байты не так, как вам бы этого хотелось.
У такого подхода в целом и однобайтовых кодировок в частности был ряд существенных недостатков:
- Можно было одновременно работать лишь с 256 символами, причём первые 128 были зарезервированы под латинские и управляющие символы, а во второй половине кроме символов национального алфавита нужно было найти место для символов псевдографики (╔ ╗).
- Шрифты были привязаны к конкретной кодировке.
- Каждая кодировка представляла свой набор символов и конвертация из одной в другую была возможна только с частичными потерями, когда отсутствующие символы заменялись на графически похожие.
- Перенос файлов между устройствами под управлением разных операционных систем был затруднителен. Нужно было либо иметь программу-конвертер, либо таскать вместе с файлом дополнительные шрифты. Существование Интернета каким мы его знаем было невозможным.
- В мире существуют неалфавитные системы письма (иероглифическая письменность), которые в однобайтной кодировке непредставимы в принципе.
Основные принципы Юникода
Все мы прекрасно понимаем, что компьютер ни о каких идеальных сущностях знать не знает, а оперирует битами и байтами. Но компьютерные системы пока создают люди, а не машины, и для нас с вами иногда бывает удобнее оперировать умозрительными концепциями, а затем уже переходить от абстрактного к конкретному.
Важно! Одним из центральных принципов в философии Юникода является чёткое разграничение между символами, их представлением в компьютере и их отображением на устройстве вывода.
Вводится понятие абстрактного юникод-символа, существующего исключительно в виде умозрительной концепции и договорённости между людьми, закреплённой стандартом. Каждому юникод-символу поставлено в соответствие неотрицательное целое число, именуемое его кодовой позицией (code point).
Так, например, юникод-символ U+041F — это заглавная кириллическая буква П. Существует несколько возможностей представления данного символа в памяти компьютера, ровно как и несколько тысяч способов отображения его на экране монитора. Но при этом П, оно и в Африке будет П или U+041F.
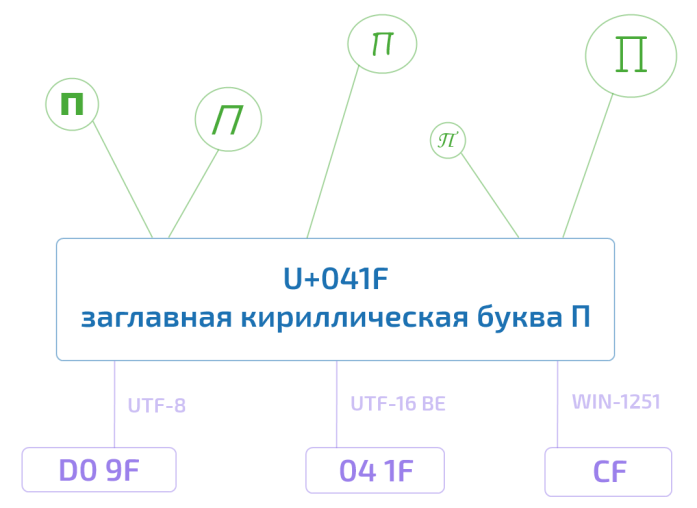
Это хорошо нам знакомая инкапсуляция или отделение интерфейса от реализации — концепция, отлично зарекомендовавшая себя в программировании.
Получается, что руководствуясь стандартом, любой текст можно закодировать в виде последовательности юникод-символов
записать на листочке, упаковать в конверт и переслать в любой конец Земли. Если там знают о существовании Юникода, то текст будет воспринят ими ровно так же, как и нами с вами. У них не будет ни малейших сомнений, что предпоследний символ — это именно кириллическая строчная е (U+0435), а не скажем латинская маленькая e (U+0065). Обратите внимание, что мы ни слова не сказали о байтовом представлении.
Хотя юникод-символы и называются символами, они далеко не всегда соответствуют символу в традиционно-наивном понимании, например букве, цифре, пунктуационному знаку или иероглифу. (Подробнее смотри под спойлером.)
- U+0000: нулевой символ;
- U+D800–U+DFFF: младшие и старшие суррогаты для технического представления кодовых позиций в диапазоне от 10000 до 10FFFF (читай: за пределами БМЯП/BMP) в семействе кодировок UTF-16;
- и т.д.
- U+0020 (пробел);
- U+00A0 (неразрывный пробел, в HTML);
- U+2002 (полукруглая шпация или En Space);
- U+2003 (круглая шпация или Em Space);
- и т.д.
- U+0300 и U+0301: знаки основного (острого) и второстепенного (слабого) ударений;
- U+0306: кратка (надстрочная дуга), как в й;
- U+0303: надстрочная тильда;
- и т.д.
Что такое символ, чем отличается графемный кластер (читай: воспринимаемое как единое целое изображение символа) от юникод-символа и от кодового кванта мы расскажем в следующий раз.
Кодовое пространство Юникода
Кодовое пространство Юникода состоит из 1 114 112 кодовых позиций в диапазоне от 0 до 10FFFF. Из них к девятой версии стандарта значения присвоены лишь 128 237. Часть пространства зарезервирована для частного использования и консорциум Юникода обещает никогда не присваивать значения позициям из этих специальный областей.
Ради удобства всё пространство поделено на 17 плоскостей (сейчас задействовано шесть их них). До недавнего времени было принято говорить, что скорее всего вам придётся столкнуться только с базовой многоязыковой плоскостью (Basic Multilingual Plane, BMP), включающей в себя юникод-символы от U+0000 до U+FFFF. (Забегая немного вперёд: символы из BMP представляются в UTF-16 двумя байтами, а не четырьмя). В 2016 году этот тезис уже вызывает сомнения. Так, например, популярные символы Эмодзи вполне могут встретиться в пользовательском сообщении и нужно уметь их корректно обрабатывать.
Кодировки
Если мы хотим переслать текст через Интернет, то нам потребуется закодировать последовательность юникод-символов в виде последовательности байтов.
Стандарт Юникода включает в себя описание ряда юникод-кодировок, например UTF-8 и UTF-16BE/UTF-16LE, которые позволяют кодировать всё пространство кодовых позиций. Конвертация между этими кодировками может свободно осуществляться без потерь информации.
Также никто не отменял однобайтные кодировки, но они позволяют закодировать свой индивидуальный и очень узкий кусочек юникод-спектра — 256 или менее кодовых позиций. Для таких кодировок существуют и доступны всем желающим таблицы, где каждому значению единственного байта сопоставлен юникод-символ (см. например CP1251.TXT). Несмотря на ограничения, однобайтные кодировки оказываются весьма практичными, если речь идёт о работе с большим массивом моноязыковой текстовой информации.
Из юникод-кодировок самой распространённой в Интернете является UTF-8 (она завоевала пальму первенства в 2008 году), главным образом благодаря её экономичности и прозрачной совместимости с семибитной ASCII. Латинские и служебные символы, основные знаки препинания и цифры — т.е. все символы семибитной ASCII — кодируются в UTF-8 одним байтом, тем же, что и в ASCII. Символы многих основных письменностей, не считая некоторых более редких иероглифических знаков, представлены в ней двумя или тремя байтами. Самая большая из определённых стандартом кодовых позиций — 10FFFF — кодируется четырьмя байтами.
Обратите внимание, что UTF-8 — это кодировка с переменной длиной кода. Каждый юникод-символ в ней представляется последовательностью кодовых квантов с минимальной длиной в один квант. Число 8 означает битовую длину кодового кванта (code unit) — 8 бит. Для семейства кодировок UTF-16 размер кодового кванта составляет, соответственно, 16 бит. Для UTF-32 — 32 бита.
Для хранения строковой информации в приложениях часто используются 16-битные юникод-кодировки в силу их простоты, а так же того факта, что символы основных мировых систем письма кодируются одним шестнадцатибитовым квантом. Так, например, Java для внутреннего представления строк успешно применяет UTF-16. Операционная система Windows внутри себя также использует UTF-16.
В любом случае, пока мы остаёмся в пространстве Юникода, не так уж и важно, как хранится строковая информация в рамках отдельного приложения. Если внутренний формат хранения позволяет корректно кодировать все миллион с лишним кодовых позиций и на границе приложения, например при чтении из файла или копировании в буфер обмена, не происходит потерь информации, то всё хорошо.
Для корректной интерпретации текста, прочитанного с диска или из сетевого сокета, необходимо сначала определить его кодировку. Это делается либо с использованием метаинформации, предоставленной пользователем, записанной в тексте или рядом с ним, либо определяется эвристически.
В сухом остатке
Информации много и имеет смысл привести краткую выжимку всего, что было написано выше:
- Юникод постулирует чёткое разграничение между символами, их представлением в компьютере и их отображением на устройстве вывода.
- Юникод-символы не всегда соответствуют символу в традиционно-наивном понимании, например букве, цифре, пунктуационному знаку или иероглифу.
- Кодовое пространство Юникода состоит из 1 114 112 кодовых позиций в диапазоне от 0 до 10FFFF.
- Базовая многоязыковая плоскость включает в себя юникод-символы от U+0000 до U+FFFF, которые кодируются в UTF-16 двумя байтами.
- Любая юникод-кодировка позволяет закодировать всё пространство кодовых позиций Юникода и конвертация между различными такими кодировками осуществляется без потерь информации.
- Однобайтные кодировки позволяют закодировать лишь небольшую часть юникод-спектра, но могут оказаться полезными при работе с большим объёмом моноязыковой информации.
- Кодировки UTF-8 и UTF-16 обладают переменной длиной кода. В UTF-8 каждый юникод-символ может быть закодирован одним, двумя, тремя или четырьмя байтами. В UTF-16 — двумя или четырьмя байтами.
- Внутренний формат хранения текстовой информации в рамках отдельного приложения может быть произвольным при условии корректной работы со всем пространством кодовых позиций Юникода и отсутствии потерь при трансграничной передаче данных.
Краткое замечание про кодирование
С термином кодирование может произойти некоторая путаница. В рамках Юникода кодирование происходит дважды. Первый раз кодируется набор символов Юникода (character set), в том смысле, что каждому юникод-символу ставится с соответствие кодовая позиция. В рамках этого процесса набор символов Юникода превращается в кодированный набор символов (coded character set). Второй раз последовательность юникод-символов преобразуется в строку байтов и этот процесс также называется кодирование.
В англоязычной терминологии существуют два разных глагола to code и to encode, но даже носители языка зачастую в них путаются. К тому же термин набор символов (character set или charset) используется в качестве синонима к термину кодированный набор символов (coded character set).
Всё это мы говорим к тому, что имеет смысл обращать внимание на контекст и различать ситуации, когда речь идёт о кодовой позиции абстрактного юникод-символа и когда речь идёт о его байтовом представлении.
Что такое Юникод?
Юникод (Unicode), это многоязычный, основанный на ASCII стандарт кодирования символов, а также, связанное с ним, семейство многобайтных кодировок. Если некоторые слова из предыдущего предложения вам не понятны, давайте рассмотрим их подробнее.
Что такое кодировка
Современные компьютеры всё ещё достаточно глупые и, в большинстве своём, не умеют работать ни с чем, кроме чисел. Мы рассматриваем на своих мониторах фотографии, смотрим фильмы, играем в игры. Но для компьютеров всё это лишь безликий поток нулей и единичек. Так же и текст — для компьютера это просто набор байтов. Буквы и любые другие символы представляются в машинной памяти, как числа.
Поэтому программистам при работе с текстом приходится делать подобные соглашения: «А давайте каждому символу будет соответствовать один байт. Причём, если в байте будет число 43, то будем считать, что это цифра ноль. А если число 66, то пусть это будет заглавная латинская буква B».
Подобный список всех используемых символов и соответствующих им чисел и называется кодировкой. Вы, скорее всего, уже слышали названия многих кодировок: Windows-1251, KOI-8, ну и, конечно, Unicode.
Крякозябры
Наверное, часто бывала ситуация, когда вы открываете страницу в браузере, а там вместо текста какая-то мешанина из чудных символов. Или просто сплошные вопросительные знаки. Или вы пишете любовное письмо своей девушке, а она звонит вам и говорит «что за нечитаемый бред ты мне прислал? Я обиделась».
Это всё из-за того, что в мире наплодилось слишком много разных кодировок. И текст в одной из них выглядит совершенно не так, как в другой. Дело в том, что компьютер не знает какую кодировку вы используете для текста. Для него это просто последовательность каких-то чисел.
Например, ваш текстовый редактор настроен на кодировку Windows-1251. И вы пишете «Здравствуйте, дорогая Маша!». Вы нажимаете первую букву и программа думает: «ага, русская заглавная буква Зэ — код 199». И записывает число 199 в файл. Маша получает ваше письмо, но в её почтовом клиенте стоит кодировка KOI8-R (потому что Маша любит старый Unix). А в этой кодировке числу 199 соответствует строчная буква «г». И Маша читает: «гДПЮБЯРБСИРЕ, ДНПНЦЮЪ лЮЬЮ!». Маша обиделась!
Чтобы подобного не происходило, нужно каким-то образом указывать кодировку в которой набран текст. Например, в HTML это делается с помощью тега:
ASCII
В определённый момент времени распространение получила кодировка ASCII (American Standard Code for Information Interchange). В ней определены 128 символов с кодами от 0 до 127. Сюда включён латинский алфавит, цифры и основные знаки препинания (
Практически все современные кодировки, использующиеся на персональных компьютерах являются ASCII-совместимыми. То есть первые 128 символов у них кодируются одинаково, а различия начинаются с кода 128 и выше. Вышеупомянутые Windows-1251 и KOI8-r также основаны на ASCII и если бы письмо начиналось бы с «Hello, my dear Maria!», то недопонимания не возникло бы.
Основан на ASCII и Юникод.
Однобайтные кодировки
Одна из причин, по которой появилось такое большое количество кодировок, это то, что вначале каждая компания придумывала свои стандарты, не обращая внимания на другие. Вторая причина заключается в том, что старые кодировки были однобайтными. То есть каждому символу в тексте соответствует один байт в памяти компьютера.
Однобайтные кодировки всем хороши: они компактны, с ними легко работать (нужно достать пятый символ — просто берём пятый байт от начала). Единственная проблема: в них помещается мало символов. Ровно столько, сколько значений может принимать один байт, то есть обычно, это 256. Например, в Windows-1251 мы отдали 128 символов под ASCII, добавили 66 букв русского алфавита (строчные и заглавные), несколько знаков препинания и вот у нас уже остаётся не так много свободных позиций. Даже на псевдографику не хватает.
То есть свести в одну кодировку все возможные символы даже европейских алфавитов достаточно сложно. А уж для китайцев с их тысячами иероглифов вообще всё тоскливо. А о всяких смайликах, эмоджи и иконках самолётиков и думать нечего. Поэтому для кириллицы приходилось изобретать свою кодировку, а для греческого языка другую.
Впрочем, такая ситуация сохранялась достаточно долго. Потому что проблемы англоязычных пользователей и программистов решила ASCII, а до китайских проблем им не было дела. С ростом же глобального интернета вдруг оказалось, что в мире говорят не только на английском языке, поэтому с кодировками нужно что-то менять.
Многобайтные кодировки
Самым простым решением было взять два байта вместо одного. Плюс такого решения: теперь можно в рамках одной кодировки использовать 65 тысяч символов. Минусы тоже есть:
- Для всех возможных символов, иероглифов и смайликов даже 65 тысяч символов мало.
- Текстовые файлы стали занимать вдвое больше места, даже тексты на английском. Слишком расточительно.
- Кодировки перестали быть ASCII-совместимыми и многие программы не могли с ними работать.
Стандарт Unicode
В конечном итоге всё вылилось в стандарт Юникода, который худо-бедно, но решает практически все стоявшие перед кодировками проблемы.
С одной стороны, Юникод позволяет кодировать практически неограниченное количество символов. В последнем стандарте определено более 100 000 различных символов всех современных и многих уже мёртвых языков, а также различные иконки и пиктограммы. С другой стороны, некоторые способы кодирования позволяют Юникоду оставаться ASCII-совместимыми. Что позволяет работать, как и раньше многим программам, а также американским и другим англоязычным пользователям, многие из которых появления Юникода даже не заметили. В Юникоде также собраны все символы из всех популярных стандартов кодирования, что позволяет преобразовать в него любой текст из старой кодировки.
Практически все современные программы, работающие с текстом, понимают Юникод. Более того, обычно они в нём и работают. Например, даже когда вы открываете сайт в старой доброй Windows-1251, браузер сначала внутри у себя перекодирует все тексты в Юникод, а потом отображает их. В общем, Юникод, это светлое будущее интернета и всей компьютерной индустрии.
Отличие набора символов от кодировки
Термины «кодировка», «стандарт кодирования», «набор символов» обычно используются, как синонимы, но между ними есть и тонкие различия. Важно понимать разницу между «стандартом» и, собственно, «кодировкой». Некий стандарт просто говорит, что буква «A», это число 65, а буква «B» — 66. Кодировка же отвечает за то, как эти числа представить в памяти компьютера.
В эпоху однобайтных кодировок, это различие было практически неуловимо. Число 65 — байт со значением 65 или последовательность битов 01000001 . Для многобайтных же уже возникают вопросы: сколько байтов использовать, в каком порядке, фиксированное число байтов или нет?
То есть в стандарте Юникода определено, что кириллической букве «А» соответствует абстрактное число 1040. Как представить это число в виде последовательности байтов решает уже конкретная кодировка — UTF-8, UTF-16, UTF-32.
То есть текстовый файл не может быть в кодировке «Юникод», а только в конкретной кодировке «UTF-8» или «UTF-16».
Кодировки и шрифты
Юникод, как и любая другая кодировка не описывает того, как следует отрисовывать символы. Для него число 1040, это «кириллическая заглавная буква А». А какая она, печатная, прописная, наклонная, жирная или с завитушками, это не его дело.
За изображение символа отвечают шрифты. Поэтому один и тот же символ в разных шрифтах может выглядеть по разному, а то и вообще отсутствовать.
© Таблица символов Юникода, 2012–2022.
Юникод® — это зарегистрированная торговая марка консорциума Юникод в США и других странах. Этот сайт никак не связан с консорциумом Юникод. Официальный сайт Юникода располагается по адресу www.unicode.org.
Мы используем ��cookie, чтобы сделать сайт максимально удобным для вас. Подробнее