Введение в pandas: анализ данных на Python
4 Март 2017 , Python, 595985 просмотров,  Introduction to pandas: data analytics in Python
pandas это высокоуровневая Python библиотека для анализа данных. Почему я её называю высокоуровневой, потому что построена она поверх более низкоуровневой библиотеки NumPy (написана на Си), что является большим плюсом в производительности. В экосистеме Python, pandas является наиболее продвинутой и быстроразвивающейся библиотекой для обработки и анализа данных. В своей работе мне приходится пользоваться ею практически каждый день, поэтому я пишу эту краткую заметку для того, чтобы в будущем ссылаться к ней, если вдруг что-то забуду. Также надеюсь, что читателям блога заметка поможет в решении их собственных задач с помощью pandas, и послужит небольшим введением в возможности этой библиотеки.
DataFrame и Series
Чтобы эффективно работать с pandas, необходимо освоить самые главные структуры данных библиотеки: DataFrame и Series. Без понимания что они из себя представляют, невозможно в дальнейшем проводить качественный анализ.
Series
Структура/объект Series представляет из себя объект, похожий на одномерный массив (питоновский список, например), но отличительной его чертой является наличие ассоциированных меток, т.н. индексов, вдоль каждого элемента из списка. Такая особенность превращает его в ассоциативный массив или словарь в Python.
В строковом представлении объекта Series, индекс находится слева, а сам элемент справа. Если индекс явно не задан, то pandas автоматически создаёт RangeIndex от 0 до N-1, где N общее количество элементов. Также стоит обратить, что у Series есть тип хранимых элементов, в нашем случае это int64, т.к. мы передали целочисленные значения.
У объекта Series есть атрибуты через которые можно получить список элементов и индексы, это values и index соответственно.
Доступ к элементам объекта Series возможны по их индексу (вспоминается аналогия со словарем и доступом по ключу).
Индексы можно задавать явно:
Делать выборку по нескольким индексам и осуществлять групповое присваивание:
Фильтровать Series как душе заблагорассудится, а также применять математические операции и многое другое:
Если Series напоминает нам словарь, где ключом является индекс, а значением сам элемент, то можно сделать так:
У объекта Series и его индекса есть атрибут name, задающий имя объекту и индексу соответственно.
Индекс можно поменять «на лету», присвоив список атрибуту index объекта Series
Имейте в виду, что список с индексами по длине должен совпадать с количеством элементов в Series.
DataFrame
Объект DataFrame лучше всего представлять себе в виде обычной таблицы и это правильно, ведь DataFrame является табличной структурой данных. В любой таблице всегда присутствуют строки и столбцы. Столбцами в объекте DataFrame выступают объекты Series, строки которых являются их непосредственными элементами.
DataFrame проще всего сконструировать на примере питоновского словаря:
Чтобы убедиться, что столбец в DataFrame это Series, извлекаем любой:
Объект DataFrame имеет 2 индекса: по строкам и по столбцам. Если индекс по строкам явно не задан (например, колонка по которой нужно их строить), то pandas задаёт целочисленный индекс RangeIndex от 0 до N-1, где N это количество строк в таблице.
В таблице у нас 4 элемента от 0 до 3.
Доступ по индексу в DataFrame
Индекс по строкам можно задать разными способами, например, при формировании самого объекта DataFrame или «на лету»:
Как видно, индексу было задано имя — Country Code. Отмечу, что объекты Series из DataFrame будут иметь те же индексы, что и объект DataFrame:
Доступ к строкам по индексу возможен несколькими способами:
- .loc — используется для доступа по строковой метке
- .iloc — используется для доступа по числовому значению (начиная от 0)
Можно делать выборку по индексу и интересующим колонкам:
Как можно заметить, .loc в квадратных скобках принимает 2 аргумента: интересующий индекс, в том числе поддерживается слайсинг и колонки.
Фильтровать DataFrame с помощью т.н. булевых массивов:
Кстати, к столбцам можно обращаться, используя атрибут или нотацию словарей Python, т.е. df.population и df[‘population’] это одно и то же.
Сбросить индексы можно вот так:
pandas при операциях над DataFrame, возвращает новый объект DataFrame.
Добавим новый столбец, в котором население (в миллионах) поделим на площадь страны, получив тем самым плотность:
Не нравится новый столбец? Не проблема, удалим его:
Особо ленивые могут просто написать del df[‘density’].
Переименовывать столбцы нужно через метод rename:
В этом примере перед тем как переименовать столбец Country Code, убедитесь, что с него сброшен индекс, иначе не будет никакого эффекта.
Чтение и запись данных
pandas поддерживает все самые популярные форматы хранения данных: csv, excel, sql, буфер обмена, html и многое другое:
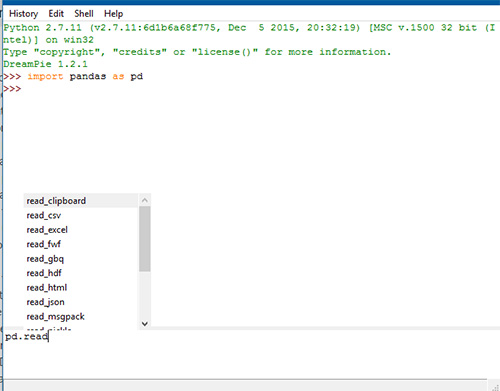
Чаще всего приходится работать с csv-файлами. Например, чтобы сохранить наш DataFrame со странами, достаточно написать:
Функции to_csv ещё передаются различные аргументы (например, символ разделителя между колонками) о которых подробнее можно узнать в официальной документации.
Считать данные из csv-файла и превратить в DataFrame можно функцией read_csv.
Аргумент sep указывает разделитесь столбцов. Существует ещё масса способов сформировать DataFrame из различных источников, но наиболее часто используют CSV, Excel и SQL. Например, с помощью функции read_sql, pandas может выполнить SQL запрос и на основе ответа от базы данных сформировать необходимый DataFrame. За более подробной информацией стоит обратиться к официальной документации.
Группировка и агрегирование в pandas
Группировка данных один из самых часто используемых методов при анализе данных. В pandas за группировку отвечает метод .groupby. Я долго думал какой пример будет наиболее наглядным, чтобы продемонстрировать группировку, решил взять стандартный набор данных (dataset), использующийся во всех курсах про анализ данных — данные о пассажирах Титаника. Скачать CSV файл можно тут.
Необходимо подсчитать, сколько женщин и мужчин выжило, а сколько нет. В этом нам поможет метод .groupby.
А теперь проанализируем в разрезе класса кабины:
Сводные таблицы в pandas
Термин «сводная таблица» хорошо известен тем, кто не по наслышке знаком с инструментом Microsoft Excel или любым иным, предназначенным для обработки и анализа данных. В pandas сводные таблицы строятся через метод .pivot_table. За основу возьмём всё тот же пример с Титаником. Например, перед нами стоит задача посчитать сколько всего женщин и мужчин было в конкретном классе корабля:
В качестве индекса теперь у нас будет пол человека, колонками станут значения из PClass, функцией агрегирования будет count (подсчёт количества записей) по колонке Name.
Всё очень просто.
Анализ временных рядов
В pandas очень удобно анализировать временные ряды. В качестве показательного примера я буду использовать цену на акции корпорации Apple за 5 лет по дням. Файл с данными можно скачать тут.
Здесь мы формируем DataFrame с DatetimeIndex по колонке Date и сортируем новый индекс в правильном порядке для работы с выборками. Если колонка имеет формат даты и времени отличный от ISO8601, то для правильного перевода строки в нужный тип, можно использовать метод pandas.to_datetime.
Давайте теперь узнаем среднюю цену акции (mean) на закрытии (Close):
А если взять промежуток с февраля 2012 по февраль 2015 и посчитать среднее:
А что если нам нужно узнать среднюю цену закрытия по неделям?!
Resampling мощный инструмент при работе с временными рядами (time series), помогающий переформировать выборку так, как удобно вам. Метод resample первым аргументом принимает строку rule. Все доступные значения можно найти в документации.
Визуализация данных в pandas
Для визуального анализа данных, pandas использует библиотеку matplotlib. Продемонстрирую простейший способ визуализации в pandas на примере с акциями Apple.
Берём цену закрытия в промежутке между 2012 и 2017.
И видим вот такую картину:
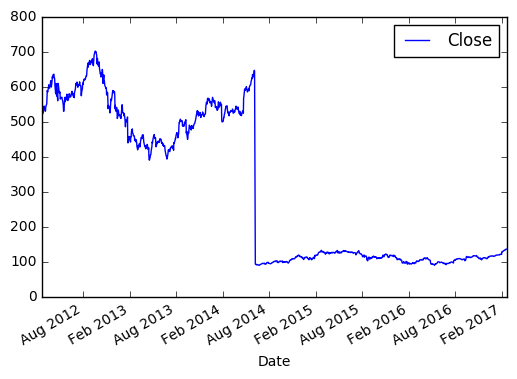
По оси X, если не задано явно, всегда будет индекс. По оси Y в нашем случае цена закрытия. Если внимательно посмотреть, то в 2014 году цена на акцию резко упала, это событие было связано с тем, что Apple проводила сплит 7 к 1. Так мало кода и уже более-менее наглядный анализ 😉
Эта заметка демонстрирует лишь малую часть возможностей pandas. Со своей стороны я постараюсь по мере своих сил обновлять и дополнять её.
Python и Pandas: учебник DataFrame с примерами
В этой статье мы познакомимся с DataFrame из библиотеки Pandas и узнаем как они хранят информацию. Затем мы создадим их вручную и из файлов, а также рассмотрим способы манипуляции данными внутри них.
- Автор записи
Вступление
Pandas – библиотека Python с открытым исходным кодом для анализа данных. Она предназначена для эффективной и интуитивной обработки структурированных данных.
Двумя основными структурами данных в Pandas являются Series (Ряды) и DataFrame. Ряды являются по существу одномерными маркированными массивами любого типа данных, в то время как DataFrames являются двумерными, с потенциально гетерогенными типами данных, маркированными массивами любого типа данных. Гетерогенный означает, что не все «ряды» должны быть одинакового размера.
В этой статье мы рассматрим наиболее распространенные способы создания DataFrame и методы изменения их структуры.
Мы будем использовать блокнот Jupyter, так как он предлагает хорошее визуальное представление DataFrames. Однако любая среда IDE также выполнит эту работу, просто вызвав инструкцию print() для объекта DataFrame.
Создание DataFrame
Каждый раз, когда создается DataFrame, независимо от того, создается ли он вручную или создается из источника данных, например файла, данные должны упорядочиваться в табличном виде как последовательности строк с данными.
Это означает, что строки имеют одинаковый порядок полей, т.е. если требуется DataFrame с информацией об имени и возрасте человека, необходимо убедиться, что все строки содержат информацию одинаково.
Любое несоответствие приведет к тому, что DataFrame будет неисправен, что приведет к ошибкам.
Создание пустого DataFrame
Создать пустой DataFrame так же просто, как:
Рассмотрим, как можно добавлять строки и столбцы в этот пустой DataFrame при управлении их структурой.
Создание DataFrame из списков
Следуя принципу «последовательность строк с одинаковым порядком полей», можно создать DataFrame из списка, который содержит такую последовательность, или из нескольких списков объединённых вместе функцией zip() таким образом, что они обеспечивают последовательность так:
Такого же эффекта можно было бы достичь, если бы данные находились в нескольких списках и были объединены вместе с помощью zip(). Этот подход может быть использован, когда данные, которые мы имеем, предоставляются в виде списков значений для одного столбца (поля), вместо вышеупомянутого способа, в котором список содержит данные для каждой конкретной строки.
Это означает, что у нас есть все данные (по порядку) для столбцов по отдельности, которые, будучи сжатыми вместе, создают строки.
Возможно, вы заметили, что метки столбцов и строк не очень информативны в созданном нами DataFrame. Можно передать эту информацию при создании DataFrame.
Что даёт нам тот же результат, что и раньше, только с более значимыми именами столбцов:
Другим представлением данных, которое можно использовать здесь, является предоставление данных в виде списка словарей в следующем формате:
В нашем примере представление будет выглядеть следующим образом:
И мы создадим DataFrame таким же образом, как и раньше:
Создание DataFrame из словарей
Словари являются еще одним способом предоставления данных в виде столбцов. Каждому столбцу присваивается упорядоченный список строк значений.
Давайте представим те же данные, что и раньше, но в формате словаря:
Что дает нам ожидаемый результат:
Чтение DataFrame из файла
Для чтения и записи DataFrames поддерживается множество типов файлов. Каждая функция соответствует типу файла, например read_csv(), read_excel(), read_json(), read_html() и т.д.
Наиболее распространенным типом файла является .csv (значения разделенные запятыми). Строки состоят из значений, разделенных специальным символом (чаще всего запятой). Можно задать другой разделитель с помощью аргумента sep.
Если вы не знакомы с типом файла .csv , вот пример того, как он выглядит:
Обратите внимание, что первой строкой в файле являются имена столбцов. Конечно, можно указать, с какой строки Pandas должен начать считывать данные, но по умолчанию Pandas рассматривает первую строку как имена столбцов и начинает загрузку данных из второй строки:
Что дает нам на выходе:
Манипулирование Фреймами Данных
В этом разделе рассматриваются основные методы изменения структуры DataFrame. Однако прежде чем перейти к этой теме, необходимо знать, как получить доступ к отдельным строкам или группам строк, а также к столбцам.
Доступ/Расположение Элементов
Pandas имеет два разных способа выбора данных – loc[] и iloc[].
loc[] позволяет выбирать строки и столбцы с помощью меток, таких как row[‘Value’] и culumn[‘Other Value’]. В то же время, iloc[] принимает индекс записей, которые вы хотите выбрать, поэтому вы можете использовать только числа. Можно также выбрать столбцы, просто передав их имя в скобки. Посмотрим, как это работает в действии:
Это также работает для группы строк, от 0 до n:
Важно отметить, что iloc[] всегда ожидает целое число. loc[] поддерживает и другие типы данных. Здесь мы также можем использовать целое число на ряду с другими типами данных, например строки.
Также можно получить доступ к определенным значениям для элементов. Например, может потребоваться получить доступ к элементу во 2-й строке, но вернуть только его значение Name:
Доступ к столбцам так же прост, как запись dataFrameName.ColumnName или dataFrameName [‘ColumnName’]. Второй вариант предпочтителен, так как столбец может иметь то же имя, что и зарезервированное имя в Pandas, и использование первого варианта в этом случае может вызвать ошибки:
Доступ к столбцам можно также получить с помощью loc[] и iloc[]. Например, мы получим доступ ко всем строкам, начиная с 0…n, где n – количество строк, и выберем первый столбец. Вывод совпадает с выводом предыдущей строки кода:
Манипулирование Индексами
Индексы – это метки строк в DataFrame и именно их мы используем при обращении к строкам. Поскольку мы не изменили индексы по умолчанию, которые Pandas присваивают DataFrame при создании, все наши строки были помечены целыми числами от 0 и выше.
Первый способ изменить индексацию вашего DataFrame – это использовать метод set_index() . Мы передаем любой из столбцов в вашем DataFrame этому методу, и он становится новым индексом. Таким образом, мы можем либо сами создавать индексы, либо просто назначить столбец в качестве индекса.
Обратите внимание, что метод не изменяет исходный DataFrame, а вместо этого возвращает новый DataFrame с новым индексом, поэтому мы должны назначить возвращаемое значение переменной DataFrame, если мы хотим сохранить изменение, или установить флаг inplace равным True:
Это будет работать так же хорошо:
Теперь, когда у нас есть нестандартный индекс, мы можем использовать новый набор значений, используя reindex(), Pandas автоматически заполнит значения NaN для каждого индекса, который не может быть сопоставлен с существующей строкой:
Вы можете контролировать, какое значение Pandas использует для заполнения пропущенных значений, установив необязательный параметр fill_value :
Поскольку мы установили новый индекс для нашего DataFrame, loc[] теперь работает с этим индексом:
Манипулирование строками (rows)
Добавление и удаление строк становится простым, если удобно использовать loc[]. Если задать несуществующую строку, она будет создана:
И если вы хотите удалить строку, вы указываете ее индекс функции drop () . Он принимает необязательный параметр axis . Ось | принимает 0 / индекс или 1 / колонки . В зависимости от этого функция drop() отбрасывает либо вызываемую строку, либо вызываемый столбец.
Если требуется удалить строку, необходимо указать ее индекс для функции drop(). Она принимает необязательный параметр, axis. Axis может быть 0/index или 1/columns. В зависимости от этого функция drop() удаляет строку или столбец для которого она была вызвана.
Если не указать значение параметра axis , то соответствующая строка будет удалена по умолчанию, так как axis 0 по умолчанию:
Если не указать значение параметра axis, соответствующая строка будет удалена по умолчанию, так как axis по умолчанию равен 0:
Вы также можете переименовать строки, которые уже существуют в таблице. Функция rename() принимает словарь изменений, которые вы хотите внести:
Обратите внимание, что drop() и rename() также принимают необязательный параметр inplace . Установка этого параметра в True ( False по умолчанию) скажет Pandas изменить исходный DataFrame вместо того, чтобы возвращать новый. Если оставить его не заданным, вам придется упаковать полученный DataFrame в новый, чтобы сохранить изменения.
Другим полезным методом, о котором следует знать, является функция drop_duplicates(), которая удаляет все повторяющиеся строки из DataFrame. Давайте продемонстрируем это, добавив две повторяющиеся строки:
Что дает нам выход:
Теперь мы можем вызвать drop_duplicates() :
И дубликаты строк будут удалены:
Манипулирование столбцами (columns)
Новые столбцы можно добавлять аналогично добавлению строк:
Также, как и строки, столбцы можно удалить, вызвав функцию drop() , с той лишь разницей, что вы должны установить необязательный параметр axis в значение 1 чтобы Pandas знали, что вы хотите удалить столбец, а не строку:
Когда речь идет о переименовании столбцов, функции rename() нужно сказать конкретно, что мы хотим изменить столбцы, установив необязательные параметр columns значение нашего “словаря изменений”:
Опять же, как и при удалении/переименовании строк, вы можете установить необязательный параметр на месте в True если вы хотите, чтобы исходный DataFrame был изменен вместо функции, возвращающей новый DataFrame .
Опять же, как и при удалении/переименовании строк, можно установить для параметра inplace значение True, если требуется изменить исходный DataFrame вместо создания нового DataFrame.
Вывод
В этой статье мы рассмотрели, что такое Pandas DataFrame s, поскольку они являются ключевым классом из фреймворка Pandas, используемого для хранения данных.
В этой статье мы рассмотрели, что такое Pandas DataFrame, поскольку он является ключевым классом фреймворка Pandas для хранения данных.
Мы научились создавать DataFrame вручную, используя список и словарь, после чего считывали данные из файла.
Затем мы манипулировали данными в DataFrame – используя loc[] и iloc[] , мы находили данные, создавали новые строки и столбцы, переименовывали существующие и затем удаляли их.
Затем мы манипулировали данными в DataFrame используя loc[] и iloc[]. Мы обнаружили данные, создали новые строки и столбцы, переименовали существующие, а затем удалили их.
Изучаем pandas. Урок 2. Структуры данных Series и DataFrame
Во втором уроке мы познакомимся со структурами данных pandas – это Series и DataFrame. Основное внимание будет уделено вопросам создания и получения доступа к элементам данных структур, а также общим понятиям, которые позволят более интуитивно работать с ними в будущем.
Введение
Библиотека pandas предоставляет две структуры: Series и DataFrame для быстрой и удобной работы с данными (на самом деле их три, есть еще одна структура – Panel , но в данный момент она находится в статусе deprecated и в будущем будет исключена из состава библиотеки pandas ). Series – это маркированная одномерная структура данных, ее можно представить, как таблицу с одной строкой. С Series можно работать как с обычным массивом (обращаться по номеру индекса), и как с ассоциированным массивом, когда можно использовать ключ для доступа к элементам данных. DataFrame – это двумерная маркированная структура. Идейно она очень похожа на обычную таблицу, что выражается в способе ее создания и работе с ее элементами. Panel – про который было сказано, что он вскоре будет исключен из pandas , представляет собой трехмерную структуру данных. О Panel мы больше говорить не будем. В рамках этой части мы остановимся на вопросах создания и получения доступа к элементам данных структур Series и DataFrame .
Структура данных Series
Для того, чтобы начать работать со структурами данных из pandas требуется предварительно импортировать необходимые модули. Убедитесь, что нужные модули установлены на вашем компьютере, о том, как это сделать, можно прочитать в первой части данного курса. Также будем считать, что вы знакомы с языком Python . Если нет, то специально для вас мы подготовили он-лайн курс и книгу.
Помимо самого pandas нам понадобится библиотека numpy . Наши эксперименты будем проводить с использованием пакета Anaconda , в качестве среды разработки советуем взять Spyder , который входит в базовую поставку Anaconda . Для того, чтобы запустить Spyder , перейдите в каталог Scripts , который находится в папке с установленной Anaconda и запустите spyder.exe . Для нас он в первую очередь имеет ценность в том, что в нем есть редактор исходного кода, на случай, если нам понадобится написать довольно большую программу, и интерпретатор для быстрых экспериментов. Если строки кода будут содержать префикс в виде цифры в квадратных скобках, то это означает, что данные команды мы вводим в интерпретаторе, в ином случае, это будет означать, что код написан в редакторе.
Пора переходить к практике!
Импортируем нужные нам библиотеки.
Создать структуру Series можно на базе различных типов данных:
- словари Python ;
- списки Python ;
- массивы из numpy: ndarray ;
- скалярные величины.
Конструктор класса Series выглядит следующим образом:
data – массив, словарь или скалярное значение, на базе которого будет построен Series;
index – список меток, который будет использоваться для доступа к элементам Series . Длина списка должна быть равна длине data ;
dtype – объект numpy.dtype , определяющий тип данных;
copy – создает копию массива данных, если параметр равен True в ином случае ничего не делает.
В большинстве случаев, при создании Series, используют только первые два параметра. Рассмотрим различные варианты как это можно сделать.
Создание Series из списка Python
Самый простой способ создать Series – это передать в качестве единственного параметра в конструктор класса список Python.
В данном примере была создана структура Series на базе списка из языка Python . Для доступа к элементам Series , в данном случае, можно использовать только положительные целые числа – левый столбец чисел, начинающийся с нуля – это как раз и есть индексы элементов структуры, которые представлены в правом столбце.
Можно попробовать использоваться больше возможностей из тех, что предлагает pandas , для этого передадим в качестве второго элемента список строк (в нашем случае – это отдельные символы). Такой шаг позволит нам обращаться к элементам структуры Series не только по численному индексу, но и по метке, что сделает работу с таким объектом, похожей на работу со словарем.
Обратите внимание на левый столбец, в нем содержатся метки, которые мы передали в качестве index параметра при создании структуры. Правый столбец – это по-прежнему элементы нашей структуры.
Создание Series из ndarray массива из numpy
Создадим простой массив из пяти чисел, аналогичный списку из предыдущего раздела. Библиотеки pandas и numpy должны быть предварительно импортированы.
Теперь создадим Series с буквенными метками.
Создание Series из словаря (dict)
Еще один способ создать структуру Series – это использовать словарь для одновременного задания меток и значений.
Ключи ( keys ) из словаря d станут метками структуры s4 , а значения ( values ) словаря – значениями в структуре.
Создание Series с использованием константы
Рассмотрим еще один способ создания структуры. На этот раз значения в ячейках структуры будут одинаковыми.
В созданной структуре Series имеется три элемента с одинаковым содержанием.
Работа с элементами Series
В будущем будет написан отдельный урок, посвященный индексации и работе с элементами Series и DataFrame , сейчас рассмотрим основные подходы.
К элементам Series можно обращаться по численному индексу, при таком подходе работа со структурой не отличается от работы со списками в Python .
Можно использовать метку, тогда работа с Series будет похожа на работу со словарем (dict) в Python.
Доступно получение slice’ов.
В поле для индекса можно поместить условное выражение.
Со структурами Series можно работать как с векторами: складывать, умножать вектор на число и т.п.
Структура данных DataFrame
Если Series представляет собой одномерную структуру, которую для себя можно представить как таблицу с одной строкой, то DataFrame – это уже двумерная структура – полноценная таблица с множеством строк и столбцов.
Перед работой с DataFrame не забудьте импортировать библиотеку pandas .
Конструктор класса DataFrame выглядит так:
data – массив ndarray , словарь ( dict ) или другой DataFrame ;
index – список меток для записей (имена строк таблицы);
columns – список меток для полей (имена столбцов таблицы);
dtype – объект numpy.dtype , определяющий тип данных;
copy – создает копию массива данных, если параметр равен True в ином случае ничего не делает.
Структуру DataFrame можно создать на базе:
- словаря ( dict ) в качестве элементов которого должны выступать: одномерные ndarray , списки, другие словари, структуры Series ;
- двумерные ndarray ;
- структуры Series ;
- структурированные ndarray ;
- другие DataFrame .
Рассмотрим на практике различные подходы к созданию DataFrame’ов .
Создание DataFrame из словаря
В данном случае будет использоваться одномерный словарь, элементами которого будут списки, структуры Series и т.д.
Начнем с Series.
Теперь построим аналогичный словарь, но на элементах ndarray .
Как видно – результат аналогичен предыдущему. Вместо ndarray можно использовать обычный список из Python .
Создание DataFrame из списка словарей
До это мы создавали DataFrame из словаря, элементами которого были структуры Series , списки и массивы, сейчас мы создадим DataFrame из списка, элементами которого являются словари.
Создание DataFrame из двумерного массива
Создать DataFrame можно также и из двумерного массива, в нашем примере это будет ndarray из библиотеки numpy .
Работа с элементами DataFrame
Работа с элементами DataFrame – доступ к элементам данной структуры – тема достаточно обширная и она будет освещена в одном из ближайших уроков. Сейчас мы рассмотрим наиболее часто используемые способы работы с элементами DataFrame .
Основные подходы представлены в таблице ниже.
| Операция | Синтаксис | Возвращаемый результат |
| Выбор столбца | df[col] | Series |
| Выбор строки по метке | df.loc[label] | Series |
| Выбор строки по индексу | df.iloc[loc] | Series |
| Слайс по строкам | df[0:4] | DataFrame |
| Выбор строк, отвечающих условию | df[bool_vec] | DataFrame |
Теперь посмотрим, как использовать данные операций на практике.
Для начала создадим DataFrame .
Операция: выбор столбца.
Операция: выбор строки по метке.
Операция: выбор строки по индексу.
Операция: slice по строкам.
Операция: выбор строк, отвечающих условию.
P.S.

Изучаем pandas. Урок 2. Структуры данных Series и DataFrame : 6 комментариев
Опечатка: случае[т]
В большинстве случает, при создании Series
P.S. Спасибо за статью!
> Конструктор класса Series выглядит следующим образом:
> … fastpath=False
Про этот параметр ничего не сказали.
И слово “slice”, которое вы как только не склоняете здесь и далее в книге, переводится как “срез”. Это вполне себе русское и подходящее по смыслу слово.
Как мне кажется, ‘slice’ стало уже сленговым словом, и его вполне можно употреблять. Но слово ‘срез’ звучит тоже не плохо))) В данном случае выбор был сделан в пользу первого.