sklearn.model_selection .train_test_split
Split arrays or matrices into random train and test subsets.
Quick utility that wraps input validation and next(ShuffleSplit().split(X, y)) and application to input data into a single call for splitting (and optionally subsampling) data in a oneliner.
Read more in the User Guide .
Parameters *arrays sequence of indexables with same length / shape[0]
Allowed inputs are lists, numpy arrays, scipy-sparse matrices or pandas dataframes.
test_size float or int, default=None
If float, should be between 0.0 and 1.0 and represent the proportion of the dataset to include in the test split. If int, represents the absolute number of test samples. If None, the value is set to the complement of the train size. If train_size is also None, it will be set to 0.25.
train_size float or int, default=None
If float, should be between 0.0 and 1.0 and represent the proportion of the dataset to include in the train split. If int, represents the absolute number of train samples. If None, the value is automatically set to the complement of the test size.
random_state int, RandomState instance or None, default=None
Controls the shuffling applied to the data before applying the split. Pass an int for reproducible output across multiple function calls. See Glossary .
shuffle bool, default=True
Whether or not to shuffle the data before splitting. If shuffle=False then stratify must be None.
stratify array-like, default=None
If not None, data is split in a stratified fashion, using this as the class labels. Read more in the User Guide .
Как разделить данные на наборы обучения и тестирования?
В области машинного обучения является обычная практика для разделения набора данных на два разных набора. Эти наборы Обучение Установить и Набор тестирования Отказ Предпочтительно поддерживать обучение и тестирование данных отдельно.
Почему мы должны разделить наш набор данных?
Если мы не разделим набор набора данных на наборы тренировок и тестирования, мы прекращаем тестирование и обучение нашей модели на одни и те же данные. Когда мы проверяем на одни и те же данные, мы обучили нашу модель, мы склонны получить хорошую точность.
Однако это не значит, что модель будет работать так же хорошо на невидимых данных. Это называется переоборудование В мире машинного обучения.
Преодоление – это случай, когда ваша модель представляет собой набор данных слишком точно. Это означает, что ваша модель слишком близко подходит.
Переоснащение – это нежелательное явление при обучении модели. Так подходит.
Подзадание – это когда модель даже не может представлять точки данных в тренировочном наборе данных.
Как разделить набор данных, используя Sklearn?
Посмотрим, как мы можем использовать Sklearn, чтобы разделить набор данных на наборы тренировки и тестирования. Мы будем перейти на процесс шаг за шагом.
1. Импортируйте набор данных
Давайте начнем, импортируя набор данных в нашу ноутбук Python. В этом руководстве мы собираемся использовать набор данных Titian в качестве набора данных. Вы можете импортировать набор данных Титаника из Библиотека морской библиотеки в питоне.
2. Форма ввода и выходных векторов из набора данных
Прежде чем перейти к разделению набора данных на наборы тренировок и тестирования, нам необходимо подготовить векторы ввода и вывода из набора данных.
Давайте лечить « выжил «Столбец как вывод. Это означает, что эта модель будет обучена предсказать, выживет ли человек, выживет или нет.
Нам также нужно удалить ‘ выжил «Столбец из набора данных, чтобы получить вектор ввода.
3. Решив раскол соотношения
Коэффициент разделения представляет собой какую часть данных перейдет на набор тренировок и какую часть она перейдет на набор тестирования. Учебный набор почти всегда больше, чем набор тестирования.
Наиболее распространенное расщепленное соотношение, используемое учеными данных, является 80:20.
Коэффициент разделения 80:20 означает, что 80% данных пойдут на учебный набор и 20% набора данных пойдут на набор тестирования.
4. Выполнение раскола
Разделить данные, которые мы будем использовать rain_test_split от библиотеки Sklearn.
rain_test_split Случайно распределяет ваши данные на набор тренировок и тестирования в соответствии с предоставленным соотношением.
Мы собираемся использовать 80:20 как раскол соотношения.
Нам сначала нужно импортировать rain_test_split от Sklearn.
Для выполнения раскола использования:
Мы упомянули размер теста как 0.2, это означает, что размер обучения составит 0,8, давая нам наше желаемое соотношение.
5. Проверьте, печать форм обучения и тестирования векторов
Чтобы проверить разделение, давайте расстегиваем формы разных векторов.
Полный код
Полный код для этого учебника приведен ниже:
Заключение
В этом руководстве было о разделении данных на наборы обучения и тестирования, используя Sklearn в Python. Мы также обсудили концепции, такие как переопределение, подходящие для понимания необходимости разделения данных.
Примеры разделения датасета на train и test c Scikit-learn
Если вы разбиваете датасет на данные для обучения и тестирования, нужно помнить о некоторых моментах. Далее следует обсуждение трех передовых практик, которые стоит учитывать при подобном разделении. А также демонстрация того, как реализовать эти соображения в Python.
В данной статье обсуждаются три конкретных особенности, которые следует учитывать при разделении набора данных, подходы к решению связанных проблем и практическая реализация на Python.
Для наших примеров мы будем использовать модуль train_test_split библиотеки Scikit-learn, который очень полезен для разделения датасетов, независимо от того, будете ли вы применять Scikit-learn для выполнения других задач машинного обучения. Конечно, можно выполнить такие разбиения каким-либо другим способом (возможно, используя только Numpy). Библиотека Scikit-learn включает полезные функции, позволяющее сделать это немного проще.
Возможно, вы использовали этот модуль для разделения данных в прошлом, но при этом не приняли во внимание некоторые детали.
Случайное перемешивание строк
Первое, на что следует обратить внимание: перемешаны ли ваши экземпляры? Это следует делать пока нет причин не перетасовывать данные (например, они представляют собой временные интервалы). Мы должны убедиться в том, что наши экземпляры не разбиты на выборки по классам. Это потенциально вносит в нашу модель некоторую нежелательную предвзятость.
Например, посмотрите, как одна из версий набора данных iris, упорядочивает свои экземпляры при загрузке:
Если такой набор данных с тремя классами при равном числе экземпляров в каждом разделить на две выборки: 2/3 для обучения и 1/3 для тестирования, то полученные поднаборы будут иметь нулевое пересечение классовых меток. Это, очевидно, недопустимо при изучении признаков для предсказания классов. К счастью, функция train_test_split по умолчанию автоматически перемешивает данные (вы можете переопределить это, установив для параметра shuffle значение False ).
- В функцию должны быть переданы как вектор признаков, так и целевой вектор (X и y).
- Для воспроизводимости вы должны установить аргумент random_state .
- Также необходимо определить либо train_size , либо test_size , но оба они не нужны. Если вы явно устанавливаете оба параметра, они должны составлять в сумме 1.
Вы можете убедится, что теперь наши классы перемешаны.
Стратификация (равномерное распределение) классов
Данное размышление заключается в следующем. Равномерно ли распределено количество классов в наборах данных, разделенных для обучения и тестирования?
Это не равная разбивка. Главная идея заключается в том, получает ли наш алгоритм равные возможности для изучения признаков каждого из представленных классов и последующего тестирования результатов обучения, на равном числе экземпляров каждого класса. Хотя это особенно важно для небольших наборов данных, желательно постоянно уделять внимание данному вопросу.
Мы можем задать пропорцию классов при разделении на обучающий и проверяющий датасеты с помощью параметра stratify функции train_test_split . Стоит отметить, что мы будем стратифицировать в соответствии распределению по классам в y .
Сейчас это выглядит лучше, и представленные числа говорят нам, что это наиболее оптимально возможное разделение.
Дополнительное разделение
Третье соображение относится к проверочным данным (выборке валидации). Есть ли смысл для нашей задачи иметь только один тестовый датасет. Или мы должны подготовить два таких набора — один для проверки наших моделей во время их точной настройки, а еще один — в качестве окончательного датасета для сравнения моделей и выбора лучшей.
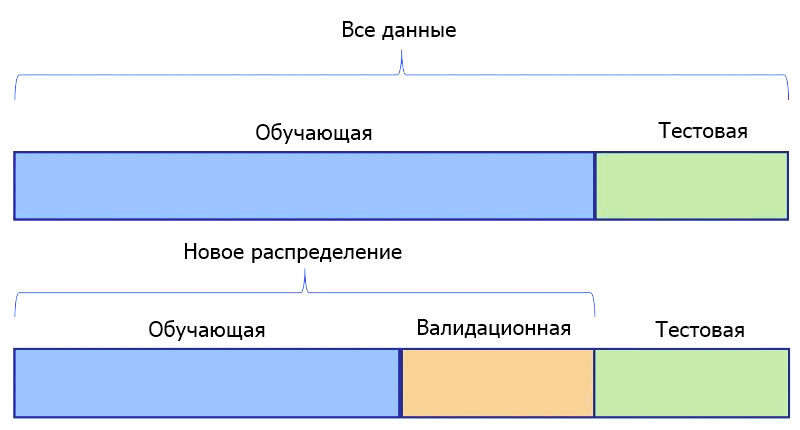
Если мы определим 2 таких набора, это будет означать, что одна выборка, будет храниться до тех пор, пока все предположения не будут проверены, все гиперпараметры не настроены, а все модели обучены для достижения максимальной производительности. Затем она будет показана моделям только один раз в качестве последнего шага в наших экспериментах.
Если вы хотите использовать датасеты для тестирования и валидации, создать их с помощью train_test_split легко. Для этого мы разделяем весь набор данных один раз для выделения обучающей выборки. Затем еще раз, чтобы разбить оставшиеся данные на датасеты для тестирования и валидации.
Ниже, используя набор данных digits, мы разделяем 70% для обучения и временно назначаем остаток для тестирования. Не забывайте применять методы, описанные выше.