toml-lang/toml
This repository contains the in-development version of the TOML specification. You can find the released versions at https://toml.io.
TOML aims to be a minimal configuration file format that’s easy to read due to obvious semantics. TOML is designed to map unambiguously to a hash table. TOML should be easy to parse into data structures in a wide variety of languages.
Comparison with Other Formats
TOML shares traits with other file formats used for application configuration and data serialization, such as YAML and JSON. TOML and JSON both are simple and use ubiquitous data types, making them easy to code for or parse with machines. TOML and YAML both emphasize human readability features, like comments that make it easier to understand the purpose of a given line. TOML differs in combining these, allowing comments (unlike JSON) but preserving simplicity (unlike YAML).
Because TOML is explicitly intended as a configuration file format, parsing it is easy, but it is not intended for serializing arbitrary data structures. TOML always has a hash table at the top level of the file, which can easily have data nested inside its keys, but it doesn’t permit top-level arrays or floats, so it cannot directly serialize some data. There is also no standard identifying the start or end of a TOML file, which can complicate sending it through a stream. These details must be negotiated on the application layer.
INI files are frequently compared to TOML for their similarities in syntax and use as configuration files. However, there is no standardized format for INI and they do not gracefully handle more than one or two levels of nesting.
- YAML spec: https://yaml.org/spec/1.2/spec.html
- JSON spec: https://tools.ietf.org/html/rfc8259
- Wikipedia on INI files: https://en.wikipedia.org/wiki/INI_file
Documentation, bug reports, pull requests, and all other contributions are welcome!
We have an Official TOML Wiki that catalogs the following:
- Projects using TOML
- Implementations
- Validators
- Language-agnostic test suite for TOML decoders and encoders
- Editor support
- Encoders
- Converters
Please take a look if you’d like to view or add to that list. Thanks for being a part of the TOML community!
Tree — единый AST чтобы править всеми
Здравствуйте, меня зовут Дмитрий Карловский и я… рассекаю на велосипедах… по бездорожью… против ветра… в гору… на лыжах. И сегодня я приглашаю вас прокатиться со мной вдоль и поперёк текстовых форматов данных и вместе спроектировать идеальный формат.
Я уже рассказывал о нём 5 лет назад, что привело к жарким дебатам, повлёкшим за собой небольшие изменения синтаксиса. Поэтому позвольте рассказать с чистого листа что он представляет из себя на текущий момент.
Это — расширенная текстовая версия одноимённого выступления на PiterJS#47. Вы можете читать её как статью, либо открыть в интерфейсе проведения презентаций, либо посмотреть видео.
- Проанализировать популярные текстовые форматы данных
- С нуля разработать новый формат без недостатков
- Показать примеры применения нового формата
Форматы
Сравнивать мы будем 5 форматов.
| Формат |
|---|
| XML |
| JSON |
| YAML |
| TOML |
| Tree |
Про первые три не слышал только глухой. А вот два последних для многих — тёмные лошадки. Ну ничего, сегодня я пролью на них свет.
Пример XML
XML — некогда самый популярный формат, можно сказать «технологический стандарт». Но не смотря на всю свою мощь, сейчас он изживает своё, так как является слишком сложным для современного веб-разработчика.
Пример JSON
На смену XML приходит более простой и дерзкий формат данных — JSON.
Если вы считаете, что вот он, идеал, то прошу меня заранее извинить, так как далее я буду вас расстраивать.
Пример YAML
Кто-то уже пророчит YAML на смену JSON.
Благодаря лучшей человекочитаемости он уже обрёл популярность в сфере ручного написания конфигурационных файлов.
Пример TOML
Про TOML же мало кто слышал. Однако, взгляните на пример и вам станет ясно, почему я о нём вообще упоминаю.
Да, это фактически, стандартизированный INI-конфиг, которого покусал JSON. В результате чего он вобрал в себя худшее из обоих миров.
Пример Tree
Наконец, в качестве спойлера, позвольте показать вам минимальный не пустой файл в формате Tree, который мы и будем разрабатывать далее.
Модели данных
Разные форматы основаны на разных моделях данных. Выбранная модель отвечает на следующие два вопроса.
- Какие данные мы можем записать и прочитать без бубна?
- Как записывать данные не вписывающиеся в модель?
Ни один формат не способен поддержать всё многообразие типов предметных областей, поэтому неизбежно возникает необходимость упаковки данных в некоторый формат и последующей обратной распаковки.
Модель XML
XML основан на модели типизированных элементов в которых находится один словарь атрибутов и один список вложенных типизированных узлов.
- NodeList
- Element Node ( <br/> )
- Attribute Node ( tabindex=»1″ )
- Text Node ( Hello, World! )
- CDATA Node ( <![CDATA[ . ]]> )
- Processing Instruction Node ( <? . ?> )
- Comment Node ( <!— . —> )
- Document Node
- Document Type Node ( <!DOCTYPE html> )
Недостатки модели XML
Это довольно гибкая модель, однако она имеет ряд ограничений: значениями атрибутов могут быть только строки, а вложенный список узлов может быть только один. Не смотря на то, что формат XML и так не самый простой, банальный словарь с поддеревьями в качестве значений требует дополнительных соглашений. Например, такого: некоторые элементы используются для описания ключей в родительском элементе и такие элементы в родительском должны быть лишь в одном экземпляре.
Тут panel — это компонент, а body — уже не компонент, а параметр. Ему бы место в атрибутах, да только в атрибуты можно лишь строки помещать и ничего более.
Расширяемость модели XML
Благодаря пространствам имён, в рамках одного XML документа могут вперемешку идти множество языков, не ломая интерпретацию друг друга.
Это — очень мощная техника, которой не хватает в более молодых форматах.
Модель JSON
Модель JSON основана на том, что всё дерево состоит из не типизированных списков и словарей. Плюс ограниченный набор примитивов в качестве листьев дерева.
- Null
- Boolean
- Number
- String
- Array
- Dictionary
Недостатки модели JSON
Наивно было бы полагать, что двух типов структурных узлов хватит для всего. Например, возьмём словарь. Ключи в нём не упорядочены, то есть могут возвращаться парсером в любом порядке.
А если нам нужен словарь с упорядоченными ключами?
Нам пришлось кардинально поменять синтаксис и налепить массивы массивов. А ведь это всего-лишь другой тип словаря.
Нерасширяемость модели JSON
Ну и самый главный недостаток модели JSON в её нерасширяемости, из-за чего приходится вводить кучу хитрых правил, чтобы упихнуть всё многообразие прикладных типов их отношений. Возьмём для примера запрос к MongoDB, авторы которой решили, что JSON отлично походит на роль языка запросов.
Мы видим, что парные логические операции OR и AND имеют совершенно различный синтаксис. Предиката равенства катастрофически не хватает, ведь нужны ещё предикаты «больше», «меньше» и даже «соответствует регулярному выражению». И, кстати, сами регулярные выражения не представимы в JSON иначе как в виде строки и соглашения, что если она находится в словаре для ключа с именем «$regexp», то это сериализованная регулярка и при парсинге нужно создать соответствующий объект.
Модель YAML
Модель YAML во многом аналогична модели JSON. Разве что тут есть поддержка времени и внутренних ссылок.
- !!null
- !!bool
- !!int
- !!float
- !!str
- !!timestamp
- !!seq
- !!map
- Anchor & Alias
- Document
- TypeTags
Расширяемость модели YAML
Главное преимущество YAML в аннотациях типа, позволяющих объяснять процессору какой алгоритм использовать для распаковки данных.
В данном примере мы говорим парсеру «возьми этот список пар ключ-значение» и преобразуй его в объект OrderedMap (упорядоченный словарь).
Модель TOML
Модель TOML как у JSON, но чуть более приземлённая. Например, тут различаются целые и вещественные числа, что важно для компилируемых языков, а так же есть поддержка времени.
- Boolean
- Integer
- Float
- String
- DateTime
- Array
- Dictionary
С расширяемостью же тут всё так же плохо, как и в JSON.
Модель Tree
Какой бы набор базовых типов мы ни выбрали, его не хватит для всего. А значит неизбежно потребуется некоторый код упаковки и распаковки. А работать с таким кодом проще всего, когда число разных типов узлов минимально, так как для каждого типа требуется писать отдельную ветку логики. В то же время гибкость требуется максимальная. Поэтому нам хватит всего двух типов узлов.
- Struct Node
- Data Node
Структурные узлы служат для описания иерархии, а узлы данных хранят сырые бинарные данные. Любой узел может хранить в себе список любых других узлов, чем достигается недостижимая в иных форматах гибкость.
Расширяемость модели
Итого, по расширяемости всё очень плохо. Популярные форматы либо расширяемые, но неимоверно переусложнённые, либо простые, но совершенно не расширяемые.
| XML | JSON | YAML | TOML | Tree | |
|---|---|---|---|---|---|
| Расширяемость | + | — | + | — | + |
| Число паттернов | 90 | 30 | 210 | 90 | 10 |
Обратите внимание на YAML. Его грамматика насчитывает две сотни паттернов. Он настолько сложен, что вы скорее всего не найдёте ни одной полной и правильной реализации его парсера. Да что уж там, даже два одинаково работающих парсера JSON нужно ещё поискать, а ведь там всего казалось бы 30 паттернов.
Нашей целью же будет создание предельно простого, не допускающего разночтений, но в то же время максимально расширяемого формата.
Удобочитаемость
Наглядность синтаксиса важна при самых различных сценариях работы с форматом: при написании, при ревью кода, при разрешении конфликтов, при отладке, при изучении.
Скорость вашей работы и предсказуемость её результатов напрямую зависит от способа сериализации формата. Однако у некоторых форматов с этим серьёзные проблемы.
| XML | JSON | YAML | TOML | Tree | |
|---|---|---|---|---|---|
| Удобочитаемость | — | — | + | + | + |
Удобочитаемость XML
XML построен вокруг текста, внутрь которого вкрапляются теги с дополнительной информацией. Пока этой информации не много, всё хорошо, но чем её больше, тем сложнее воспринимать текст, что нивелирует полезность этой фичи.
Удобочитаемость JSON
XML хотя бы поддерживает многострочный текст, а вот JSON, например, этим похвастаться уже не может. Форматы этого типа идут от информационной структуры, в которую уже вкрапляются текстовые и не только текстовые значения.
Строгость
Как правило с пониманием написанного нет никаких проблем. Но YAML тут отличился.
| XML | JSON | YAML | TOML | Tree | |
|---|---|---|---|---|---|
| Однозначный синтаксис | + | + | — | + | + |
Нестрогость YAML
Вот таких приколов в YAML довольно много.
Экранирование
Близкая к читаемости тема — это экранирование. Наличие оного в той или иной мере неизбежно приводит к снижению читаемости. При разработке экранирования стоит иметь ввиду следующие моменты.
- Нужно отличать конструкции формата от собственно данных
- Желательно не терять в наглядности данных
- Желательно не переусложнять редактирование
Экранирование в XML
XML — чудесный пример, как делать экранирование не надо.
Из простого и наглядного текста получается какой-то криптотекст, который приходится мысленно интерпретировать, чтобы понять что тут написано.
Экранирование в JSON
Похожая проблема есть и в JSON, хоть и в меньшей мере. Если вы когда-нибудь писали плагины для подсветки синтаксиса VSCode, то знаете, что грамматики там описываются именно в JSON формате, куда записываются регулярные выражения.
Регулярки и сами по себе не самые наглядные штуки, а заэкранированные и того хуже. Допустить в них ошибку в таких условиях очень просто, а дебажить это не очень-то легко.
Экранирование в YAML
В YAML проблему экранирования в целом решили, но какой ценой.
- 5 типов строк
- 4 модификатора обработки пробелов
И всё это вам нужно знать, чтобы правильно прочитать любой YAML файл.
Экранирование в Tree
Самое удобочитаемое экранирование — это отсутствие экранирования. Поэтому у нас его не будет. Вы возможно подумали, что я сошёл с ума, но чуть позже я покажу, как этого добиться.
Минификация
Многие форматы поддерживают различные способы форматирования одних и тех же данных. Но это всегда компромисс между размером и удобочитаемостью.
- Читаемое форматирование много весит
- Компактное форматирование плохо читается
Минификация XML
Если минифицировать XML, то можно сэкономить несколько десятков процентов в размере, но результат получается ещё сложнее читать.
Минификация JSON
С JSON экономия чуть больше, но и читаемость страдает сильнее — вместо закрывающих тегов мы видим вереницу квадратных и фигурных скобочек.
Минификация Tree
Наш путь бескомпромиссный — формат должен быть одновременно и предельно компактным, и легко воспринимаемым человеком.
Статистика по минификации
| XML | JSON | YAML | TOML | Tree | |
|---|---|---|---|---|---|
| Читаемый | 195% | 140% | 125% | 110% | 100% |
| Минифицированный | 170% | 101% | — | — | — |
Как видите, можно сделать формат, который в читаемом виде весит меньше, чем любой другой, даже если их минифицировать. Весь секрет в том, чтобы читаемость достигалась самой структурой формата, и не требовала дополнительного форматирования, раздувающего объём.
Священные войны
Частая проблема при работе с различными форматами — это бесконечные споры о, казалось бы, мелочах.
- Табы или пробелы?
- 2 или 4 пробела?
- возврат каретки нужен?
- выравнивание делаем?
- правила линтера/форматера?
- при сохранении/комите/пуше?
Эти споры отнимают время и эмоции, но они совершенно бессмысленны. Лучше, если формат будет иметь единые, чётко заданные правила, которые одинаково понимаются любым инструментом и человеком. Поэтому наш формат будет предельно жёстким, без каких-либо вольностей.
Скорость обработки
Простота, жёсткость и отсутствие экранирования потенциально даёт куда большую возможную скорость обработки.
Например, в JSON, чтобы записать произвольную строку, нужно пройтись по каждому символу и перед определёнными вывести в выходной буфер обратную косую черту. То есть мы даже не можем заранее узнать сколько памяти нам на выделить для выходного буфера. А во время парсинга нужно делать обратную операцию с формированием новой строки. Мы не можем переиспользовать исходный кусок памяти.
Когда же у нас нет экранирования, мы можем просто брать куски памяти и как есть отправлять в выходной поток при сериализации, что очень быстро. И наоборот, при парсинге мы можем просто ссылаться на куски исходного буфера и не делать лишних выделений памяти.
Координаты ошибки
Во время парсинга часто теряется информация об исходном расположении получаемых из формата узлов. Например, мы получили JSON, начали его обработку, и где-то в глубине вдруг поняли, что в базе данных у нас нет того пользователя, что указан в файле. В этот момент мы должны показать ошибку, но в тексте этой ошибки мы не можем указать в каком месте какого именно файла она допущена. Всё потому, что эта информация при парсинге теряется. И это весьма распространённая проблема.
| XML | JSON | YAML | TOML | Tree | |
|---|---|---|---|---|---|
| Адрес | + | — | — | — | + |
| Позиция | — | — | — | — | + |
| Диапазон | — | — | — | — | + |
В XML-узлах есть ссылка на ресурс из которого он получен, но где он в этом ресурсе — ищите глазами. Для решения этой проблемы есть специальные парсеры, которые дают на выходе не массивы и словари, а Абстрактное Синтаксическое Дерево. Но работать с ним уже не так-то просто, да ещё и медленно это дело.
Чтож, информация эта важная, и я предлагаю её не терять. Никогда не терять. Сохранение координат узлов нам ещё пригодится, когда речь пойдёт об AST и сорсмапах.
Поточная обработка
Бывает, что данных много, а памяти мало, но работать с данными нужно быстро. А бывает, что данные вообще не кончаются. Например, вам нужно непрерывно обрабатывать логи по мере их поступления. В этих случаях спасают возможности по поточной обработке данных.
| XML | JSON | YAML | TOML | Tree | |
|---|---|---|---|---|---|
| Поточная обработка | — | — | + | + | + |
Как видно, самые распространённые форматы не имеют поддержки поточной обработки. Они требуют, чтобы у вас был ровно один завершённый корень документа, иначе — ошибка парсинга. В случае постоянно поступающих данных типа логов, например, дописывать их в документ, сохраняя его корректность — задача не из простых.
Это не значит, что к ним нельзя прикрутить поточную обработку. Например, для XML есть более низкоуровневые SAX парсеры, позволяющие вам работать не с деревом элементов, а с потоком тегов: открылся такой-то тег, пришла строка, закрылся такой-то тег. А для JSON есть целая вязанка протоколов стриминга сообщений. Основная проблема тут в том, что далеко не любой поддерживающий формат инструмент сможет переварить ваши данные без дополнительных телодвижений.
Форматы же поддерживающие поточную обработку, можно легко дополнять дописыванием данных в конец. Можно склеивать несколько потоков данных в один и, наоборот, нарезать на части. Можно обрабатывать по частям, не дожидаясь завершения передачи. И всё это без потери корректности работы с форматом.
Формат Tree
Что ж, резюмируя ранее сказанное, давайте сформулируем все требования для нашего нового формата.
- Простота синтаксиса
- Никакого экранирования
- Никаких вольностей
- Никакой минификации
- Минимальный размер
- Гарантированная читаемость
- Поточная обработка
- Точные координаты узлов
Просто tree-узел
Итак, нам нужно создать узел с именем «house». Какой минимальный код для этого нужен?
Просто пишем это имя и всё.
Список tree-узлов
А если нам нужен не один узел, а целый список?
Просто пишем их на отдельных строках.
Вложение tree-узлов
Но что если мы хотим добавить иерархичности и поместить список узлов внутрь первого?
Просто пишем вложенные узлы с табом в качестве отступа. Знакомые с языком Python тут могут заметить похожий подход — использование хорошего стиля форматирования кода в качестве основы синтаксиса, а не опциональной возможности.
Глубокая tree-иерархия
Продолжая добавлять отступы мы можем создавать иерархии любой вложенности.
Один дома
Часто бывают ситуации, когда вложенный узел только один и тогда увеличивать из-за него уровень отступа для всех вложенных в него узлов будет как-то расточительно.
Поэтому просто выстраиваем такие узлы в одну линию, разделяя пробелами.
Узлы же записанные с отступом уже вкладываются в последний узел на предыдущей линии.
Сырые данные
Когда же нам нужно записать произвольные данные, символы в которых не должны как-то по особому обрабатываться, просто пишем их после обратной косой черты без какого-либо экранирования.
Обратная косая черта выбрана для ассоциации с экранированием. Она как бы экранирует весь текст до конца строки. Но, если быть точными, то это скорее не экранирование, а своеобразные кавычки. Обратная косая черта — открывающая, а символ перевода строки — завершающая.
Многострочные данные
Но как записать всё же многострочный текст содержащий в том числе и символы перевода строки? Всё просто: берём узел данных и помещаем в него список других узлов данных.
При запросе строкового содержимого корневого узла данных все вложенные узлы данных будут соединены через символ перевода строки.
Разные типы узлов
Наконец, оба типа узлов мы можем использовать вперемешку в любых комбинациях. Например, опишем некоторого пользователя.
Как видите, всё довольно просто. Для создания самого продвинутого формата данных нам потребовалось всего 2 типа узлов и 4 спецсимвола.
Языки основанные на форматах
Пока что мы говорили лишь про форматы, то есть про способы сериализации. На их основе уже проектируются языки, добавляющие семантику абстрактным узлам формата.
| Формат | Языки |
|---|---|
| XML | XHTML, SVG, XSLT, . |
| JSON | JSON Schema, json:api, . |
| YAML | yaml.org/type |
| TOML | — |
| Tree | xml.tree, json.tree, view.tree, . |
Любой язык — это некоторое подмножество модели данных формата с ограничениями на возможные типы узлов, их взаимное расположение и содержимое.
Далее я покажу несколько примеров таких языков для формата tree.
Язык grammar.tree
Язык grammar.tree — предназначен для описания формальных грамматик. К примеру, давайте напишем полную формальную грамматику собственно формата tree.
Как видите, грамматика формата реально предельно простая, что позволяет буквально за час написать парсер на любом языке не прибегая даже к генераторам парсеров.
Читать такую грамматику можно буквально: tree — это опциональный список линий, а линия — это последовательность из опционального отступа, опционального списка узлов и обязательного символа перевода строки. Ну и так далее.
Язык grammar.tree vs EBNF
Сравнивая grammar.tree с Расширенной Формой Бэкуса Наура можно обратить внимание, что первый несколько многословен, но понятен и лаконичен, а последний — компактен, но для понимания требует предварительной подготовки, выразительные возможности всё же несколько уступают, а его ориентация на однострочное представление выглядит несколько неуклюже при многострочной записи.
Язык xml.tree vs XML
Язык xml.tree — это способ представления модели данных XML в tree формате. Из него можно генерировать любого вида XML. И наоборот, любой XML может быть сконвертирован в xml.tree.
Было бы классно иметь такую интеграцию в IDE, чтобы открывая любой XML можно было видеть и редактировать его xml.tree представление, но сохранялось бы всё обратно в XML. Это позволило бы больше не ломать глаза об амперсанды и позволило бы работать с XML так же легко и просто, как и, например, с markdown.
Язык json.tree vs JSON
А json.tree — это язык для описания модели json.
Нам потребовалось лишь 2 спецсимвола — звёздочка для обозначения словарей и косая черта для обозначения массивов.
Расширения json.tree
Прелесть языков, основанных на таких форматах как XML и Tree в том, что их легко расширять оставаясь в рамках формата. Например, и json, и tree как форматы принципиально не поддерживают комментарии. Но, например, в конфигах комментарии необходимы. Как же быть?
В tree мы легко расширили язык под наши нужды, добавив специальный тип узла для комментариев.
В JSON же сказывается ограниченность модели, из-за которой приходится писать костыли.
Язык view.tree vs TypeScript
Язык view.tree — используется для композиции компонент в разработанном мной фреймворке $mol.
Тут описан компонент, который владеет другим компонентом и их свойства двусторонне связаны друг с другом. Можете обратить внимание, что внутри view.tree используются в том числе и язык json.tree для описания массивов, словарей, чисел и прочих JSON типов.
Из такого простого и лаконичного кода генерируется довольно развесистый TypeScript класс. Писать его руками можно, но муторно и без иерархии не очень наглядно.
Наконец, есть различные API для взаимодействия с форматом из разных языков программирования.
| Формат | Языки | API |
|---|---|---|
| XML | XHTML, SVG, XSLT, . | DOM, SAX, AST |
| JSON | JSON Schema, json:api, . | Native, AST |
| YAML | yaml.org/type | Native, AST |
| TOML | — | Native, AST |
| Tree | xml.tree, json.tree, . | AST |
Для XML, например, есть довольно гибкий DOM, а есть низкоуровневый SAX. Форматы, пришедшие ему на смену, в основном возвращают нативные для языка словари, массивы и тд. Правда модель данных JSON не очень хорошо представляется в компилируемых языках, где целые числа и числа с плавающей точкой — это совершенно разные типы. Ну и разумеется для всех языков есть представление в виде Абстрактного Синтаксического Дерева. Правда обычно оно медленное и неудобное. Мы же сделаем это быстрым и удобным, что позволит нам не городить зоопарк несовместимых API.
JSON AST
Возьмём простой JSON файл и засунем его в ASTExplorer.
Как видно, AST получился большим и сложным. JSON вообще очень плохо подходит для описания AST. Без специальных утилит с ним работать не очень просто.
AST Tree
Теперь давайте возьмём несколько более сложный tree файл.
И посмотрим на его AST.
Так, что-то не так. Это же тот же самый код. А, нет, всё правильно, tree — сам себе AST.
Свойства узла Tree
В реализация на TypeScript каждый узел имеет примерно следующий интерфейс.
Span — это ссылка на серию байт в исходном ресурсе.
Производные Tree узлы
У каждого узла есть методы для создания новых узлов, на его основе. Эти фабрики, создавая новые узлы, просовывает в них span от оригинального узла. Это позволяет даже после десятков преобразований понять с чего всё началось.
Сообщения об ошибках в Tree
Для примера, возьмём конфиг, найдём в нём пароль и если он не подойдёт — кинем исключение, где будет написано в каком месте какого файла написан неправильный пароль.
Обработка Tree
Или другой пример — мы решили, что «auth» неудачное название и нужно заменить его на «credentials». Поэтому мы пишем не сложный скрипт для автоматического рефакторинга:
И таким образом вы можете легко рефакторить любые языки, основанные на tree формате, без поиска для каждого языка отдельного парсера и разбирательства с тем, как у него происходит работа с AST.
Поддержка редакторами
Если вы пользуетесь редактором для которого ещё нет плагина, то это хорошая возможность реализовать его. Сделать это будет проще, чем для любого другого языка.
Поддержка языками
Опять же, призываю заинтересовавшихся реализовать поддержку в своём любимом языке и попробовать применить его с пользой.
Итоги
| XML | JSON | YAML | TOML | Tree | |
|---|---|---|---|---|---|
| Размер | 195% | 140% | 125% | 110% | 100% |
| Число паттернов | 90 | 30 | 210 | 90 | 10 |
| Однозначный синтаксис | + | + | — | + | + |
| Удобочитаемость | — | — | + | + | + |
| Не нужно экранирование | — | — | — | — | + |
| Точные координаты узлов | — | — | — | — | + |
| Поточная обработка | — | — | + | + | + |
| Расширяемая модель данных | + | — | + | — | + |
| Широкая распространённость | + | + | + | — | — |
А теперь давайте пофантазируем, чего ещё интересного можно сделать используя tree формат.
- Запросы к СУБД
- Логирование
- Общение консольных утилит
- LISP-подобный язык
- Универсальный AST
sql.tree — запросы к СУБД
Помните неуклюжие запросы к MongoDB? Давайте попробуем написать свой SQL:
В такой форме запрос распарсить — плёвое дело, в отличие от настоящего SQL. Обратите внимание, что на единообразный синтаксис для логических операций и предикатов «равно», «больше» и даже «соответствует регулярке». Кстати, регулярку ведь тоже можно описать в формате tree, что сделает её куда более поддерживаемой.
domain.tree — описание домена
Раз уж мы заговорили о базах данных. Примерно так я описываю модель предметной области.
Из такого формального описания автоматически формируется серверный API, правила ACL, схема СУБД и админка для управления всем этим делом.
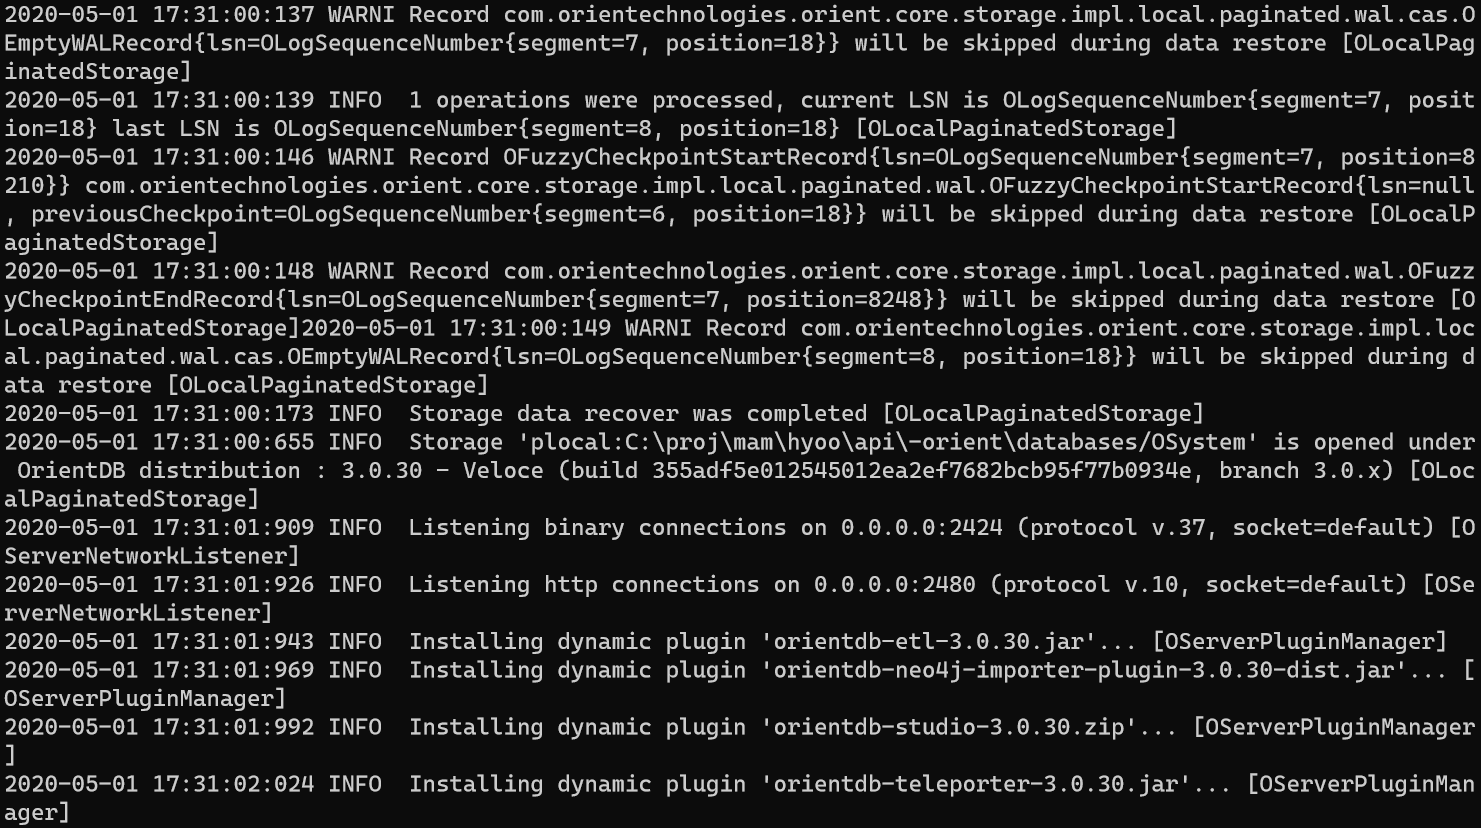
Распространённая практика выводить в логи однострочные сообщения. Пока они влезают по ширине в ваш терминал — всё хорошо, но это довольно редкая ситуация. Куда чаще сообщения всё же не влезают и начинают переноситься, превращая поток сообщений в настоящее месиво, которое и глазами сложно прочитать, да и программно обрабатывать их — боль и страдания.
access.log.tree — структурированные логи
А что если логи сразу выводить в двумерном виде, одновременно легко читаемом как машинами, так и человеком?
tree-tools — CLI утилиты обработки деревьев
Можно написать утилиты, которые бы позволили просто и эффективно обрабатывать такие логи. Например, прочитаем лог, отфильтруем по значению одного из полей, выберем из сообщений лишь интересные нам поля и выведем их табличкой.
У меня есть прототип такой утилиты, который я иногда использую для просмотра логов дев-сервера в реальном времени. Будет классно, если кто-то возьмётся реализовать полный комплект инструментария. А когда будут инструменты, тогда и у разработчиков софта будет мотивация писать логи не как попало, а структурированно.
tree как протокол общения
Можно пойти дальше и не просто писать логи в формате tree, а в принципе продвинуть идею, что вывод любой программы должен быть структурированным. У многих утилит есть флаги для вывода ответа в виде JSON или XML, но человеку читать такой вывод напряжно — приходится переоткрывать выдачу в инструментах наглядного представления, чтобы понять что там возвращается и как этому подступиться. Только представьте себе мир, где выдачу можно прочитать и тут же как-то её преобразовать, не ковыряя маны в поисках нужной комбинации ключей очередной программы.
WebAssembly — перспективный ассемблер, опускающийся настолько близко к машине на сколько это возможно без потери портабельности. Для него есть текстовый формат представления, основанный на лисповых s-expressions.
Его сложно воспринимать как ни форматируй. К сожалению, именно такого рода код вы будете видеть при дизассемблировании в браузерных девтулзах.
wasm.tree — ассемблер без мишуры
Я сейчас работаю над компилятором в байт коды более наглядного wasm.tree описания.
Из этого ассемблера генерится список байт-кодов на языке bin.tree, который уже элементарной функцией перегоняется в бинарник.
Когда будет что-то более-менее завершённое — попробую протолкнуть этот синтаксис в качестве WAT2.0. Кому не безразлична судьба WebAssembly — присоединяйтесь к разработке.
jack.tree — LISP без скобочек
На самом деле писать на сыром ассемблере слишком многословно. Поэтому следующим шагом идёт реализация мета-языка, позволяющего расширять язык средствами самого этого же языка. Ядро такого языка должно получиться предельно минималистичным, а все идиомы в него будут подключаться как сторонние библиотеки, написанные на этом же языке.
Грубо говоря, программа на этом языке итеративно модифицирует свой собственный AST таким образом, что на выходе получается wasm-бинарник. Звучит, возможно, пугающе, но благодаря тому, что tree сохраняет координаты исходников, проследить источник ошибки не составляет труда. В репозитории можно глянуть куцый прототип.
Упраздняя LLVM
Можно пойти ещё дальше и генерировать не wasm байткоды, а прямо таки байткоды целевого процессора, просто добавив ещё один трансформер в пайплайн.
При этом на любом уровне можно запускать дополнительные трансформеры, которые смогут оптимизировать код, применяя информацию, доступную на соответствующих уровнях абстракции.
При этом, напомню, мы не теряем связь с оригинальными исходниками, что позволит выводить адекватные сообщения. А любое промежуточное AST можно всегда сдампить в текст в весьма наглядной форме tree формата.
Опять же, присоединяйтесь к разработке, это может получиться крутая штука на замену LLVM.
Единый AST чтобы править всеми
Ну и, наконец, мы подошли ко главной мысли этого доклада. Tree — это прям идеальный кандидат на место универсального связующего AST. Вы только посмотрите, какой длинный пусть проходит TypeScript код от исходников до результирующего бандла при сборке на типичном проекте.
И каждый инструмент заново парсит ваши исходники в своё AST, обрабатывает, сериализует и передаёт далее. Если же договориться о едином формате AST, то можно значительно упростить реализацию утилит и снизить накладные расходы на обработку кода.
Даже если часть утилит будут запускаться в отдельных процессах (а значит промежуточная сериализация неизбежна), формат tree позволит передавать AST максимально быстро, за счёт минимальных накладных расходов на парсинг и сериализацию.
Куда пойти, куда податься
Надеюсь мне удалось заразить вас идеями о светлом будущем. Но чтобы его приблизить нам вместе надо над этим поработать. Один я, боюсь, всё это не вытяну. Так что пишите, зовите и не пропадайте.
Расширение файла TOML
TOML — это расширение файла, обычно связанное с файлами TOML Source Code Format. Файлы с расширением TOML могут использоваться программами, распространяемыми для платформы Linux, Mac OS, Windows. TOML файл относится к категории Файлы разработчика так же, как #NUMEXTENSIONS # других расширений файлов, перечисленных в нашей базе данных. Пользователям рекомендуется использовать Sublime Text программное обеспечение для управления TOML файлами, хотя 7 другие программы также могут обрабатывать этот тип файлов. Программное обеспечение Sublime Text было разработано Sublime HQ Pty Ltd, и на его официальном веб-сайте вы можете найти дополнительную информацию о файлах TOML или программном обеспечении Sublime Text.
Программы, которые поддерживают TOML расширение файла
В следующем списке перечислены программы, совместимые с файлами TOML, которые разделены на категории 3 в зависимости от операционной системы, в которой они доступны. Файлы с суффиксом TOML могут быть скопированы на любое мобильное устройство или системную платформу, но может быть невозможно открыть их должным образом в целевой системе.
Программы, обслуживающие файл TOML
 Windows
 MAC OS
 Linux
Updated: 08/26/2020
Как открыть файл TOML?
Причин, по которым у вас возникают проблемы с открытием файлов TOML в данной системе, может быть несколько. Что важно, все распространенные проблемы, связанные с файлами с расширением TOML, могут решать сами пользователи. Процесс быстрый и не требует участия ИТ-специалиста. Мы подготовили список, который поможет вам решить ваши проблемы с файлами TOML.
Шаг 1. Установите Sublime Text программное обеспечение
 Проблемы с открытием и работой с файлами TOML, скорее всего, связаны с отсутствием надлежащего программного обеспечения, совместимого с файлами TOML на вашем компьютере. Этот легкий. Выберите Sublime Text или одну из рекомендованных программ (например, PSPad, NotePad++ text editor, Atom) и загрузите ее из соответствующего источника и установите в своей системе. Выше вы найдете полный список программ, которые поддерживают TOML файлы, классифицированные в соответствии с системными платформами, для которых они доступны. Если вы хотите загрузить установщик Sublime Text наиболее безопасным способом, мы рекомендуем вам посетить сайт Sublime HQ Pty Ltd и загрузить его из официальных репозиториев.
Шаг 2. Убедитесь, что у вас установлена последняя версия Sublime Text
 Вы по-прежнему не можете получить доступ к файлам TOML, хотя Sublime Text установлен в вашей системе? Убедитесь, что программное обеспечение обновлено. Может также случиться, что создатели программного обеспечения, обновляя свои приложения, добавляют совместимость с другими, более новыми форматами файлов. Если у вас установлена более старая версия Sublime Text, она может не поддерживать формат TOML. Последняя версия Sublime Text должна поддерживать все форматы файлов, которые совместимы со старыми версиями программного обеспечения.
Шаг 3. Свяжите файлы TOML Source Code Format с Sublime Text
После установки Sublime Text (самой последней версии) убедитесь, что он установлен в качестве приложения по умолчанию для открытия TOML файлов. Следующий шаг не должен создавать проблем. Процедура проста и в значительной степени не зависит от системы
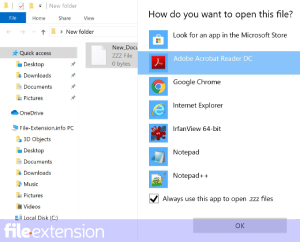
Процедура изменения программы по умолчанию в Windows
- Нажатие правой кнопки мыши на TOML откроет меню, из которого вы должны выбрать опцию Открыть с помощью
- Выберите Выбрать другое приложение → Еще приложения
- Чтобы завершить процесс, выберите Найти другое приложение на этом. и с помощью проводника выберите папку Sublime Text. Подтвердите, Всегда использовать это приложение для открытия TOML файлы и нажав кнопку OK .
Процедура изменения программы по умолчанию в Mac OS
- Щелкните правой кнопкой мыши на файле TOML и выберите Информация.
- Найдите опцию Открыть с помощью — щелкните заголовок, если он скрыт
- Выберите подходящее программное обеспечение и сохраните настройки, нажав Изменить все
- Должно появиться окно с сообщением, что это изменение будет применено ко всем файлам с расширением TOML. Нажимая Вперед , вы подтверждаете свой выбор.
Шаг 4. Убедитесь, что TOML не неисправен
Вы внимательно следили за шагами, перечисленными в пунктах 1-3, но проблема все еще присутствует? Вы должны проверить, является ли файл правильным TOML файлом. Отсутствие доступа к файлу может быть связано с различными проблемами.
1. TOML может быть заражен вредоносным ПО — обязательно проверьте его антивирусом.
Если файл заражен, вредоносная программа, находящаяся в файле TOML, препятствует попыткам открыть его. Рекомендуется как можно скорее сканировать систему на наличие вирусов и вредоносных программ или использовать онлайн-антивирусный сканер. Если файл TOML действительно заражен, следуйте инструкциям ниже.
2. Убедитесь, что файл с расширением TOML завершен и не содержит ошибок
Если файл TOML был отправлен вам кем-то другим, попросите этого человека отправить вам файл. Возможно, файл был ошибочно скопирован, а данные потеряли целостность, что исключает доступ к файлу. Это может произойти, если процесс загрузки файла с расширением TOML был прерван и данные файла повреждены. Загрузите файл снова из того же источника.
3. Проверьте, есть ли у пользователя, вошедшего в систему, права администратора.
Иногда для доступа к файлам пользователю необходимы права администратора. Переключитесь на учетную запись с необходимыми привилегиями и попробуйте снова открыть файл TOML Source Code Format.
4. Проверьте, может ли ваша система обрабатывать Sublime Text
Операционные системы могут иметь достаточно свободных ресурсов для запуска приложения, поддерживающего файлы TOML. Закройте все работающие программы и попробуйте открыть файл TOML.
5. Проверьте, есть ли у вас последние обновления операционной системы и драйверов
Современная система и драйверы не только делают ваш компьютер более безопасным, но также могут решить проблемы с файлом TOML Source Code Format. Возможно, что одно из доступных обновлений системы или драйверов может решить проблемы с файлами TOML, влияющими на более старые версии данного программного обеспечения.
Вы хотите помочь?
Если у Вас есть дополнительная информация о расширение файла TOML мы будем признательны, если Вы поделитесь ею с пользователями нашего сайта. Воспользуйтесь формуляром, находящимся здесь и отправьте нам свою информацию о файле TOML.