Хеш четкий и хеш нечеткий. Как средства защиты ловят и классифицируют малварь
На практике в большинстве случаев существующая база или ядро вредоноса повторно используется для создания новой разновидности малвари. Вирусописатели особо не заморачиваются с затратной по времени разработкой новых «качественных» вирусов, а просто используют имеющиеся образцы.
Этот повторно используемый код может быть собран заново с помощью другого компилятора, из него могут быть удалены или, наоборот, в него могут быть добавлены новые функции. Обновляются некоторые библиотеки, меняется распределение кода внутри файла (при этом применяются новые компоновщики, пакеры, обфускация и так далее). Смысл таких преобразований — придать хорошо знакомой антивирусу вредоносной программе новый вид. В этом случае видоизмененная версия вируса какое-то время останется необнаруженной. Тем не менее существуют способы детектирования такого рода переупаковок и модификаций.
Эти техники обнаружения зачастую используются для анализа большого массива данных и поиска в нем общих элементов. Практическими примерами использования похожих техник могут быть глобально распределенные базы знаний, такие как Virus Total и базы антивирусных компаний, а также подходы Threat Intelligence.
Хеш «четкий»
Ханс Петер Лун из IBM еще в 1940-е разрабатывал системы для анализа информации, в том числе исследовал вопросы хранения, передачи и поиска текстовых данных. Это привело его к созданию алгоритмов преобразования, а затем и к хешированию информации в качестве способа поиска телефонных номеров и текста. Так индексация и концепция «разделяй и властвуй» сделали свои первые шаги в области вычислительной техники.
Сейчас существует множество алгоритмов хеширования, отличающихся криптостойкостью, скоростью вычисления, разрядностью и другими характеристиками.
Мы привыкли ассоциировать хеш-функции с криптографическими хеш-функциями. Это распространенный инструмент, который используется для решения целого ряда задач, таких как:
- аутентификация;
- электронная подпись;
- обнаружение вредоносного ПО (как файлов, так и их маркеров компрометации).
В сегодняшней статье речь пойдет о том, как различные алгоритмы хеширования помогают нам бороться с зловредным ПО.
Что такое хеш
Криптографическая хеш-функция, чаще называемая просто хешем, — это математическое преобразование, переводящее произвольный входной массив данных в состоящую из букв и цифр строку фиксированной длины. Хеш считается криптостойким, если справедливо следующее:
- по хешу нельзя восстановить исходные данные;
- выполняется устойчивость к коллизиям, то есть невозможно получить из различных входных последовательностей одинаковые хеши.
MD5, SHA-1 и SHA-256 — наиболее популярные криптографические алгоритмы вычисления хеша, которые часто используются в детектировании вредоносного ПО. Еще совсем недавно вредонос опознавали только по сигнатуре (хешу) исполняемого файла.
Но в современных реалиях недостаточно знать просто хеш объекта, так как это слабый индикатор компрометации (IoC). IoC — это все артефакты, на основе которых может быть выявлен вредонос. Например, используемые им ветки реестра, подгружаемые библиотеки, IP-адреса, байтовые последовательности, версии ПО, триггеры даты и времени, задействованные порты, URL.
Рассмотрим «пирамиду боли» для атакующего, придуманную аналитиком в области информационной безопасности Дэвидом Бьянко. Она описывает уровни сложности индикаторов компрометации, которые злоумышленники используют при атаках. Например, если ты знаешь MD5-хеш вредоносного файла, его можно довольно легко и при этом точно обнаружить в системе. Однако это принесет очень мало боли атакующему — достаточно добавить один бит информации к файлу вредоноса, и хеш изменится. Таким образом вирус может переселяться бесконечно, и каждая новая его копия будет иметь отличный от других экземпляров хеш.

«Пирамида боли» Дэвида Бьянко
Другие статьи в выпуске: 
Xakep #258. NPM Hijacking
Если ты имеешь дело с множеством вредоносных образцов, становится понятно, что большинство из них по сути своей не уникальны. Злоумышленники нередко заимствуют или покупают исходники друг у друга и используют их в своих программах. Очень часто после появления в паблике исходных кодов какого-либо вредоносного ПО в интернете всплывают многочисленные поделки, состряпанные из доступных фрагментов.
Как же определить схожесть между разными образцами малвари одного семейства?
Для поиска такого сходства существуют специальные алгоритмы подсчета хеша, например нечеткое (fuzzy) хеширование и хеш импортируемых библиотек (imphash). Эти два подхода используют разные методы обнаружения для поиска повторно встречающихся фрагментов вредоносных программ, принадлежащих к определенным семействам. Рассмотрим эти два метода подробнее.
«Нечеткий» хеш — SSDeep
Если в криптографических хеш-функциях суть алгоритма состоит в том, что при малейшем изменении входных данных (даже одного бита информации) их хеш также значительно изменяется, то в нечетких хешах результат меняется незначительно или не изменяется вовсе. То есть нечеткие хеши более устойчивы к небольшим изменениям в файле. Поэтому подобные функции позволяют намного более эффективно обнаруживать новые модификации вредоносного ПО и не требуют больших ресурсов для расчета.
Нечеткое хеширование — это метод, при котором программа, такая как, например, SSDeep, вычисляет кусочные хеши от входных данных, то есть использует так называемое контекстно вызываемое кусочное хеширование. В англоязычных источниках этот метод называется context triggered piecewise hashing (CTPH aka fuzzy hashing).
На самом деле классификаций нечетких хешей довольно много. Например, по механизму работы алгоритмы делятся на piecewise hashing, context triggered piecewise hashing, statistically improbable features, block-based rebuilding. По типу обрабатываемой информации их можно разделить на побайтовые, синтаксические и семантические. Но если речь заходит о нечетких хешах, то это, как правило, CTPH.
Алгоритм SSDeep разработан Джесси Корнблюмом для использования в компьютерной криминалистике и основан на алгоритме spamsum. SSDeep вычисляет несколько традиционных криптографических хешей фиксированного размера для отдельных сегментов файла и тем самым позволяет обнаруживать похожие объекты. В алгоритме SSDeep используется механизм скользящего окна rolling hash. Его еще можно назвать рекурсивным кусочным хешированием.
Часто CTPH-подобные хеши лежат в основе алгоритмов локально чувствительных хешей — locality-sensitive hashing (LSH). В их задачи входит поиск ближайших соседей — approximate nearest neighbor (ANN), или, проще говоря, похожих объектов, но с чуть более высокоуровневой абстракцией. Алгоритмы LSH используются не только в борьбе с вредоносным ПО, но и в мультимедиа, при поиске дубликатов, поиске схожих генов в биологии и много где еще.
Алгоритм SSDeep
Как работает SSDeep? На первый взгляд, все довольно просто:
- он разделяет файл на более мелкие части и изучает их, а не файл в целом;
- он может определить фрагменты файлов, которые имеют последовательности одинаковых байтов, расположенных в схожем порядке, либо байты между двумя последовательностями, где они могут различаться как по значению, так и по длине.
Virus Total использует SSDeep, который выполняет нечеткое хеширование на загружаемых пользователями файлах. Пример — по ссылке.

Virus Total использует SSDeep
Итак, рубрика э-э-эксперименты! Возьмем по 18 образцов исполняемых файлов нашумевших вирусяк: среди них — MassLogger (имена образцов будут начинаться с аббревиатуры ML), Agent Tesla (AT) и Emotet (EMO). Только вот где мы найдем такое количество малвари? Да на базаре.
Теперь давай посмотрим, что же мы загрузили для испытаний. Agent Tesla — это .NET-кейлоггер и RAT, подробнее о нем рассказано вот в этой статье. Emotet — банковский троян с возможностью червеобразного распространения. При запуске сразу определяет, что работает не в виртуалке, иначе завершается. MassLogger, как и Agent Tesla, представляет собой кейлоггер. При этом он входит в топ-5 по популярности лета и осени 2020 года. Они оба используют механизм доставки вредоносных программ GuLoader, который загружает зашифрованную полезную нагрузку, лежащую на обычных платформах для обмена файлами.
Мы будем работать с .EXE-семплами, у каждого из испытуемых объектов уникальная криптографическая хеш-сумма SHA-1. Перечислим их все (команда для любителей Linux: shasum ML ):
f59a138da63769720e61e37fe52030774472db19 ML1.exe bd57fd4002228352bf60186562d0dde87f4f33e5 ML2.exe 89ebb9ff3ab6c9a3330e798036bb81cec29c417f ML3.exe e9029f66cc313a41b22cb922da7f52a899ac166c ML4.exe 1dde9710a0d780b42678f41bbc949c82f13a74af ML5.exe 8c635bc0aaf4214024cf7342d5f186ebf6171652 ML6.exe 3cb9d16fa0bf3d72f12bf844e0a293d818512c54 ML7.exe 619480abce06d5221c1dd430233fa19ff7f863b5 ML8.exe ab1aed403d37d2f90f2a59505b0724927790841e ML9.exe 65e9d26cf5e6742bdf0a772f6c9692ec533aded7 ML10.exe 3e5b239ddab79130b5b8ffe623c6272d365774d8 ML11.exe c53e68fe71b695e2c7fb6c05aedb422bf5856f7b ML12.exe 6c610f5675f7fb4d78ca2b6e4be9ff43ba47c929 ML13.exe 10cf5e8f60ddac43813e5b8880aa84805e4a30d8 ML14.exe d7a1665e425fe63054c5c836b3807f58da43948a ML15.exe 98e0a38ab5db61a6eb7b50f4e09556af7f46978d ML16.exe 2c2010e2fa02f4c70ea9dd5083026d0138f655d5 ML17.exe 67ee652bc805fc8f5c9c653785b4d82baae0f78e ML18.exe
С использованием SSDeep рассчитаем кусочный хеш каждого из файлов и сохраним результат в файле командой ssdeep MassLogger/* > ML.ssd . На выходе получим следующее:
24576: uf+B91xtspzq6wqAkSq+EQsnn3OF7dAhaG0K uUKp15AkSTsn3BH0K ML1.exe 24576: DoYHyzf8WEE0us0U5xDO/qLaVGbwfyXQHHNG ECcFEE0Px2qLaVuwagA ML2.exe 12288: OnaPI5TFAYwISkHXqrzcTo4BRzsWnLu8nbFNgreeWhBdgkuAgb6DxlPH9p+iq3T4 OnaQvwImc04Hdu8n5NgjMd26D3+lwt ML3.exe 12288: lDi43RqqJKN07vvaRfdjSGM/lBp62o53T7Q+Xu9BwckDj9F2Tzhs0kf3PYeD0d8t l2UTYy7vQaDiTXuvRMxF2xr6QeIdOV ML4.exe 24576: tGDh1aKoqw13WhVUSQK3+dUrSU4O5kddtp+Gyce 4Dx8h0USQKudUry0ite ML5.exe 12288: bOr02ehwuCC3t9DDnHSHoCdK5fskDfccfUt0IY81e0cXNi/Zb0kk1uuCucUXnwHY 6A2nuhe1dGPD06y0KbT/L8pnuusZdBE ML6.exe 24576: uA2nuhe1dGPD06y/C0UfDcBbcIt/nTh/WeFcLQ7 uvu8d8Aq+BR18eMQ7 ML7.exe 24576: 7Lo4IwxEo1796aAkBWvn7kGg9b5rrd9S/9+ 4nzamn7Hg9bJd92 ML8.exe 24576: NGDh1aKoqw13WhVUSM6j3xwra6hPG2VM+sJRcFpoprV89 YDx8h0USMU3xwO6NTsJymG ML9.exe 24576: KA2nuhe1dGPD06yxaG2acKrXOfIWkV353 Kvu8d8AqlhkV53 ML10.exe 24576: NGDh1aKoqw13WhVUS27LIQ/34mXyx7pxrkkQiD YDx8h0US273f4mXyBpxrkkQiD ML11.exe 24576: 2MOfNQm+7K/rTpVF2RiMKt34x/rrMt2I132fq 5uGKDrF2RiMW34/nf ML12.exe 24576: aA2nuhe1dGPD06yMSW+M8OxwhFTTLMyQkxN avu8d8AMS9MLwffMGxN ML13.exe 24576: dGDh1aKoqw13WhVUSDukbAEXF5Ujj1J21g IDx8h0USKkESqj1L ML14.exe 24576: CA2nuhe1dGPD06yg199oT5gzUmRVUhxfNw Cvu8d8Ag19q+Um0hxNw ML15.exe 12288: m5EaSrUQ9JakMtlDQ8zJQAqpLMyp84JiIQbTVru1YS+Fi75McDxH01YJf mGaSrUipM88zJ8My8IGTdSAil7tJ ML16.exe 24576: OD7tjHvlHj0eU30aD5Q6/0FW//V17rmBlKLsNTy4z OntjPlY3xluFw/V9rmOLsZR ML17.exe 12288: zOr02ehwuCC3t9DDnHSHoCdK5fskDfccfUtlLAQ8H5AbDarsd9Qg9Iu13SOMirut SA2nuhe1dGPD06ylLAQjbj9IyMira ML18.exe
Выглядит пугающе, правда? Давай сравним объекты между собой (в выводе мы предварительно удалили дубли, оставив уникальные совпадения между семплами). Для этого используем следующую команду:
В выводе команды правый столбец — процент совпадения между семплами.
| ML10.exe matches ML.ssd:ML13.exe | (49) | | ML10.exe matches ML.ssd:ML15.exe | (49) | | ML10.exe matches ML.ssd:ML18.exe | (49) | | ML10.exe matches ML.ssd:ML6.exe | (47) | | ML10.exe matches ML.ssd:ML7.exe | (49) | | ML11.exe matches ML.ssd:ML14.exe | (49) | | ML11.exe matches ML.ssd:ML5.exe | (54) | | ML11.exe matches ML.ssd:ML9.exe | (52) | | ML13.exe matches ML.ssd:ML15.exe | (50) | | ML13.exe matches ML.ssd:ML18.exe | (50) | | ML13.exe matches ML.ssd:ML6.exe | (50) | | ML13.exe matches ML.ssd:ML7.exe | (50) | | ML14.exe matches ML.ssd:ML5.exe | (47) | | ML14.exe matches ML.ssd:ML9.exe | (47) | | ML15.exe matches ML.ssd:ML18.exe | (49) | | ML15.exe matches ML.ssd:ML6.exe | (47) | | ML15.exe matches ML.ssd:ML7.exe | (46) | | ML18.exe matches ML.ssd:ML6.exe | (60) | | ML18.exe matches ML.ssd:ML7.exe | (49) | | ML5.exe matches ML.ssd:ML9.exe | (49) | | ML6.exe matches ML.ssd:ML7.exe | (55) |
Получается, что в исследуемых семплах присутствуют стабильно кочующие участки кода, которые обеспечивают схожесть. Поскольку такой вывод, скажем честно, малоинформативен, для наглядности изобразим связи в виде графа.

Связи исследуемых семплов
Из 18 объектов оказалось всего восемь никак не связанных между собой образцов, но это пока. Тем не менее можно смело утверждать, что мы выявили целое семейство вредоносов. Теперь протестируем остальные объекты из других групп и сравним результаты.
Сразу изобразим граф связности для образцов Agent Tesla. Не будем перечислять хеш-суммы образцов, а сразу приступим к сравнению: сначала файлов между собой, затем с семплами MassLogger.

Граф связности для образцов Agent Tesla
Для Agent Tesla также обнаружено два семейства взаимосвязанных семплов и десять воинов-одиночек. Что дальше? Сравним SSDeep-хеши MassLogger с объектами Emotet. Пусто, нет совпадений. А если с Agent Tesla? Строим граф.

Сравнение MassLogger с Agent Tesla
Бинго! Совпадения есть, и взаимопроникновение фрагментов кода семейств Agent Tesla и MassLogger доказано.
Однако не всегда у исследователя достаточно семплов и образцов вредоносов других семейств — например, для семейства Emotet. На графе видно, что из всех 18 объектов 13 так или иначе связаны между собой, а семплы EMO3, EMO9, EMO11, EMO15 и EMO18 не нашли «друзей», и их мы отражать на рисунке не станем.

Взаимосвязи объектов на графе
Итак, что же в итоге у нас получилось? У групп MassLogger есть пять объектов, связанных с объектами Agent Tesla. Почему так вышло? Во-первых, это два кейлоггера, у них есть пересечения в функциональности. Во-вторых, они оба используют один и тот же загрузчик. В каждом из тестов находились связи (то есть сходства) между объектами более чем на 50%. Иными словами, из 18 образцов так или иначе были связаны между собой как минимум девять. Среди семплов нашлись по меньшей мере две группы связанных объектов, а у Emotet — сразу три группы. Теперь давай рассмотрим другой тип хеш-функций, и, возможно, мы найдем новые взаимосвязи.
Хеш импортируемых библиотек — imphash
Imphash расшифровывается как import hash — «хеш импортов», то есть всех импортируемых программой библиотек, прописанных в исполняемом файле Windows Portable Executable (PE). Чтобы вычислить imphash, все импортированные библиотеки и связанные с ними функции выгружаются в строковом формате, объединяются, а затем криптографически хешируются. Virus Total также высчитывает по этому алгоритму хеш для PE-файлов.

Virus Total также использует imphash
Естественно, злоумышленники знают о таком алгоритме и могут его обойти, сделав свой вирус более модульным. Например, можно загружать каждый модуль в память только при необходимости или динамически загружать библиотеки, сохраняя объем импорта настолько малым, насколько позволяет компилятор. При этом любой импорт переносится в память только во время выполнения, а не транслируется в таблице импорта в PE-файле. Вирусы пишут люди, а люди — существа ленивые, нужно немного потрудиться, чтобы перевести работу программы в такой формат.
Перейдем к практике и найдем взаимосвязи среди наших исследуемых групп объектов. Начнем с MassLogger. Появились ли новые связи? Да, мы получили три группы связанных объектов — их imphash идентичны!

Три новые группы связанных объектов с общими imphash
Изобразим общие imphash файлов в виде графа. Тут со всеми объектами получается полносвязный граф, так что не суди строго, если какого-то ребра графа не будет! ��

Общие imphash файлов
Сравним с предыдущим графом из секции экспериментов с SSDeep.
Сравнение графов
Теперь объединим два получившихся графа в группы по их вершинам.

Объединим оба графа
Получается, что среди 18 образцов MassLogger не нашли себе «друзей» всего три объекта: ML1, ML2 и ML4, а это всего 17% от общего количества. Таким образом, используя две техники, мы выявили и подтвердили взаимосвязи вредоносных семплов и их «группировки».
Далее разберем остальные семейства вредоносных файлов. Agent Tesla по imphash разделился на две большие группы.

 Деление Agent Tesla по imphash
Сравним с предыдущим графом из секции тестов с SSDeep.
Сравнение графа с предыдущим
Объединим два получившихся графа в группы по их вершинам.

Объединяем два графа в группы по их вершинам
Imphash дополнил связи, которые были выявлены на этапе тестирования с SSDeep, и продемонстрировал более целостную картину. Идентичный с левой группой imphash присутствует в образцах группы MassLogger — ML5, ML9, ML11 и ML14.
Далее рассмотрим группу малвари Emotet.

 Группа Emotet
Сравни с предыдущим графом из секции тестов с SSDeep. Напомним, что семплы EMO3, EMO9, EMO11, EMO15 и EMO18 не нашли себе «друзей» в прошлом тесте.
Объединим два получившихся графа в группы по их вершинам.

Сравним графы, объединив их по вершинам
Опа! Недаром червь Emotet получил такое распространение. В наш тест попали довольно хитрые образцы, у которых, судя по всему, в явном виде не присутствует таблица импортов, а следовательно, отсутствует imphash. Скорее всего, в них используется одна из техник, которые мы перечисляли в разделе об этом типе хеширования.
Анализируя графы взаимосвязей, можно заметить, что благодаря комбинации imphash и SSDeep мы получили новые взаимосвязи между объектами, тем самым значительно расширив базу знаний об исследуемых образцах. И это знание позволяет с относительно малыми затратами эффективно дополнять сигнатурный анализ вредоносного ПО достаточно надежными отпечатками образцов по классу, семейству или типу малвари.
Борис Осепов
Специалист ИБ. Увлекаюсь средствами анализа вредоносного ПО. Люблю проверять маркетинговые заявления на практике 🙂
Архитектура децентрализованной рекомендующей системы, основанной на применении локально-чувствительного хеширования Текст научной статьи по специальности «Компьютерные и информационные науки»
Аннотация научной статьи по компьютерным и информационным наукам, автор научной работы — Пономарев Андрей Васильевич
Постановка проблемы: рекомендующие системы широко используются в современных системах электронной коммерции, помогая пользователям ориентироваться в многообразии предлагаемых товаров и услуг. Наибольшее распространение получили централизованные архитектуры построения таких систем. Однако централизация влечет за собой ряд недостатков, среди которых необходимость передачи пользователем сведений о предпочтениях стороне, осуществляющей эксплуатацию такой системы, и наличие единой точки отказа. Цель: построение децентрализованной рекомендующей системы , в которой для формирования рекомендаций используется сходство предпочтений пользователей ( коллаборативная фильтрация ), но полные сведения о предпочтениях хранятся только на узле, контролируемом самим пользователем, и не передаются другим узлам. Результаты: предложена архитектура децентрализованной рекомендующей системы , включающая структурированную одноранговую сеть , в которой каждый узел соответствует одному пользователю и хранит профиль его предпочтений, и специальный узел для информационного согласования участников сети. В качестве механизма, обеспечивающего, с одной стороны, поиск пользователей со схожими предпочтениями, а с другой стороны, ограниченное раскрытие информации о предпочтениях, используется локально-чувствительное хеширование . Для повышения уровня приватности пользователей в одноранговой сети применяется схема анонимизации. Практическая значимость: предложенный подход является достаточно универсальным и может быть использован для построения систем коллаборативной фильтрации в различных прикладных областях.
Похожие темы научных работ по компьютерным и информационным наукам , автор научной работы — Пономарев Андрей Васильевич
Decentralized Recommendation System Architecture Based on Locality-Sensitive Hashing
Purpose: Recommendation systems are widely used in modern e-commerce systems to help users make their ways in a vast variety of offered goods and services. Most of the modern recommendation system approaches are centralized. However, centralized recommendation have two primary disadvantages: the necessity for users to share their preferences and a single point of failure. The goal of this work is developing a decentralized recommendation system which employs user similarity ( collaborative filtering ) but holds all the user preferences only on the user’s network node. Results:An architecture is proposed for a decentralized recommendation system. It includes a structured peer-to-peer network in which each node corresponds to one user and stores this user’s preferences, and a special node used for the coordination of peer-to-peer nodes in some scenarios. To find users with similar interests and, in the same time, restrict the sharing of preferences, a locality-sensitive hashing is employed. For a higher level of privacy, the network uses an anonymization scheme. Practical relevance: The proposed approach is universal, as it relies only on ratings, and can be used to build collaborative filtering systems in various domains.
Текст научной работы на тему «Архитектура децентрализованной рекомендующей системы, основанной на применении локально-чувствительного хеширования»
АРХИТЕКТУРА ДЕЦЕНТРАЛИЗОВАННОЙ РЕКОМЕНДУЮЩЕЙ СИСТЕМЫ, ОСНОВАННОЙ НА ПРИМЕНЕНИИ ЛОКАЛЬНО-ЧУВСТВИТЕЛЬНОГО ХЕШИРОВАНИЯ
А. В. Пономарева, канд. техн. наук, старший научный сотрудник
аСанкт-Петербургский институт информатики и автоматизации РАН, Санкт-Петербург, РФ
Постановка проблемы: рекомендующие системы широко используются в современных системах электронной коммерции, помогая пользователям ориентироваться в многообразии предлагаемых товаров и услуг. Наибольшее распространение получили централизованные архитектуры построения таких систем. Однако централизация влечет за собой ряд недостатков, среди которых — необходимость передачи пользователем сведений о предпочтениях стороне, осуществляющей эксплуатацию такой системы, и наличие единой точки отказа. Цель: построение децентрализованной рекомендующей системы, в которой для формирования рекомендаций используется сходство предпочтений пользователей (коллаборативная фильтрация), но полные сведения о предпочтениях хранятся только на узле, контролируемом самим пользователем, и не передаются другим узлам. Результаты: предложена архитектура децентрализованной рекомендующей системы, включающая структурированную одноранговую сеть, в которой каждый узел соответствует одному пользователю и хранит профиль его предпочтений, и специальный узел для информационного согласования участников сети. В качестве механизма, обеспечивающего, с одной стороны, поиск пользователей со схожими предпочтениями, а с другой стороны, ограниченное раскрытие информации о предпочтениях, используется локально-чувствительное хеширование. Для повышения уровня приватности пользователей в одноранговой сети применяется схема анонимизации. Практическая значимость: предложенный подход является достаточно универсальным и может быть использован для построения систем коллаборативной фильтрации в различных прикладных областях.
Ключевые слова — локально-чувствительное хеширование, одноранговые сети, рекомендующие системы, коллаборативная фильтрация.
Большинство широко распространенных подходов к построению рекомендующих систем предполагают централизованную архитектуру. Важным достоинством централизации является существование широкого спектра техник моделирования предпочтений пользователей, предполагающих доступ к профилям всех пользователей (большинство реализаций метода ближайших соседей, разложение матрицы предпочтений и др.). Кроме того, при централизованном хранении информации о предпочтениях сторона, осуществляющая эксплуатацию рекомендующей системы, может производить всевозможные исследования этой информации, в том числе и не связанные напрямую с формированием рекомендаций.
Однако централизованная архитектура не свободна и от недостатков. Во-первых, в централизованных рекомендующих системах естественным образом возникает неоднозначная ситуация, касающаяся прав на информацию о предпочтениях. Как правило, пользователь не знает, какая именно информация о его действиях собирается, и не может извлечь (или уничтожить) эту информацию из системы. Более того, в случае прекращения функционирования сервиса, включавшего такую рекомендующую систему, соответ-
ствующая информация может быть безвозвратно утеряна. Во-вторых, централизация влечет за собой определенное разделение профиля пользователя. Пользователь может взаимодействовать с несколькими рекомендующими системами, предоставляя каждой лишь некоторые аспекты своих предпочтений. В результате предпочтения оказываются распределены между этими системами, хотя их консолидация могла бы улучшить качество рекомендаций. Наконец, централизация приводит к уменьшению надежности системы в целом за счет появления единой точки отказа, хотя в современных компьютерных системах этот недостаток в значительной мере ослабляется многоуровневыми схемами дублирования и репликации.
Децентрализация рекомендующей системы позволяет добиться двух важных целей:
— распределения функции формирования рекомендаций между пользователями и, как следствие, снятия необходимости в дорогостоящем сервере и повышения масштабируемости системы;
— повышения уровня приватности пользователей, поскольку исчезает необходимость в передаче предпочтений центральному серверу.
Есть несколько подходов к децентрализации рекомендующих систем. В этой статье развивается подход, в соответствии с которым пользователь хранит все сведения о предпочтениях только
на своем компьютере. Это полностью снимает упомянутую выше неоднозначную ситуацию, касающуюся прав на информацию о предпочтениях. Это также снимает проблему разделения профиля пользователя, поскольку все предпочтения сосредоточиваются на одном устройстве, контролируемом пользователем. При необходимости получения рекомендаций устройство посылает запросы на предоставление рекомендаций устройствам других пользователей.
И хотя в данном подходе устраняются все перечисленные недостатки централизованных рекомендующих систем, возникает и ряд трудностей. Главная проблема — ее решению посвящена и эта статья — состоит в реализации рекомендующего алгоритма, не требующего от пользователя передачи профиля своих предпочтений третьим лицам (участникам распределенной сети рекомендаций). Здесь следует сделать небольшое уточнение. Существует два основных класса рекомендующих систем: контентные системы и системы коллаборативной фильтрации. В контент-ных системах для формирования рекомендаций используются свойства самих объектов — система рекомендует объекты, похожие (с точки зрения некоторого формального представления) на те, что были полезны пользователю в прошлом. В системах же коллаборативной фильтрации сами свойства объектов не анализируются, система рекомендует те объекты, которые были высоко оценены пользователями, демонстрирующими схожие предпочтения. Конечно, трудности, связанные с децентрализацией, преимущественно касаются систем коллаборативной фильтрации, в основе которых лежит анализ сходства между пользователями, сопоставление их предпочтений, которое и осложняется распределенной организацией системы. Речь далее пойдет именно о таких системах, и под рекомендующей системой будет, если не оговорено иное, пониматься частный случай — система коллаборативной фильтрации.
В данной статье предложена архитектура рекомендующей системы, включающая структурированную одноранговую (P2P) сеть, в которой каждый узел соответствует одному пользователю и хранит профиль его предпочтений, и специальный узел для информационного согласования участников сети. Такой подход может быть классифицирован как гибридная одноранговая сеть, в которой часть функций выполняется исключительно посредством взаимодействия между равноправными узлами, а часть функций требует наличия специального узла. Предлагаемая архитектура обеспечивает ограниченное раскрытие предпочтений — не существует способа одновременно получить оценки, которые пользователь присвоил объектам, и сетевой адрес пользователя без глобального контроля над сетью.
Сама по себе задача построения рекомендующих систем, основанных на одноранговых сетях, не является новой. Существует определенный пласт работ, в которых эта задача ставится и предлагаются различные подходы к ее решению.
В системе P2Prec [1, 2] для распространения запросов и рекомендаций используется комбинация так называемого «дружеского» подхода к построению структуры сети (friend-of-a-friend), когда связи устанавливаются только между знакомыми пользователями, и лавинных алгоритмов распространения запросов.
В ряде описанных методов происходит построение оверлейной структуры, соответствующей близости интересов пользователей, поверх одноранговой сети [3, 4]. Рекомендации формируются поиском по оверлейной структуре на определенную глубину. Одним из распространенных алгоритмов такого «выравнивания» структуры сети под отношения между узлами является T-Man [5]. В данной работе сами оценки пользователя не раскрываются узлом сети, поэтому напрямую использовать T-Man или какой-либо схожий алгоритм нельзя из-за невозможности определить сходство узлов.
Другой подход заключается в применении алгоритмов случайного блуждания для поиска схожих узлов [6]. Для получения рекомендаций достаточно сформировать случайную выборку узлов сети, а затем использовать ближайшие, в соответствии с заданной мерой сходства, узлы из этой выборки [7].
Есть также работы, в которых авторы исследуют возможность применения структурированных одноранговых сетей для построения рекомендующих систем. Например, в работах [8, 9] оценки, присваиваемые объектам пользователями, сохраняются в распределенной хеш-таблице (Distributed Hash Table — DHT). Отличие предлагаемого в данной статье подхода заключается в том, что в распределенную хеш-таблицу помещаются не оценки, а сами узлы, и механизм быстрого поиска по этой таблице используется для поиска узлов, соответствующих пользователям со схожими интересами.
Формирование рекомендаций с помощью локально-чувствительного хеширования
(ЛЧХ) — это широко распространенный метод приближенного решения задачи поиска k ближайших соседей. Идея метода состоит в построении такой хеш-функции многомерных объектов, чтобы схожие объекты с высокой вероятностью получали одинаковое значение хеш-функции. Методы и алгоритмы поиска ближайших соседей находят широкое применение при построении
рекомендующих систем. Одним из основополагающих допущений коллаборативной фильтрации является представление о том, что пользователи, имевшие схожие предпочтения в прошлом, вероятно, имеют схожие предпочтения в настоящем, что может быть использовано при формировании рекомендаций. Если представить предпочтения пользователя в виде вектора и ввести соответствующую меру близости, то поиск пользователей со схожими интересами можно будет интерпретировать как поиск ближайших соседей.
В этом подразделе приводится формальное описание коллаборативной фильтрации, основанной на локально-чувствительном хешировании.
Описание базовых идей ЛЧХ приводится в соответствии с работой [10]. Пусть d1 < d2 — два значения расстояния в соответствии с некоторой мерой d. Семейство функций F называется (d1, d2, p1, р2)-чувствительным, если для каждой функции f в F:
— если d(a, b) < d1, то вероятность того, что f(a) = f(b), не меньше p1;
— если d(a, b) > d2, то вероятность того, что f(a) = f(b), не больше p2.
Важной идеей в теории ЛЧХ является усиление, в основе которого лежат понятия И-конструкции и ИЛИ-конструкции, определенные ниже.
Пусть задано (d1, d2, p1, р2)-чувствительное семейство функций F, новое семейство функций F' может быть получено посредством И-кон-струкции или ИЛИ-конструкции.
И-конструкция F' определяется следующим образом. Каждый член F' состоит из r членов F. Если f в F' и f получена из множества
ИЛИ-конструкция F' определяется следующим образом. Каждый член F' состоит из b членов F. Если f в F' и f получена из множества
Как правило, желательно, чтобы p1 было большим, насколько возможно, а p2 маленьким, насколько возможно. Если p1 < 1, то существует вероятность того, что схожие объекты будут иметь различные значения. С другой стороны, если p2 > 0, есть вероятность, что значительно различающиеся объекты получат одинаковое значение хеш-функции. Следовательно, семейство F следует выбирать таким образом, чтобы p1 было близко
к 1, а p2 близко к 0. Существует определенный набор хорошо изученных семейств локально-чувствительных функций, механизм усиления применяется в том случае, если только лишь средствами выбранного семейства не удается достичь желаемых вероятностей. Если семейство FAr получено И-конструкцией r функций из семейства F, а G затем получено ИЛИ-конструкцией b функций из семейства FAr, то G является (d1, d2, 1 — (1 — p1r)b, 1 — (1 — p2r)b)-чувствительным семейством. Неформально И-конструкция снижает изначально невысокую вероятность p2, а последующая ИЛИ-конструкция повышает изначально высокую вероятность p1.
Идея поиска ближайших соседей с помощью ЛЧХ описана, например, в работах [10, 11]. В первую очередь выбирается семейство F и создаются b обычных хеш-таблиц. Каждая таблица соответствует одной хеш-функции fAr, i = 1, . b, где fAi r — И-конструкция r случайных функций из F. Каждый объект x помещается в каждую из b хеш-таблиц. Ключом является значение функции fiAr(x), а значением — идентификатор объекта x или сам объект, в зависимости от задачи. При поиске ближайших соседей объекта y вычисляются fJAr(y), i = 1, . b; все объекты, извлеченные из хеш-таблиц по полученным ключам, образуют множество кандидатов. Реальная близость оценивается уже с применением строгой меры, и происходит отсев ложно-положительных соседей из множества кандидатов.
Выбор семейства хеш-функций зависит от представления данных и функции расстояния d. Для хеммингова расстояния, например, часто применяется хеш-функция, осуществляющая выборку отдельных битов [12], для косинусной меры — метод случайных проекций [13].
В данной работе используется метод случайных проекций, т. е. функция f из семейства F соответствует одной случайной гиперплоскости; функция принимает значение 1, если хешируе-мая точка находится над гиперплоскостью, и 0 в противном случае.
В системах коллаборативной фильтрации, основанных на сходстве пользователей (user-based collaborative filtering), рекомендации формируются с учетом того, в какой мере совпадают оценки пользователей, присвоенные одним и тем же объектам.
Формально, пусть ruj — оценка, присвоенная объекту j пользователем u и выражающая степень того, насколько пользователю u интересен объект j или какова субъективная ценность объекта j для пользователя u. Пусть U — множество пользователей; I — множество объектов; Iu — множество объектов, оцененных пользователем u;
1и1) — множество объектов, оцененных как пользователем и, так и пользователем V. Методы, основанные на сходстве, используют меру близости между пользователями, определяемую посредством сопоставления оценок, присвоенных пользователями одним и тем же объектам: (в1ш(и, V) = ^(<ги, ] е !ии>)), и пытаются предсказать неизвестную оценку ги на основе известных оценок г^ и сходства между пользователями
В данной статье используется косинусная мера сходства между пользователями:
Оценки пользователей нормализуются таким образом, что гиу = 1 соответствует строго положительному отношению пользователя и к объекту у, а гиу = -1 — строго отрицательному.
Рекомендующая система, использующая ЛЧХ, реализует поиск ближайших соседей. По известному набору значений хеш-функций для некоторого пользователя и система проверяет соответствующие хеш-таблицы и извлекает из них идентификаторы всех пользователей, чьи предпочтения вероятно похожи (в силу свойства хеш-функции) на предпочтения пользователя и. Затем может быть оценено точное сходство между пользователями, и объекты, высоко оцененные пользователями, похожими на и, будут рекомендованы и.
В предлагаемой системе точное значение сходства не вычисляется, поскольку это привело бы к раскрытию профиля пользователя. Вместо этого вводится приближенная мера сходства в'(и, V), определяемая как количество локально-чувствительных хеш-функций, чьи значения совпали для пользователей и и V. Алгоритм рекомендации, во-первых, осуществляет поиск всех пользователей Qu, которые могут быть соседями пользователя и, и вычисляет в'(и, V) (где V е Qu). Каждому из кандидатов V е Qu посылается запрос на список рекомендаций Яи. Предлагаемый алгоритм и система в целом предсказывают неизвестные оценки г^, вместо этого проводится ранжирование всех объектов, которые были рекомендованы кандидатами в соответствии с оценкой аи1 объекта I для пользователя и, определяемой выражением
Здесь Р.^ — индикаторная функция, осуществляющая проверку того, есть ли объект I в мно-
жестве объектов, рекомендованных пользователем V:
Таким образом, в предлагаемой архитектуре профиль пользователя и представляется множеством пар (¿, ги^), где I — идентификаторы объектов. Каждая из Ь локально-чувствительных хеш-функций представлена г векторами размерности (|/|). После применения всех этих хеш-функций получается Ь г-мерных бинарных векторов. Полученные векторы сохраняются в хеш-таблице. Во время формирования рекомендаций производится Ь операций поиска в хеш-таблице, а затем каждому «кандидату», извлеченному из хеш-таблицы, посылается запрос на формирование рекомендаций. Список рекомендаций упорядочивается по значению аи1 ■
Значения Ь и г являются параметрами алгоритма формирования рекомендаций. В разделе «Экспериментальное исследование» производится экспериментальная оценка того, как значения этих параметров влияют на качество рекомендаций.
Предлагаемая гибридная архитектура позволяет осуществлять обмен рекомендациями с ограниченным раскрытием предпочтений пользователя. В этом разделе описаны основные компоненты системы и сценарии их взаимодействия.
Предлагаемая система рассчитана на обеспечение двух вариантов использования: а) оценка потенциальной привлекательности объекта (или группы объектов) для данного пользователя; б) запрос рекомендаций.
Оценка потенциальной привлекательности объекта инициируется, когда необходимо проверить, может ли данный неизвестный объект быть интересен пользователю (с точки зрения логики, заложенной в систему). Пользователь передает системе идентификатор объекта, а рекомендующая система в ответ должна сообщить предполагаемую оценку привлекательности этого объекта для пользователя.
Запрос рекомендаций инициируется, когда необходимо сформировать набор новых, неизвестных пользователю объектов, которые могут оказаться ему интересны.
В соответствии с предлагаемым подходом рекомендующая система состоит из двух частей: одноранговой (Р2Р) сети рекомендаций и узла
■ Рис. 1. Связи между узлами в предлагаемой архитектуре
координации (рис. 1). Присутствие узла координации нарушает концептуальную чистоту одноранговой системы, превращая ее в гибридную, однако этот узел не играет важной роли в основных сценариях, перечисленных выше, его роль заключается в синхронизации вспомогательной информации между узлами сети.
Показаны два типа связей между узлами: связи между схожими узлами, образующими одноранговую сеть, отображены сплошными линиями; периодические связи узлов сети с узлом координации, устанавливаемые для обмена вспомогательной информацией, отображены пунктирными линиями.
1. Одноранговая сеть рекомендаций. В предлагаемом подходе каждый пользователь соответствует ровно одному узлу сети. На этом узле хранится вся информация о предпочтениях пользователя (в первую очередь, оценки объектов), причем узел не передает эту информацию другим узлам, он может передавать только значения локально-чувствительных хеш-функций, вычисленных от этой информации, для поиска схожих пользователей, к которым можно будет «обращаться» за получением рекомендаций.
Одноранговая сеть основана на использовании БНТ [14] — распространенном подходе к построению так называемых структурированных одноранговых сетей. БИТ — это класс систем, обеспечивающих хранение коллекции пар ключ — значение, распределенной по различным узлам сети, с учетом миграции фрагментов при выходе узла из состава сети.
Классические реализации подхода БИТ обладают рядом уязвимостей. Для их преодоления разработано несколько анонимизированных реализаций БИТ. Предлагаемая архитектура основывается на Окорив [15] — одной из таких ано-нимизированных реализаций. В основе таких реализаций, как правило, лежит идея построения цепочек анонимизации вместо непосредственного обращения к другому узлу сети, причем каждый узел, лежащий в такой цепочке, имеет
информацию только о соседних узлах цепочки. Таким образом, становится значительно сложнее установить, от какого же именно узла исходил запрос.
В предлагаемой системе БИТ используется для хранения хеш-таблиц, применяемых в целях поиска ближайших соседей, как описано в предыдущем разделе. Каждая пара ключ — значение, хранимая в БИТ, содержит информацию об одном значении локально-чувствительной хеш-функции и список узлов, соответствующих этому значению. Как уже указывалось, для поиска ближайших соседей необходимо несколько (Ь) хеш-таблиц. Каждая из Ь таблиц использует свою локально-чувствительную хеш-функцию. В данной системе предлагается хранить все Ь хеш-таблиц в одной БИТ. Для этого ключ должен включать в себя уникальный идентификатор локально-чувствительной хеш-функции и значение этой функции.
Перед тем как включить записи в БИТ, узел создает анонимизированную цепочку и использует спецификатор окончания этой цепочки как свой адрес, передаваемый другим узлам. Эти анонимизированные пути создаются при каждом очередном подключении узла к сети заново, следовательно, во время каждой новой сессии у узла оказывается новый внешний идентификатор.
Поскольку предпочтения пользователя, выраженные в оценках, присвоенных этим пользователем различным объектам, достаточно статичны, предполагается хранение ссылок на внешние «публичные» идентификаторы узлов, соответствующих пользователям со схожими интересами. Таким образом, поверх одноранговой сети образуется оверлейная сеть, сформированная ссылками между узлами пользователей со схожими интересами. Следует иметь в виду, что ссылки между вершинами в этой оверлейной сети являются не идентификаторами узлов Р2Р-сети, а «входами» в анонимизированные пути, ведущие к ним.
2. Узел координации. Распределенный характер предлагаемой системы является причиной следующей технической сложности. Для корректного вычисления локально-чувствительных хеш-функций необходимо, чтобы сами хеш-функции (т. е. гиперплоскости, которыми они представляются) были одинаковы на всех узлах. Для согласования параметров этих функций все узлы сети должны использовать один и тот же порядок следования объектов, поскольку размерность гиперплоскостей совпадает с количеством объектов и с длиной вектора пользовательских оценок. Задача поддержания глобального состояния в одноранговой сети является нетривиальной [16-18]. В предлагаемой системе для ее решения используется подход, схожий с предложенным
в статье [19] и заключающийся в отказе от чисто однорангового устройства сети. Задачей узла координации является сбор всех объектов (о которых сообщают пользователи), поддержка отношения порядка между их идентификаторами и генерация локально-чувствительных функций. Таким образом, каждый узел должен соединиться с узлом координации для двух целей: во-первых, для регистрации нового, ранее неизвестного объекта; во-вторых, для получения нового набора локально-чувствительных хеш-функций. Следует заметить, что нет необходимости генерировать новый набор хеш-функций после обнаружения каждого нового объекта. При использовании «устаревшего» набора функций получение рекомендаций оказывается возможным, но их качество постепенно ухудшается с ростом расхождения между используемым и актуальным наборами. Таким образом, каждый узел накапливает новые объекты, посылает накопленный пакет объектов узлу координации, а в ответ получает обновленный набор хеш-функций.
Экспериментальное исследование предлагаемого подхода было произведено с использованием набора данных MovieLens 100k, выложенного в открытый доступ исследовательской лабораторией GroupLens Research [20]. Этот набор содержит 100 000 оценок, присвоенных 943 пользователями 1682 фильмам.
В ходе экспериментального исследования преследовались две цели. Во-первых, получить практическую информацию о количественных характеристиках подхода и оценить временную и пространственную сложность рекомендующих систем, основанных на ЛЧХ в DHT-сетях. Во-вторых, оценить качество рекомендаций по сравнению с широко распространенными альтернативными алгоритмами.
Временная и пространственная сложность
Как уже было отмечено, параметрами предлагаемого алгоритма формирования рекомендаций являются b (количество хеш-функций) и r (количество гиперплоскостей в каждой функции). Значения этих параметров оказывают существенное влияние как на время получения рекомендаций, так и на их качество.
Каждый узел помещает информацию о себе DHT b раз (по одному значению каждой из хеш-функций), следовательно, размер DHT равен Nb, где N — количество узлов, а это означает, что в среднем в узле размещено b записей DHT.
Поиск ближайших соседей требует b операций извлечения из хеш-таблицы, а значит, требует O(b log(N)) взаимодействий между узлами.
Хэширование в строковых задачах
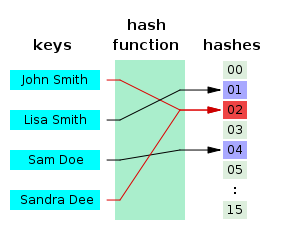
Хэш — это какая-то функция, сопоставляющая объектам какого-то множества числовые значения из ограниченного промежутка.
- Быстро считается — за линейное от размера объекта время;
- Имеет не очень большие значения — влезающие в 64 бита;
- «Детерминированно-случайная» — если хэш может принимать \(n\) различных значений, то вероятность того, что хэши от двух случайных объектов совпадут, равна примерно \(\frac<1>
\) .
Обычно хэш-функция не является взаимно однозначной: одному хэшу может соответствовать много объектов. Такие функции называют сюръективными.
Для некоторых задач удобнее работать с хэшами, чем с самими объектами. Пусть даны \(n\) строк длины \(m\) , и нас просят \(q\) раз проверять произвольные две на равенство. Вместо наивной проверки за \(O(q \cdot n \cdot m)\) , мы можем посчитать хэши всех строк, сохранить, и во время ответа на запрос сравнивать два числа, а не две строки.
Применения в реальной жизни
- Чек-суммы. Простой и быстрый способ проверить целостность большого передаваемого файла — посчитать хэш-функцию на стороне отправителя и на стороне получателя и сравнить.
- Хэш-таблица. Класс unordered_set из STL можно реализовать так: заведём \(n\) изначально пустых односвязных списков. Возьмем какую-нибудь хэш-функцию \(f\) с областью значений \([0, n)\) . При обработке .insert(x) мы будем добавлять элемент \(x\) в \(f(x)\) -тый список. При ответе на .find(x) мы будем проверять, лежит ли \(x\) -тый элемент в \(f(x)\) -том списке. Благодаря «равномерности» хэш-функции, после \(k\) добавлений ожидаемое количество сравнений будет равно \(\frac
\) = \(O(1)\) при правильном выборе \(n\) . - Мемоизация. В динамическом программировании нам иногда надо работать с состояниями, которые непонятно как кодировать, чтобы «разгладить» в массив. Пример: шахматные позиции. В таком случае нужно писать динамику рекурсивно и хранить подсчитанные значения в хэш-таблице, а для идентификации состояния использовать его хэш.
- Проверка на изоморфизм. Если нам нужно проверить, что какие-нибудь сложные структуры (например, деревья) совпадают, то мы можем придумать для них хэш-функцию и сравнивать их хэши аналогично примеру со строками.
- Криптография. Правильнее и безопаснее хранить хэши паролей в базе данных вместо самих паролей — хэш-функцию нельзя однозначно восстановить.
- Поиск в многомерных пространствах. Детерминированный поиск ближайшей точки среди \(m\) точек в \(n\) -мерном пространстве быстро не решается. Однако можно придумать хэш-функцию, присваивающую лежащим рядом элементам одинаковые хэши, и делать поиск только среди элементов с тем же хэшом, что у запроса.
Хэшируемые объекты могут быть самыми разными: строки, изображения, графы, шахматные позиции, просто битовые файлы.
Сегодня же мы остановимся на строках.
Полиномиальное хэширование
Лайфхак: пока вы не выучили все детерминированные строковые алгоритмы, научитесь пользоваться хэшами.
Будем считать, что строка — это последовательность чисел от \(1\) до \(m\) (размер алфавита). В C++ char это на самом деле тоже число, поэтому можно вычитать из символов минимальный код и кастовать в число: int x = (int) (c — ‘a’ + 1) .
Определим прямой полиномиальный хэш строки как значение следующего многочлена:
\[ h_f = (s_0 + s_1 k + s_2 k^2 + \ldots + s_n k^n) \mod p \]
Здесь \(k\) — произвольное число больше размера алфавита, а \(p\) — достаточно большой модуль, вообще говоря, не обязательно простой.
Его можно посчитать за линейное время, поддерживая переменную, равную нужной в данный момент степени \(k\) :
Можем ещё определить обратный полиномиальный хэш:
\[ h_b = (s_0 k^n + s_1 k^
Его преимущество в том, что можно написать на одну строчку кода меньше:
Автору проще думать об обычных многочленах, поэтому он будет везде использовать прямой полиномиальный хэш и обозначать его просто буквой \(h\) .
Зачем это нужно?
Используя тот факт, что хэш это значение многочлена, можно быстро пересчитывать хэш от результата выполнения многих строковых операций.
Например, если нужно посчитать хэш от конкатенации строк \(a\) и \(b\) (т. е. \(b\) приписали в конец строки \(a\) ), то можно просто хэш \(b\) домножить на \(k^<|a|>\) и сложить с хэшом \(a\) :
Удалить префикс строки можно так:
А суффикс — ещё проще:
В задачах нам часто понадобится домножать \(k\) в какой-то степени, поэтому имеет смысл предпосчитать все нужные степени и сохранить в массиве:
Как это использовать в реальных задачах? Пусть нам надо отвечать на запросы проверки на равенство произвольных подстрок одной большой строки. Подсчитаем значение хэш-функции для каждого префикса:
Теперь с помощью этих префиксных хэшей мы можем определить функцию, которая будет считать хэш на произвольном подотрезке:
Деление по модулю возможно делать только при некоторых k и mod (а именно — при взаимно простых). В любом случае, писать его долго, и мы это делать не хотим.
Для нашей задачи не важно получать именно полиномиальный хэш — главное, чтобы наша функция возвращала одинаковый многочлен от одинаковых подстрок. Вместо приведения к нулевой степени приведём многочлен к какой-нибудь достаточно большой — например, к \(n\) -ной. Так проще — нужно будет домножать, а не делить.
Теперь мы можем просто вызывать эту функцию от двух отрезков и сравнивать числовое значение, отвечая на запрос за \(O(1)\) .
Упражнение. Напишите то же самое, но используя обратный полиномиальный хэш — этот способ тоже имеет право на существование, и местами он даже проще. Обратный хэш подстроки принято считать и использовать в стандартном виде из определения, поскольку там нет необходимости в делении.
Лайфхак. Если взять обратный полиномиальный хэш короткой строки на небольшом алфавите с \(k=10\) , то числовое значение хэша строки будет наглядно соотноситься с самой строкой:
Этим удобно пользоваться при дебаге.
Примеры задач
Количество разных подстрок. Посчитаем хэши от всех подстрок за \(O(n^2)\) и добавим их все в std::set . Чтобы получить ответ, просто вызовем set.size() .
Поиск подстроки в строке. Можно посчитать хэши от шаблона (строки, которую ищем) и пройтись «окном» размера шаблона по тексту, поддерживая хэш текущей подстроки. Если хэш какой-то из этих подстрок совпал с хэшом шаблона, то мы нашли нужную подстроку. Это называется алгоритмом Рабина-Карпа.
Сравнение строк (больше-меньше, а не только равенство). У любых двух строк есть какой-то общий префикс (возможно, пустой). Сделаем бинпоиск по его длине, а дальше сравним два символа, идущие за ним.
Палиндромность подстроки. Можно посчитать два массива — обратные хэши и прямые. Проверка на палиндром будет заключаться в сравнении значений hash_substring() на первом массиве и на втором.
Количество палиндромов. Можно перебрать центр палиндрома, а для каждого центра — бинпоиском его размер. Проверять подстроку на палиндромность мы уже умеем. Как и всегда в задачах на палиндромы, случаи четных и нечетных палиндромов нужно обрабатывать отдельно.
Хранение строк в декартовом дереве
Если для вас всё вышеперечисленное тривиально: можно делать много клёвых вещей, если «оборачивать» строки в декартово дерево. В вершине дерева можно хранить символ, а также хэш подстроки, соответствующей её поддереву. Чтобы поддерживать хэш, нужно просто добавить в upd() пересчёт хэша от конкатенации трёх строк — левого сына, своего собственного символа и правого сына.
Имея такое дерево, мы можем обрабатывать запросы, связанные с изменением строки: удаление и вставка символа, перемещение и переворот подстрок, а если дерево персистентное — то и копирование подстрок. При запросе хэша подстроки нам, как обычно, нужно просто вырезать нужную подстроку и взять хэш, который будет лежать в вершине-корне.
Если нам не нужно обрабатывать запросы вставки и удаления символов, а, например, только изменения, то можно использовать и дерево отрезков вместо декартова.
Вероятность ошибки и почему это всё вообще работает
У алгоритмов, использующих хэширование, есть один неприятный недостаток: недетерминированность. Если мы сгенерируем бесконечное количество примеров, то когда-нибудь нам не повезет, и программа отработает неправильно. На CodeForces даже иногда случаются взломы решений, использующих хэширование — можно в оффлайне сгенерировать тест против конкретного решения.
Событие, когда два хэша совпали, а не должны, называется коллизией. Пусть мы решаем задачу определения количества различных подстрок — мы добавляем в set \(O(n^2)\) различных случайных значений в промежутке \([0, m)\) . Понятно, что если произойдет коллизия, то мы какую-то строку не учтем и получим WA. Насколько большим следует делать \(m\) , чтобы не бояться такого?
Выбор констант
Практическое правило: если вам нужно хранить \(n\) различных хэшей, то безопасный модуль — это число порядка \(10 \cdot n^2\) . Обоснование — см. парадокс дней рождений.
Не всегда такой можно выбрать один — если он будет слишком большой, будут происходить переполнения. Вместо этого можно брать два или даже три модуля и считать много хэшей параллельно.
Можно также брать модуль \(2^<64>\) . У него есть несколько преимуществ:
- Он большой — второй модуль точно не понадобится.
- С ним ни о каких переполнениях заботиться не нужно — если все хранить в unsigned long long , процессор сам автоматически сделает эти взятия остатков при переполнении.
- С ним хэширование будет быстрее — раз переполнение происходит на уровне процессора, можно не выполнять долгую операцию % .
Всё с этим модулем было прекрасно, пока не придумали тест против него. Однако, его добавляют далеко не на все контесты — имейте это в виду.
В выборе же \(k\) ограничения не такие серьезные:
- Она должна быть чуть больше размера словаря — иначе можно изменить две соседние буквы и получить коллизию.
- Она должна быть взаимно проста с модулем — иначе в какой-то момент всё может занулиться.
Главное — чтобы значения \(k\) и модуля не знал человек, который генерирует тесты.
Парадокс дней рождений
В группе, состоящей из 23 или более человек, вероятность совпадения дней рождения хотя бы у двух людей превышает 50%.
Более общее утверждение: в мультимножество нужно добавить \(\Theta(\sqrt
Первое доказательство (для любителей матана). Пусть \(f(n, d)\) это вероятность того, что в группе из \(n\) человек ни у кого не совпали дни рождения. Будем считать, что дни рождения распределены независимо и равномерно в промежутке от \(1\) до \(d\) .
\[ f(n, d) = (1-\frac<1>
Попытаемся оценить \(f\) :
Из последнего выражения более-менее понятно, что вероятность \(\frac<1><2>\) достигается при \(n \approx \sqrt
Второе доказательство (для любителей теорвера). Введем \(\frac
Обозначим за \(X\) число совпавших дней рождений. Его ожидание равно сумме ожиданий этих индикаторов, то есть \(\frac
Отсюда понятно, что если \(d = \Theta(n^2)\) , то ожидание равно константе, а если \(d\) асимптотически больше или меньше, то \(X\) стремится нулю или бесконечности соответственно.
Примечание: формально, из этого явно не следует, что вероятности тоже стремятся к 0 и 1.
Бонус: «мета-задача»
Дана произвольная строка, по которой известным только авторам задачи способом генерируется ответ yes/no. В задаче 100 тестов. У вас есть 20 попыток отослать решение. В качестве фидбэка вам доступны вердикты на каждом тесте. Вердиктов всего два: OK (ответ совпал) и WA. Попытки поделить на ноль, выделить терабайт памяти и подобное тоже считаются как WA.