Как разогнать процессор на Андроиде
Как разогнать процессор на Андроиде. Наверняка многие пользователи устройств на Андроид сталкивались с вопросом быстродействия системы. Например, планшет может не справляться с несколькими одновременно запущенными приложениями, или в свежеустановленной игре начинает тормозить графика. Помимо объёма оперативной памяти, на эти показатели существенно влияет тактовая частота процессора вашего устройства. Лучше всего для разгона подходят сторонние приложения
Даже если некоторое время назад ваш Android-планшет был флагманом в своей нише, прогресс не стоит на месте, и новые программы и игры требуют всё больше и больше ресурсов оборудования. С другой стороны, это ещё не повод менять устройство на более быстрое (и дорогое!), поэтому есть смысл подумать о разгоне процессора.
Содержание:
Повышение частоты процессора с помощью программ
Для этой процедуры разработаны специальные приложения, их можно найти и скачать в Google Play или на нашем сайте. Программы для Андроид, на примере которых мы расскажем, как разогнать ЦП, довольно просты в использовании, но для их корректной работы нужны root-права — права суперпользователя, позволяющие менять инженерные настройки, доступ к которым обычно ограничен для пользователей.
Программа AnTuTu CPU Master
Доступна на Google Play как в платной, так и в бесплатной версии. Функционал первой немного шире, но для нашей основной задачи вполне подойдёт и бесплатный вариант — скачать AnTuTu CPU Master . После установки и запуска программы мы сразу же видим главное окно.
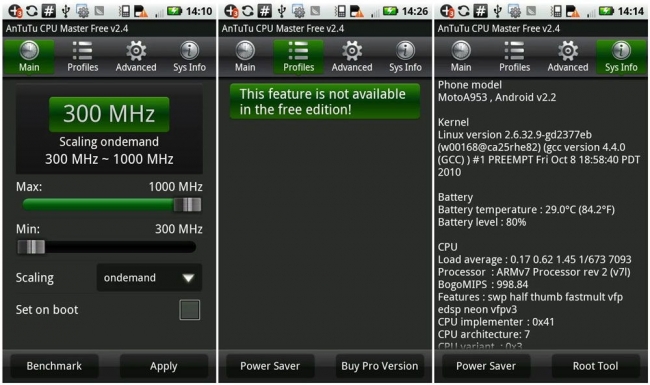
Значение на зелёном фоне — это текущая частота. Ниже расположены ползунки, регулирующие максимальное и минимальное значения. Чтобы ускорить работу операционной системы в целом, нужно увеличить минимальное значение частоты. Максимальное число эта программа поменять не сможет.
После установки нужных значений необходимо сохранить настройки и перезагрузить планшет, чтобы применить их.
SetCPU
Аналогичным образом работает и приложение SetCPU для Android. При его запуске мы видим две кнопки: стандартный разгон ЦП и переход в расширенные настройки. Основная функция реализована примерно так же, как и в предыдущем примере: значение текущей частоты, меняющееся в реальном времени по мере запуска или остановки каких-либо процессов, и возможность регулировки пороговых значений.
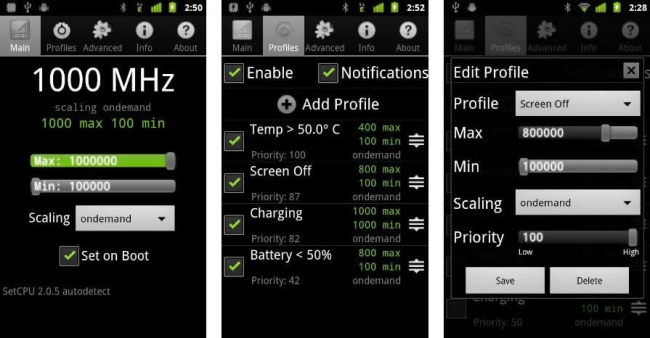
Кроме этого, программа SetCPU имеет ещё несколько сопутствующих полезных функций. В ней можно не только разогнать, но и создать профили частоты, которые будет использовать процессор. Вы сможете при необходимости переключаться между заранее сохранёнными профилями, а также задавать смену профиля в зависимости от условий использования: например, снижать частоту при низком заряде батареи.
Пользоваться расширенными функциями этой программы лучше только опытным пользователям Андроид, поскольку регулировать уровень энергопотребления для каждой конкретной частоты возможно, только если пользователь отдаёт себе отчёт в том, к чему может привести каждое его действие.
За и против разгона процессора
К плюсам этой процедуры можно отнести:
- несомненно, повышение производительности и быстродействия устройства;
- быструю и плавную работу ресурсоёмких игр и программ.
Но есть и некоторые минусы, которые могут сделать работу вашего планшета менее комфортной:
- увеличение частоты неизбежно приведёт к повышению энергопотребления, поэтому будьте готовы к непривычно быстрой разрядке батареи;
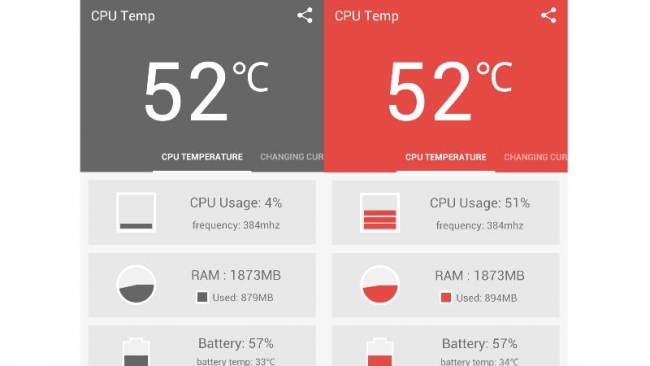
- также повысится теплоотдача, то есть устройство будет греться сильнее обычного, даже при не очень высокой загрузке.
Меры предосторожности при разгоне процессора
Помните — каждое устройство индивидуально, и прежде чем думать о разгоне ЦП на Андроид, поищите информацию, касающуюся вашей модели: может быть, именно ее разогнать не получится. Например, если ваш планшет снабжён одноядерным процессором с невысокой частотой, то его разгон не даст заметных результатов. В целом разумное повышение должно составлять не более 20–25% от первоначальной цифры. Неоправданно высокие значения могут повредить вашему устройству.
Разгон процессора в любом случае приведёт к сокращению времени автономной работы устройства: работая на высокой частоте, процессор будет расходовать больше энергии. Впрочем, у этого фактора есть и другая сторона: с помощью этих же программ вы можете продлить время работы батареи, если понизите пороговые значения частоты. Это актуально для тех, кто не пользуется ресурсоёмкими программами, нечасто играет в игры, но высоко ценит автономность. Ведь большинство стандартных процессоров на наших Андроид-устройствах вполне способно работать на средних значениях частоты без всякого разгона.
Заключение
Итак, если вы приняли решение ускорить работу своего устройства, любая из вышеописанных программ поможет вам в этом — конечно, при условии наличия root-прав . Более того, они могут быть полезными даже для тех, кто не решится на эту процедуру: ведь с их помощью можно не только повышать, но и понижать частоту, тем самым экономя расход энергии.
Как увеличить производительность процессора на компьютере? Способы

Производительность — один из важнейших параметров компьютера. Он означает, насколько быстро устройство будет выполнять отдаваемые пользователем команды. Зачастую этот параметр сильнее всего обусловливается комплектующими компьютера. К примеру, два компьютера, имеющие одинаковый процессор, но разные объемы оперативной памяти, будут иметь разную производительность.
В обыкновенной работе ПК разница в производительности может быть не слишком заметна. Однако она играет решающую роль для людей, работающих с большим количеством программ, а также в различных играх. Чем быстрее откликается на действия компьютер, тем меньше задержка в игре, тем реже игра зависает и быстрее запускается. Особенно это важно и заметно в мультиплеерных играх, когда скорость реакции как человека, так и устройства играет зачастую ключевую роль.
Итак, как же увеличить производительность процессора? Для начала нужно узнать ее текущее значение.
Как узнать производительность ПК
В основном этот параметр измеряется каким-либо числом, которое чем больше, тем лучше. Есть много различных способов узнать производительность компьютера. Можно, к примеру, воспользоваться программами, которые во множестве существуют на просторах Интернета. Также в операционной системе Windows можно посмотреть индекс производительности.
Для этого нужно зайти в панель управления и найти там вкладку «Система и безопасность». В ней нужно выбрать «Система». В этой вкладке можно узнать основные параметры компьютера, в которые входит индекс производительности. Его можно проверить. Результаты сохраняются.

В качестве итоговой оценки система всегда выбирает наименьшее значение из показателей всех компонентов. В процессе апгрейда своего устройства желательно периодически проверять этот показатель, для того чтобы знать, как ПК реагирует на то или иное действие.
Итак, с местонахождением данных о производительности все понятно. Какие есть способы увеличить производительность процессора? Их несколько, и стоит подробно рассмотреть каждый.
Как увеличить производительность процессора на ноутбуке и ПК
Для увеличения производительности устройства можно воспользоваться несколькими способами.
Начать нужно с проверки системы на вирусы. Очень часто бывает так, что где-нибудь в уголке сидит вирус и по чуть-чуть «подъедает» производительность. Для этого можно воспользоваться любым хорошим антивирусом.
Если это не помогло, увеличить производительность можно, используя разгон процессора либо при помощи настроек ПК, очистки ОЗУ и прочего. Для начала: что такое разгон? Чтобы объяснить это понятие, нужно сказать, что у каждого процессора есть определенная частота, на которой он работает. Частота измеряется в герцах и является основной характеристикой процессора. При помощи некоторых манипуляций можно увеличить частоту, на которой он работает. Стоит сразу отметить, что дело это не то чтобы очень практичное: производительность ПК повышается от силы на 15 %. Кроме того, при превышении процессором тактовой частоты система теряет надежность.
Многие, услышав о разгоне, задают вопрос: а не сгорит ли система? Ответить на него можно словами о том, что только в 0,1 % случаев повреждения невозможно исправить. Однако, собираясь разгонять свое устройство, важно помнить, что именно вам может не повезти.
Разгон процессора на ПК и ноутбуке
Определенно разогнать процессор на стационарном компьютере проще, чем на ноутбуке. Во-первых, потому что разгон всегда сопровождается выделением большего количества тепла, а следовательно, понадобится более мощная система охлаждения, которую заменить на ПК не в пример проще, чем на ноуте.
Во-вторых, работать с компонентами ПК в целом проще, чем с компонентами ноутбука. Как тогда увеличить производительность процессора на ноутбуке? Да так же, как на ПК, просто нужно внимательнее следить за температурой процессора и ни в коем случае не допускать его перегревания. Рассмотрим несколько процессоров и способы их разгона.
Для того чтобы увеличить производительность процессора AMD, разогнав его, понадобится специальная программа. К примеру, AMD OverDrive. Она хорошо подходит для процессоров типа AMD. Кроме того, будет нужна утилита для постоянного измерения температуры процессора. Например, Speed Fan. Обе программы легко находятся в Интернете. Для более четкого примера возьмем конкретный процессор — AMD Athlon 64 X2. Как увеличить производительность данного процессора?
Нужно запустить обе этих программы и в AMD OverDrive выбрать вкладку Advanced. Там есть опция Clock/Voltage, одну из строчек которой — Select All Cores («Выбрать все ядра») — нужно отметить галочкой. После этих действий можно начинать разгонять процессор через множитель частоты. Согласно мнению многих айтишников, AMD Athlon 64 Х2 использует достаточно мало от своих ресурсов, поэтому можно сразу ставить 13-14. После пары минут работы процессора на этой частоте нужно замерить его температуру. Если та не достигает 70 °С, а компьютер работает без сбоев, множитель можно увеличить на 1.
Разгон можно производить и через BIOS, но с данным процессором это проще сделать через стороннюю утилиту.
Intel
Intel — очень популярный производитель оборудования для ПК, и у него есть много различных устройств, для которых могут потребоваться различные программы и настройки. Для данного примера возьмем процессор Intel Core i5. Как увеличить производительность процессора этой фирмы? Можно также воспользоваться программой. Понадобятся утилита для измерения температуры и прога для разгона, к примеру CPU-Z. Порядок действий будет аналогичен разгону AMD.
Второй вариант, как увеличить производительность процессора Intel, разогнав его — использование BIOS. Для того чтобы войти в него, при запуске компьютера нужно дождаться момента инициализации BIOS компонентов ПК и после нажать кнопку Delete (Del). После этого перейти в опцию BIOS FEATURES и найти там Super Speed. В этой вкладке будет раздел Overlock, в котором нужно выбрать раздел Optimal Referens. В нем будет опция Manual, которую нужно выставить. После данных действий на экране появятся все данные о процессоре. Нам понадобятся его частота, данные о шинах и множитель. Далее нужно найти пункт BSLK frequency, где по чуть-чуть необходимо увеличивать частоту. Найдя оптимальное значение, нужно сохранить настройки и выйти из BIOS, перезагрузив ПК.
Многие также интересуются увеличением производительности у конкретных устройств, задаваясь вопросом: что сделать, чтобы увеличить производительность процессора 535U4C-S02 от Samsung, например. Что же, для решения этой проблемы необходимо просто узнать компоненты ПК. В данном ноутбуке стоит процессор AMD Dual-Core A6-4455M APU, следовательно и процесс разгона для него будет аналогичен всем прочим AMD. Либо можно воспользоваться одним из способов увеличения производительности без воздействия на процессор — они универсальны для всех устройств.
Как увеличить производительность процессора без разгона
Несмотря на мифы о том, что увеличить производительность можно только с помощью разгона, существует много способов сделать это, обойдя взаимодействие с процессором напрямую:
- Первый — правильная настройка ПК. То есть установка точного количества ядер процессора для более полного использования потенциала, оптимизация визуальных эффектов.
- Второй — дефрагментация диска.
- Третий — регулярная очистка и отладка ОЗУ. Скапливающийся в оперативной памяти мусор в виде устаревших и смененных разрешений, старых ссылок, настроек неиспользуемых программ сильно замедляет ее работу, что сказывается на общей производительности компьютера.
- Четвертый — удаление старых, неиспользуемых программ, настройка фоновых процессов.
- Пятый — отладка автозагрузки.
Увеличение производительности ПК при помощи настроек операционной системы
Как увеличить производительность процессора в Windows 7, 8, 10? Основной способ основан на настройке операционной системы.
Дело в том, что по умолчанию в Windows включено много различных эффектов, дающих пользователю красивую картинку. Полупрозрачные окна, плавные переходы, тени, отбрасываемые объектами. Если есть желание добиться наилучшей производительности системы, все их стоит выключить.
Для того чтобы войти в панель управления дополнительными элементами, в поиске нужно вбить: «Визуальные эффекты». Пользователю понадобится вкладка «Настройка представления и производительности системы». В ней нужно найти панель управления визуальными эффектами. По умолчанию, почти все они включены, и для улучшения производительности нужно переставить галочку на «Обеспечить наилучшее быстродействие».

Следующий пункт подходит только тем, кто использует сторонние антивирусы. У «Виндовс» есть свой встроенный, который в этом случае можно отключить. Для этого нужно зайти в панель управления и найти там «Включение и отключение брандмауэра Windows». В левом меню нужно выбрать пункт «Отключить брандмауэр Windows» для каждого вида сети и нажать ОК.

Теперь нужно остановить работу самой службы. Для этого придется вернуться в панель управления, выбрать «Администрирование» и найти там строку «Брандмауэр Windows». Нажав правую кнопку мыши, нужно выбрать «Свойства» и остановить службу. После этого в графе «Тип запуска» нужно выбрать «Отключена». После этого можно смело жать «Применить».
Еще один способ увеличить производительность процессора Windows 7, 8, 10 — настройка количества используемых компьютером ядер процессора. Для начала нужно узнать их количество. Зная название процессора, это можно легко узнать в Интернете. Название процессора можно узнать во вкладке «Система» в панели управления. Далее нужно нажать комбинацию клавиш Win+R и в появившемся окне вписать msconfig. Далее нужно найти вкладку «Загрузка» и выбрать «Дополнительные параметры загрузки». Пункт «Число процессоров» нужно отметить галочкой и выбрать число, соответствующее количеству ядер.
Дефрагментация диска
Вообще дефрагментация диска — крайне нужная опция, которую пользователи никогда не проводят. Можно только поблагодарить разработчиков ОС Windows за то, что в настройках по умолчанию стоит еженедельная дефрагментация. Дело в том, что при удалении программы на диске остается пустое место, в которое система не всегда может впихнуть новую программу из-за разницы размеров. И даже если найдется небольшая программка, которая в пустоту поместится, скорее всего, рядом окажется немного пространства, которое уже ничем не заполнить. Дефрагментация удаляет эти «дыры».

Для того чтобы попасть в эту панель, нужно просто вбить «Дефрагментация диска» в поиск по системе. Здесь нужно по очереди проанализировать все диски, а после выбрать диск, фрагментация которого не равна нулю, и запустить дефрагментацию.
Очистка ОЗУ
Оперативная память играет крайне важную роль в производительности ПК. Однако со временем она забивается различным «мусором». Чтобы она продолжала работать в оптимальном режиме, ее время от времени нужно чистить.
Для этого в поиске по системе нужно вбить «Диагностика проблем оперативной памяти компьютера». В выскочившем меню нужно выбрать первый способ.

Компьютер совершит перезагрузку и начнет анализ ОЗУ. Процесс занимает много времени, так что проводить его стоит, только когда пользователь уверен, что прямо сейчас ПК ему не понадобится. После окончания устройство снова перезагрузится и предоставит пользователю полную информацию о проведенной работе.
Работа с программами, настройка фоновых процессов
Казалось бы, как влияют на работу ПК программы, которые пользователь давно не использует? Однако они занимают место на жестком диске, тормозят работу ОЗУ. Также компьютеру требуется больше времени, чтобы загрузиться и выключиться, потому что система судорожно ищет место для файлов сохранения.

Поэтому рекомендуется удалять все старые и ненужные программы с ПК. Можно воспользоваться панелью управления, а можно — сторонним софтом. Одним из лучших является Your Unin-Staller. Эта программа, в отличие от системы Windows, удаляет не только само приложение, но и все его временные и дополнительные файлы.
Удаление лишних программ в автозагрузке
Этот пункт влияет только на запуск ПК, но он все равно важен. Автозагрузка — система Windows, которая запускает программы сразу после входа пользователя в систему. Чем больше программ активно в автозагрузке, тем дольше будет загружаться ПК.

Для того чтобы войти в настройки автозагрузки, нужно нажать сочетание клавиш Win + R. Появится окно с названием «Выполнить», в которое нужно вписать строку msconfig. Откроется конфигурация системы. В ней нужно найти вкладку «Автозагрузка» и снять галочки со всех пунктов, которые не нужны.
Увеличение производительности за счет внутреигровых настроек
Первое, чем нужно воспользоваться, если игроку кажется, что игра тормозит, — любая утилита для измерения fps. В некоторых играх она бывает встроенной. Касательно этого числа: fps показывает количество кадров в секунду, следовательно, чем он больше, тем лучше. Однако, если он держится на низком уровне, нужно предпринять несколько действий.
Во-первых, если вы интересуетесь, как увеличить производительность процессора для игр и только для них, в первую очередь стоит обратить внимание на внутриигровые настройки. За счет снижения уровня графики, подбора правильного расширения экрана, уменьшения количества эффектов можно сильно повысить производительность системы, не парясь с разгоном диска или поисками нужных настроек ПК.
Во-вторых, помочь может настройка видеокарты, ведь именно это устройство отвечает за графику. Перед тем как калибровать ее, следует обновить драйверы: иногда бывает, что тормоза случаются из-за устаревшего софта. Если проблема не исчезла, уже можно лезть в настройки видеокарты. Для этого нужно на пустое место на рабочем столе кликнуть правую кнопку мыши и выбрать «Панель управления (название фирмы-производителя видеокарты, к примеру Nvidia)». Там пользователю понадобится вкладка «Управление 3D-параметрами». Здесь есть много настроек, которые улучшают графику в играх и которые вполне можно убрать без особого ущерба. К примеру, V-Sync (вертикальная синхронизация), тройная буферизация, анизотропная фильтрация.
Оптимизация кода: процессор
Все программы должны быть правильными, но некоторые программы должны быть быстрыми. Если программа обрабатывает видео-фреймы или сетевые пакеты в реальном времени, производительность является ключевым фактором. Недостаточно использовать эффективные алгоритмы и структуры данных. Нужно писать такой код, который компилятор легко оптимизирует и транслирует в быстрый исполняемый код.
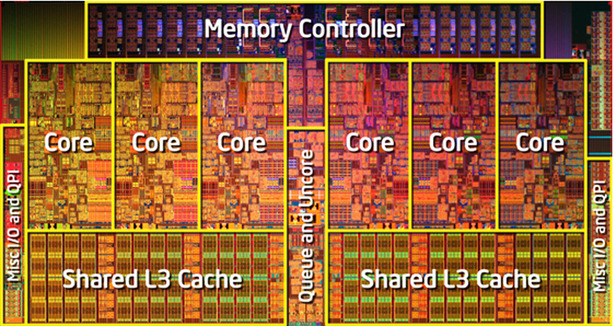
В этой статье мы рассмотрим базовые техники оптимизации кода, которые могут увеличить производительность вашей программы во много раз. Мы также коснёмся устройства процессора. Понимание как работает процессор необходимо для написания эффективных программ.
На написание этой статьи меня вдохновила пятая глава из книги Computer Systems: A Programmer’s Perspective. Все программы протестированы на машине с процессором Pentium 2117U, производительность на вашей машине может быть другая. В другой статье из этой серии, «Оптимизация кода: память», мы рассматриваем техники оптимизации для лучшего использования кэша.
Блокировщики оптимизации
Компиляторы сами пытаются оптимизировать код. Когда GCC запущен с параметром -Og, он выполняет базовый уровень оптимизации, с параметром -O1 первый уровень оптимизации. Существует и более высокие уровни оптимизации: -O2, -O3 и т. д. Чем выше уровень оптимизации, тем более радикальные изменения компилятор вносит в программу. Компиляторы могут применять только безопасные оптимизации. Это значит, что компилятор может изменять программу только так, чтобы это не изменило её поведение для всех входных данных.
Нам, как программистам, нужно понимать, что существуют определённые характеристики кода, которые не позволят компилятору совершить оптимизацию. Мы их называем блокировщиками оптимизации. Рассмотрим два типа блокировщиков оптимизации. Одним из них являются указатели. Компилятор не может точно знать, будут ли два указателя указывать на одну и ту же область памяти, и поэтому не выполняет некоторые оптимизации. Рассмотрим пример:
Функция twiddle2 выглядит более эффективной, она выполняет всего три запроса к памяти (прочитать *xp, прочитать *yp, записать *xp), в то время, как twiddle1 выполняет шесть запросов (четыре чтения и две записи). Можно ожидать, что эти две функции имеют одинаковое поведение. Однако представьте, что xp и yp указывают на одну и ту же ячейку памяти. Тогда twiddle1 увеличит *xp в четыре раза, а twiddle2 — в три раза. Эти функции имеют разное поведение в некотором случае. По этой причине компилятор не посмеет трансформировать менее эффективную функцию в более эффективную.
Другой блокировщик оптимизации — вызов функций. Вообще, вызовы функций влекут накладные расходы, и нам нужно стараться их избегать. Рассмотрим пример:
Первая функция вызывает f четыре раза, когда вторая — только один раз. Мы ожидаем, что компилятор догадается и преобразует первую функцию во вторую. Но функция f может иметь побочные эффекты, она может изменять глобальное состояние, как в этом примере:
В этом члучае func1 и func2 вернут разные результаты. Компилятору тяжело определить, имеет вызов функции побочные эффекты или нет. Когда он не может этого сделать, он рассчитывает на худшее и не выполняет оптимизацию.
Демонстрационная программа
Обычно медленные программы выполняют вычисления над большими массивами данных. Разумно будет оценивать эффективность таких программ в среднем количестве тактов, которые процессор тратит на обработку одного элемента массива. Введём метрику CPE (cycles per element). Если мы говорим, что программа имеет производительность CPE 2.5, значит она в среднем тратит 2.5 такта процессора на обработку одного элемента.
Мы представим простую программу, на примере которой продемонстрируем мощные приёмы оптимизации. Структура vec является вектором элементов типа float. Функция combine0 вычисляет результат перемножения всех элементов вектора. Эту функцию мы и будем оптимизировать. Размер массива сделаем 5000 и инициализируем его случайными числами.
Все программы в этой статье мы будем компилировать при помощи GCC с параметром -Og (базовый уровень оптимизации). Скомпилировав программу и сделав необходимые замеры, я получаю производительность CPE 11.05.
Для измерения CPE можно использовать инструкцию rdtsc, это счётчик тактов с момента последнего сброса процессора. Нужно сравнить значения счётчика до и после выполнения программы. Предупреждаю, что это ненадёжный метод. Для большей надёжности можно просто замерять потраченное процессорное время. Следующая программа пусть будет шаблоном, который демонстрирует оба метода.
Избавляемся от неэффективностей цикла
Обычно самым интенсивным местом программы являются циклы, особенно самый внутренний цикл. Именно там и нужно прежде всего искать возможности для оптимизации. В цикле нашей программы мы постоянно вызываем функцию vec_len, которая возвращает длину вектора. Бессмысленно делать это в каждой итерации, потому что длина вектора на протяжении цикла не меняется. Разумнее будет вызвать эту функцию один раз и сохранить результат в переменную. Поэтому вынесем вызов этой функции за пределы цикла.
Производительность новой версии не изменилась — CPE 11.05. Видимо, компилятор сам догадался выполнить эту оптимизацию. Давайте запустим GCC без параметра -Og и скомпилируем обе версии функции вообще без оптимизации. Теперь разница заметна: combine0 — CPE 12.7, combine1 — CPE 11.1.
В данном случае компилятор догадался вставить тело функции в место вызова этой функции. Но часто компилятор не будет этого делать, потому что не сможет определить, имеет функция побочные эффекты или нет. Если функция производит какие-то дополнительные действия, подобная трансформация может изменить поведение программы. Как экстремальный пример рассмотрим цикл, который превращает прописные буквы в строчные:
Функция strlen обходит всю строку пока не встретит нулевой символ, и делает это в каждой итерации. Это катастрофически замедляет программу. Для больших строк цикл будет выполняться в тысячи раз медленнее, чем более эффективный. В идеале компилятор должен распознать, что вызов strlen всегда возвращает то же самое значение, и вынести его за пределы цикла. Но для этого нужно глубоко проанализировать тело цикла и определить, что хотя программа и изменяет символы в строке, никакой символ она не превращает в нулевой. Это за пределами возможностей современных компиляторов.
Избавляемся от лишних обращений к памяти
Многие программы часто обращаются к памяти для чтения или записи. Это занимает много времени. Желательно работать с регистрами процессора, а не с памятью. Для таких программ нужно искать возможность ввести временную локальную переменную, в которую производить запись, и только через какое-то время произвести запись из этой переменной в память.
Подсчитаем сколько раз мы обращаемся к памяти в каждой итерации. Мы читаем элемент из массива, читаем dest, складываем эти значения и записываем результат в dest. Всего три обращения к памяти. Нам не нужно каждый раз читать и писать в dest после обработки очередного элемента. Мы введём временную переменную-аккумулятор, в которой будем хранить результат, и только в самом конце произведём запись в dest. Саму переменную-аккумулятор компилятор разместит в регистре, поэтому мы избавимся от ненужных обращений к памяти.
Теперь мы выполняем только одно обращение к памяти в каждой итерации. Производительность улучшается с CPE 11.05 до CPE 5.02. Если вы ожидаете, что компилятор сам догадается и выполнит эту оптимизацию, то подумайте что будет если dest указывает на какой-либо элемент в векторе. В этом случае версии с аккумулятором и без вычислят разное значение. Компилятор не может знать чему будут равны указатели, поэтому готовится к наихудшему и не выполняет оптимизацию. Вызовы функций и указатели серьёзно блокируют оптимизирующие возможности компилятора.
Раскрутка цикла
Мы достигли CPE 5.02. Это не простое число, мой процессор тратит 5 тактов на выполнение умножения чисел с плавающей точкой. Можно сказать, что мы достигли определённой нижней границы.
Мой процессор тратит один такт на выполнение сложения чисел типа int. Интересно, если вместо перемножения значений типа float, я буду складывать значения типа int, добьюсь ли я производительности CPE 1.0? Я вношу необходимые изменения в свою программу. Запускаю и получаю всего CPE 1.58. Откуда такая неэффективность?
Всё дело в том, что при выполнении цикла, процессор выполняет не только инструкции вычисления, в которых мы заинтересованы, но также инструкции, обслуживающие цикл: инкрементирование счётчика, проверка условия, переход в начало цикла. То есть обслуживание цикла имеет свои накладные расходы, и процессор производит много ненужной работы. Если тело цикла маленькое, эти «пустые» вычисления занимают большую долю процессорного времени.
Техника раскрутки цикла заключается в том, что за одну итерацию обрабатываются не один, а несколько элементов. Мы как бы «раскручиваем» цикл, увеличивая длину его тела и уменьшая количество витков. Таким образом мы выполняем меньше итераций, за одну итерацию совершаем больше полезной работы, и накладные расходы составляют уже не такую большую долю. Давайте немного изменим функции, складывающую целые числа:
Теперь программа добавляет к аккумулятору два элемента за итерацию. Обратите внимание, что последний элемент может быть не обработан в цикле, поэтому его нужно добавить к аккумулятору позже. CPE падает с 1.58 до 1.15. Обрабатывая четыре элемента за итерацию, я получаю CPE 1.03, что близко к тому значению, которое хотел получить.
CPE 5.02, который мы получили, равно количеству тактов, которые тратит мой процессор на совершение умножения чисел с плавающей точкой. Для обработки одного элемента мы выполняем одно умножение, и, казалось бы, это предел, ниже которого мы не опустимся. Но на самом деле мы можем достигнуть CPE 1.04 . Чтобы понять более продвинутые техники оптимизации, нужно сперва разобраться, как работает процессор.
Введение в работу процессора
Современные процессоры очень сложны. Внутреннее устройство процессора называется микроархитектурой, и это отдельный мир, над которым мы не имеем контроля. Когда процессор читает инструкции программы, он разбивает их на примитивы, понятные ему, и обрабатывает их как ему вздумается. Если смотреть на код ассемблера, то кажется, что процессор выполняет инструкции последовательно, одна за одной, как они представлены в коде. На самом деле процессор может выполнять инструкции параллельно и даже в противоположном порядке, если уверен что это не изменит конечный результат. Выполнение процессором инструкций параллельно называется параллелизмом на уровне инструкций.
Процессор разбит на части, которые выполняют разные типы задач, мы их называем функциональными блоками. Каждый блок выполняет определённый ряд задач: чтение из памяти, запись в память, сложение целых чисел, умножение чисел с плавающей точкой и т. д. Мой процессор имеет два блока, которые выполняют сложение целых чисел. Это значит, что он может параллельно выполнять два сложения.
Представьте, что процессору нужно получить данные из памяти и это занимает 100 тактов. Но процессору будет неразумно ждать завершения этой операции, чтобы начать следующую. Ведь чтением данных из памяти занимается отдельный блок, а остальные блоки в это время могут производить другие вычисления. Поэтому процессор наперёд считывает несколько следующих инструкций и пытается нагрузить ими все функциональные блоки, даже если придётся выполнять инструкции в другом порядке.
Считывание инструкций наперёд называется предвыборкой. Если во время предвыборки процессор встречает ветвление (к примеру, конструкция if-else), он пытается угадать, какая ветвь будет взята и считывает инструкции оттуда. Если позже он понимает, что была взята неправильная ветвь, он сбрасывает произведённые вычисления, восстанавливает предыдущее состояние и идёт по другой ветви. Такая ошибка стоит процессору нескольких потерянных тактов. Для многих процессоров это примерно 20 тактов.
Конвейер
Мой процессор имеет один функциональный блок, выполняющий умножения чисел с плавающей точкой, и на одно умножение он тратит пять тактов. И казалось бы, если нам нужно выполнить N умножений, нам придётся потратить 5*N тактов. Но это не так, благодаря такому устройству как конвейер.
В американских фильмах вы наверняка видели как клиент в столовой проходит с подносом нескольких поваров, и каждый ковшом накладывает ему что-то своё. Это и есть конвейер. Представим столовую с пятью поварами, и обслужиться у одного из них занимает один такт. Они могли бы обслуживать клиентов так: сначала один клиент проходит всех поваров, потом второй, потом третий и так далее. В этом случае каждые пять тактов от них отходил бы клиент с полным подносом. Но это неэффективно. Лучше если все клиенты выстроятся в очередь, и каждый такт эта очередь будет продвигаться к следующему повару. В этом случае каждый такт от поваров будет отходить клиент с полным подносом. Заметьте, что обслуживание одного клиента всё равно будет занимать пять тактов, но обслуживание N клиентов (если N велико) займёт примерно N тактов.
По принципу конвейера устроены функциональные блоки в процессоре. Они разделяют всю работу на несколько этапов, и на разных этапах могут одновременно обрабатываться разные инструкции. Несмотря на то, что выполнение одной инструкции может занимать несколько тактов, многие блоки могут принимать в конвейер новую инструкцию каждый такт. Такие блоки называются полностью конвейерными. Все операции, кроме деления, выполняются в полностью конвейерном режиме. Деление считается сложной операцией, занимает 3-30 тактов и вообще не имеет конвейера.
Зависимость данных и несколько аккумуляторов
Но если конвейер позволяет нам тратить один такт на операцию, почему тогда мы получили CPE 5.02, а не CPE 1.02? Всё дело в такой плохой вещи как зависимость данных. Вернёмся к примеру со столовой. Допустим, первый повар в столовой накладывает или рис или гречку, и по странному правилу, каждый клиент, пройдя всех поваров, решает что должен наложить первый повар следующему клиенту. Тогда мы не можем начать обслуживание следующего клиента пока текущий клиент не пройдёт всех поваров. Нам приходится ждать, потому что есть определённая зависимость. Также и в работе процессора. Мы говорим, что между данными есть зависимость, если для начала работы над одними данными нам нужны другие данные, и мы должны дождаться завершения работы над ними.
В нашей программе такую зависимость данных создаёт переменная-аккумулятор. Процессор мог бы вычислять инструкции цикла на несколько итераций вперёд. Но в каждой итерации мы вычисляем новое значение аккумулятора, учитывая его значение, вычисленное в предыдущей итерации. Поэтому мы не можем начать умножение в следующей итерации, пока полностью не завершится умножение в предыдущей. То есть каждое умножение должно пройти весь конвейер, прежде чем мы отправим в конвейер следующее. Это и мешает нам загрузить конвейер.
Давайте подумаем, как можно избавиться от этой зависимости. Если нам нужно перемножить последовательность чисел, мы может перемножать их одно на другое последовательно. А можем сначала перемножить все числа с чётным индексом, потом все числа с нечётным, а в конце перемножить два полученных результата. В таком случае перемножение двух последовательностей будут независимы друг от друга, и операции умножения из разных последовательностей смогут находиться в конвейере одновременно.
Для большей наглядности мы упростим код и будем передавать в функцию не векторную структуру, а сразу массив чисел. Такое изменение на производительность не повлияет, зато читать код станет проще. Следующая техника называется раскруткой цикла с несколькими аккумуляторами.
Как видите, мы поддерживаем два независимых аккумулятора, которые в конце перемножаются, чтобы дать окончательный результат. CPE падает до с 5.02 до 2.5. Давайте сделаем раскрутку с четырьмя аккумуляторами:
CPE падает до 1.28. При восьми аккумуляторах я получаю CPE 1.04, что практически равно тому, что можно выжать из моего процессора. При написании кода в таком стиле нужно не забывать обрабатывать оставшиеся несколько элементов.
Мой процессор имеет только один функциональный блок, который выполняет умножение чисел с плавающей точкой. Core i7 Haswell имеет два таких блока, на нём наше приложение может достичь CPE 0.5, но пришлось бы использовать больше аккумуляторов. Вообще, если операция занимает C тактов и её выполняют N блоков, необходимое количество аккумуляторов может быть C*N.
Ассоциативность
Как мы уже говорили, компиляторы очень консервативны, боятся навредить и никогда не вносят изменения в программу, которые могут повлиять на конечный результат в каком-то случае. Компиляторы знают о технике раскрутки цикла с несколькими аккумуляторами. GCC применяет эту технику, когда запущен с третьим уровнем оптимизации или выше. Компиляторы будут применять эту оптимизацию для целых чисел, но никогда не применят её для чисел с плавающей точкой. Всё дело в ассоциативности, то есть в том, влияет ли порядок, в котором мы складываем или перемножаем числа, на конечный результат.
Если у нас есть последовательность целых чисел, то неважно в каком порядке мы их будем складывать или перемножать, мы всё равно получим один и тот же результат, даже если будет переполнение. Мы говорим, что операции сложения и умножения для целых чисел являются ассоциативными операциями. Сложение и умножение для чисел с плавающей точкой не являются ассоциативными. Допустим в последовательности чисел типа float есть очень маленькие числа и очень большие. Если мы сначала перемножим очень маленькие, то получим ноль. Умножая все остальные на ноль, мы в итоге получим ноль. Если же изначально очень маленькие мы будем умножать на очень большие, в итоге мы могли бы получить адекватный результат.
Для большинства реальных приложений нет разницы в каком порядке выполнять операции над числами, поэтому мы можем использовать эту технику оптимизации.
Векторизация
Мы ещё можем улучшить производительность. CPE 1.04, который мы достигли — не предел. Современные процессоры поддерживают специальные расширения, называемые SSE или AVX, которые позволяют работать над векторами данных. В процессоре есть специальные векторные регистры, называемые %ymm0—%ymm15, размером 16 или 32 байта. Текущие AVX регистры имеют размер 32 байта и могут содержать четыре 64-битных числа, или восемь 32-битных числа, не важно целых или с плавающей точкой. Можно считать из памяти в один такой регистр сразу 32 байта данных, считать 32 байта данных в другой регистр и выполнить арифметическую операцию сразу над четырьмя или восьмью числами параллельно.
Это железо находится в процессоре неиспользуемое, пока вы явно не задействуете его. GCC поддерживает расширение языка C, которое позволит вам это сделать. Можно, конечно, написать код на ассемблере, но тогда программа перестанет быть переносимой. Используя эти возможности процессора, можно дальше увеличить производительность программы в 4 или 8 раз, в зависимости от размера регистров. В нашем случае, мы могли бы понизить CPE до 0.25 или 0.12.
Итоги оптимизации
Мы начали с программы, которая имела производительность CPE 11.05. Потом мы избавились от лишних вызовов функций и запросов к памяти и улучшили производительность до CPE 5.02. Потом использовали раскрутку цикла с несколькими аккумуляторами. Так смогли избавиться от зависимости данных, смогли полностью загрузить конвейер и получили CPE 1.04. То есть мы увеличили скорость выполнения программы в 11 раз. Используя векторизацию, можно заставить программу выполняться в 44—88 раза быстрее по сравнению с первоначальной версией.
Вы можете возразить, что мы применяем все эти техники оптимизации и сравниваем производительность с первоначальной версией, которая была скомпилирована лишь с базовым уровнем оптимизации. И, возможно, нам не нужно знать все эти техники, потому что компилятор применит их за нас, если мы прикажем ему компилировать с высоким уровнем отпимизции. Хорошо, давайте скомпилируем первоначальную версию программы с высоким, третьим уровнем оптимизации и посмотрим на что способен компилятор. Я получаю производительность CPE 5.02. Это далеко от CPE 1.04, которое мы получили, вручную трансформируя код. Знание всех этих приёмов оптимизации позволило нам добиться пятикратного увеличения производительности. Мы можем использовать векторизацию, чтобы дальше увеличить производительность в 4-8 раз, компилятор за вас этого не сделает.
Проблемы и ограничения
Количество функциональных блоков, которые выполняют чтение и запись в память, может быть узким местом производительности. Заметим, что эти блоки полностью конвейерные и могут принимать новую инструкцию каждый такт. Мой процессор имеет один блок, выполняющий чтение данных из памяти в процессор. Если для обработки одного элемента, мне нужно будет получить из памяти два числа, я не смогу сделать лучше, чем CPE 2.0, потому что получение двух чисел займёт два такта. Core i7 Haswell имеет четыре блока, которые выполняют сложения целых чисел. Но если вам нужно сложить элементы целочисленного вектора, вы не сможете добиться CPE 0.25. Потому что этот процессор имеет только два блока, выполняющих чтение из памяти — это устанавливает нижнюю границу на CPE 0.5.
Значение каждого аккумулятора хранится в отдельном регистре. x86-64 процессор имеет 16 регистров для целых чисел и 16 YMM регистров для чисел с плавающей точкой. Если мы будем использовать слишком много аккумуляторов, для них может не хватить регистров. Придётся хранить значения некоторых из них в памяти, что ухудшит производительность. Если увеличить количество аккумуляторов в нашей программе с 8 до 20, производительность падает с CPE 1.04 до CPE 1.35.
Оптимизация усложняет код, делает его трудным для понимания. Поэтому, обычно оптимизируют критически важные части кода, где требуется максимальная производительность. Оптимизация увеличивает количество потенциальных багов. Оптимизированный код нужно тщательно тестировать после каждого этапа оптимизации.
Другие техники оптимизации: реассоциация
Существует техника, называемая реассоциацией. Это когда мы в каком-то выражении расставляем скобки по-другому, и это позволяет уменьшить зависимость данных и улучшить производительность. Допустим в нашей программе мы хотим перемножать три элемента за одну итерацию.
Этот цикл имеет производительность CPE 5.02. По правилам языка C, когда нет скобок, операции умножения выполняются слева направо. В данном случае, легко увидеть, что все операции умножения зависят от переменной acc. Процессор не может начать умножать в следующей итерации, пока не завершит все умножения в текущей. Расставим скобки по-другому:
Значение переменных x, y и z в одной итерации не зависят от их значений в любой другой. Поэтому, пока выполняется текущая итерация, процессор может заранее вычислять два последних умножения в следующих итерациях. Производительность улучшается до CPE 1.69.
Другие техники оптимизации: условная передача данных
Как уже было сказано, процессор выполняет предвыборку, то есть считывает инструкции наперед. Если ему встречается ветвление (команды ассемблера je, jg, jl и т. д. ), он пытается угадать по какой ветви пойдёт вычисление. Если он угадывает неправильно, то теряет несколько тактов. Это называется условная передача управления.
Существует команда ассемблера cmov. Выполняя эту команду, процессор проверяет какое-то условие. Если это условие верно, он копирует значение из одного регистра в другой. Это называется условная передача данных. В данном случае не создаётся ветвления и процессору не надо ничего угадывать и рисковать потерей тактов.
Идея заключается в том, чтобы уменьшить количество ветвлений в программе, сделав поток выполнения более прямым. Для этого некоторые передачи управления выгодно заменить на передачу данных. Обычно компилятор транслирует конструкции if-else, используя команды ассемблера je, jg, jl и т. д., но иногда может использовать команду cmov. Рассмотрим такую конструкцию if-else:
Если транслировать этот код, используя передачу управления, то при выполнении программы будет вычислено или одно выражение или другое, но есть вероятность, что процессор совершит ошибку в выборе ветвления и потеряет такты. Компилятор может избежать ветвления, если преобразует этот код следующим образом:
Когда условная инструкция очень простая, в ней только присваивается какое-то значение одной переменной, компилятор транслирует эту инструкцию на язык ассемблера с помощью команды cmov. Поэтому, последняя строка в предыдущем примере будет транслирована, используя передачу данных, не создавая ветвления. Процессору придётся вычислить оба выражения, что занимает больше тактов, но он не выполняет предсказания ветвления, что потенциально экономит такты. Если выражения довольно просты, такое преобразование может быть выгодным.
Иногда компилятор не выполняет эту оптимизацию, потому что считает, что это ухудшит производительность. Мы можем заставить его выполнить её если перепишем код в более функциональном стиле, как представлено в предыдущем примере. Рассмотрим реальную программу.
Обе функции делают одно и то же. Они параллельно обходят пары чисел из двух массивов, устанавливая в массив a наименьшее из них, а в массив b наибольшее. Только вторая функция использует хитрую технику: она вычисляет минимальное число, вычисляет максимальное число и записывает каждое из чисел в своё место. Условия в вычислении переменных min и max настолько простые, что компилятор использует для них условную передачу данных. Разница в производительности наибольшая, если выполнить компиляцию с третьим уровнем оптимизации: minmax1 — CPE 15.6, minmax2 — CPE 1.18 (в 13.2 раз быстрее).
Заключение
Современный процессор скрывает огромную вычислительную мощь. Но чтобы получить к ней доступ, нужно писать программы в определённом стиле. Решить какие трансформации и к какой части кода применить есть «чёрная магия» написания быстрого кода. Обычно анализ совмещают с экспериментом: пробуют разные подходы, делают измерения производительности, исследуют код ассемблера для обнаружения узких мест.
Вы теперь лучше понимаете почему предпочтительнее использовать функции из стандартных библиотек, чем писать свои решения. Код функций в стандартных библиотеках уже оптимизирован.