Продвинутые абстракции Kubernetes: Job, CronJob
Что такое Job и CronJob в Kubernetes, для чего они нужны, а для чего их использовать не стоит.
Эта статья — выжимка из лекции вечерней школы «Слёрм Kubernetes».
Job: сущность для разовых задач
Job (работа, задание) — это yaml-манифест, который создаёт под для выполнения разовой задачи. Если запуск задачи завершается с ошибкой, Job перезапускает поды до успешного выполнения или до истечения таймаутов. Когда задача выполнена, Job считается завершённым и больше никогда в кластере не запускается. Job — это сущность для разовых задач.
Когда используют Job
При установке и настройке окружения. Например, мы построили CI/CD, который при создании новой ветки автоматически создаёт для неё окружение для тестирования. Появилась ветка — в неё пошли коммиты — CI/CD создал в кластере отдельный namespace и запустил Job — тот, в свою очередь, создал базу данных, налил туда данные, все конфиги сохранил в Secret и ConfigMap. То есть Job подготовил цельное окружение, на котором можно тестировать и отлаживать новую функциональность.
При выкатке helm chart. После развёртывания helm chart с помощью хуков (hook) запускается Job, чтобы проверить, как раскатилось приложение и работает ли оно.
Таймауты, ограничивающие время выполнения Job
Job будет создавать поды до тех пор, пока под не завершится с успешным результатом. Это значит, что если в поде есть ошибка, которая приводит к неуспешному результату (exit code не равен 0), то Job будет пересоздавать этот под до бесконечности. Чтобы ограничить перезапуски, в описании Job есть два таймаута: activeDeadlineSeconds и backoffLimit.
activeDeadlineSeconds — это количество секунд, которое отводится всему Job на выполнение. Обратите внимание, это ограничение не для одного пода или одной попытки запуска, а для всего Job.
Например, если указать в Job, что activeDeadlineSeconds равен 200 сек., а наше приложение падает с ошибкой через 5 сек., то Job сделает 40 попыток и только после этого остановится.
backoffLimit — это количество попыток. Если указать 2, то Job дважды попробует запустить под и остановится.
Параметр backoffLimit очень важен, потому что, если его не задать, контроллер будет создавать поды бесконечно. А ведь чем больше объектов в кластере, тем больше ресурсов API нужно серверам, и что самое главное: каждый такой под — это как минимум два контейнера в остановленном состоянии на узлах кластера. При этом поды в состоянии Completed или Failed не учитываются в ограничении 110 подов на узел, и в итоге, когда на узле будет несколько тысяч контейнеров, докер-демону скорее всего будет очень плохо.
Учитывая, что контроллер постоянно увеличивает время между попытками запуска подов, проблемы могут начаться в ночь с пятницы на понедельник. Особенно, если вы не мониторите количество подов в кластере, которые не находятся в статусе Running.
Удаление Job
После успешного завершения задания манифесты Job и подов, созданных им, остаются в кластере навсегда. Все поля Job имеют статус Immutable, то есть «неизменяемый», и поэтому обычно при создании Job из различных автоматических сценариев сначала удаляют Job, который остался от предыдущего запуска. Практика генерации уникальных имен для запуска таких Job может привести к накоплению большого количества ненужных манифестов.
В Kubernetes есть специальный TTL Controller, который умеет удалять завершенные Job вместе с подами. Вот только он появился в версии 1.12 и до сих пор находится в статусе alpha, поэтому его необходимо включать с помощью соответствующего feature gate TTLAfterFinished.
ttlSecondsAfterFinished — указывает, через сколько секунд специальный TimeToLive контроллер должен удалить завершившийся Job вместе с подами и их логами.
Манифест
Посмотрим на пример Job-манифеста.
В начале указаны название api-группы, тип сущности, имя и дальше — спецификация.
В спецификации указаны таймауты и темплейт пода, который будет запускаться. Опции backoffLimit: 2 и activeDeadlineSeconds: 60 значат, что Job будет пытаться выполнить задачу не более двух раз и в общей сложности не дольше 60 секунд.
template — это описание пода, который будет выполнять задачу; в нашем случае запускается простой контейнер busybox, который выводит текущую дату и передаёт привет из Kubernetes.
Практические примеры
И посмотрим, что получилось.
Видим, что контейнер поднялся и завершился в статусе Completed. В отличие от приложений, которые всегда работают и имеют статус Running.
Статистику по Job можно посмотреть следующей командой.
Видим, что завершились все задания, время выполнения — 5 секунд.
Ненужный Job обязательно надо удалять. Потому что, если мы не удалим его руками, Job и под будут висеть в кластере всегда — никакой garbage collector не придёт и не удалит их.
Если у вас запускаются по 10-20 заданий в час, и никто их не удаляет, они копятся и в кластере появляется много абстракций, которые никому не нужны, но место занимают. А как я уже говорил выше, каждый под в состоянии Completed — это, как минимум, два остановленных контейнера на узле. А докер демон начинает притормаживать, если на узле оказывается несколько сотен контейнеров, и не важно, работают они или остановлены.
Команда для удаления:
Что будет, если сломать Job
Job, который выполняется без проблем, не очень интересен. Давайте мы над ним немного поиздеваемся.
Поправим yaml: добавим в темплейт контейнера exit 1. То есть скажем Job’у, чтобы он завершался с кодом завершения 1. Для Kubernetes это будет сигналом о том, что Job завершился неуспешно.
Применяем и смотрим, что происходит: один контейнер создался и упал с ошибкой, затем ещё и ещё один. Больше ничего не создаётся.

В статистике подов видим, что создано три пода, у каждого статус Error. Из статистики Job следует, что у нас создан один Job и он не завершился.

Если посмотреть описание, то увидим, что было создано три пода, и Job завершился, потому что был достигнут backoffLimit.
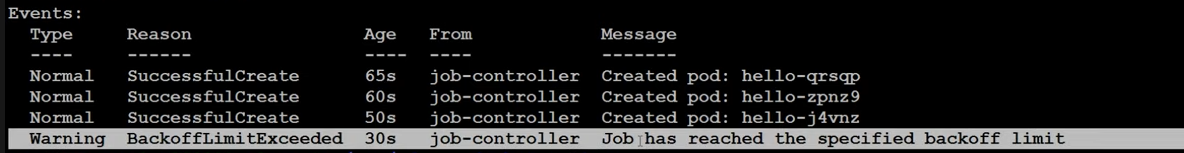
Обратите внимание! В yaml лимит равен 2. То есть, если следовать документации, Job должен был остановиться после двух раз, но мы видим три пода. В данном случае «после выполнения двух раз» значит 3 попытки. Когда мы проделываем то же самое на интенсиве с сотней студентов, то примерно у половины создаётся два пода, а у оставшихся три. Это надо понять и простить.
Проверка ограничения по времени
Сделаем бесконечный цикл и посмотрим, как работает ограничение по времени — activeDeadlineSeconds.
Ограничения оставим теми же (60 секунд), изменим описание контейнера: сделаем бесконечный цикл.

Если посмотреть в логи, то увидим, что каждую секунду у нас появляется новый «Hello» — всё как надо.
Через 60 секунд под оказывается в статусе Terminating (иногда это происходит через ± 10 сек).

Вспомним, как в Kubernetes реализована концепция остановки подов. Когда приходит время остановить под, то есть все контейнеры в поде, контейнерам посылается sigterm-сигнал и Kubernetes ждёт определённое время, чтобы приложение внутри контейнера отреагировало на этот сигнал.
В нашем случае приложение — это простой bash-скрипт с бесконечным циклом, реагировать на сигнал некому. Kubernetes ждёт время, которое задано в параметре graceful shutdown. По дефолту — 30 секунд. То есть если за 30 секунд приложение на sigterm не среагировало, дальше посылается sigkill и процесс с pid 1 внутри контейнера убивается, контейнер останавливается.
Спустя чуть более 100 секунд под удалился. Причем ничего в кластере не осталось, потому что единственный способ остановить что-то в контейнере — это послать sigterm и sigkill. После этого приходит garbage collector, который удаляет все поды в статусе Terminating, чтобы они не засоряли кластер.
В описании Job мы увидим, что он был остановлен, так как активность превысила допустимую.

Поле restartPolicy
При проверке backoffLimit поды у нас перезагружались. При этом в манифесте указан параметр restartPolicy: Never . Но когда мы смотрели, как работает опция backoffLimit, поды перезагружались. Здесь нет противоречия: если вы посмотрите на весь yaml-файл, то заметите, что этот параметр относится не к Job, а к спецификации контейнера, который запускается внутри пода.
Этот параметр говорит kubelet, что делать с контейнером после того, как он был завершён с ошибкой. По умолчанию стоит политика Always, то есть если у нас контейнер в поде завершился, kubelet этот контейнер перезапускает. Причем, все остальные контейнеры в поде продолжают работать, а перезапускается только упавший контейнер.
Это политика по умолчанию, и если её применить в Job, то Job-контроллер не сможет получить информацию о том, что под был завершён с ошибкой. С его точки зрения под будет очень долго выполняться, а то, что kubelet перезапускает упавший контейнер, Job-контроллер не увидит.
- backoffLimit (количество попыток),
- activeDeadlineSeconds (общее время),
- restartPolicy: Never (сказать kubelet, чтобы он никогда не перезапускал контейнер в поде; если контейнер в поде упал, то и сам под считается упавшим, то есть завершённым. Пусть Job-контроллер разбирается, что произошло).
CronJob: создание объектов Job по расписанию
Job позволяет выполнить разовые задачи, но на практике постоянно возникает потребность выполнять что-то по расписанию. И вот здесь Kubernetes предлагает CronJob.
CronJob — это yaml-манифест, на основании которого по расписанию создаются Job’ы, которые в свою очередь создают поды, а те делают полезную работу.
На первый взгляд, всё вроде бы просто, но, как и в предыдущем случае, тут есть куча мест, где можно испытать боль.
В манифесте CronJob указывают расписание и ещё несколько важных параметров.
- startingDeadlineSeconds,
- concurrencyPolicy.
И два параметра, которые влияют на историю выполнения.
- successfulJobsHistoryLimit,
- failedJobsHistoryLimit.
Посмотрим на манифест CronJob и поговорим о каждом параметре подробнее.
schedule — это расписание в виде строчки, которая имеет обычный cron-формат. Строчка в примере говорит о том, что наш Job должен выполняться раз в минуту.
concurrencyPolicy — этот параметр отвечает за одновременное выполнение заданий. Бывает трёх видов: Allow, Forbid, Replace.
Allow позволяет подам запускаться. Если за минуту Job не отработал, все равно будет создан ещё один. Одновременно могут выполняться несколько Job’ов.
Например, если один Job выполняется 100 сек., а Cron выполняется раз в минуту, то запускается Job, выполняется 61 сек., в это время запускается ещё один Job. В итоге в кластере одновременно работают два Job’a, которые выполняют одну и ту же работу. Возникает положительная обратная связь: чем больше Job’ов запущено, тем больше нагрузка на кластер, тем медленнее они работают, тем дольше они работают и тем больше одновременных подов запускается — в итоге всё застывает под бешеной нагрузкой.
Replace заменяет запущенную нагрузку: старый Job убивается, запускается новый. На самом деле это не самый лучший вариант, когда прерываем то, что уже выполнялось, и начинаем ту же самую задачу выполнять заново. В каких-то случаях это возможно, в каких-то неприемлемо.
Forbid запрещает запуск новых Job’ов, пока не отработает предыдущий. С этой политикой можно быть уверенным, что всегда запускается только один экземпляр задачи. Поэтому Forbid используют наиболее часто.
jobTemplate — это шаблон, из которого создаётся объект Job. Ну а всё остальное мы уже видели в манифесте Job.
Посмотрим, что получилось:
Увидим название CronJob, расписание, параметр запуска, количество активных Job’ов и сколько времени они работают.

Раздел Suspend — временная приостановка CronJob. В данном случае указано значение False. Это значит, что CronJob выполняется. Можно отредактировать манифест и поставить опцию True, и тогда он не будет выполняться, пока мы его снова не запустим.
Active — сколько Job’ов создано, Last Schedule — когда последний раз исполнялся.
Теперь можно посмотреть статистику по Job’ам и подам.
Видно, что создан один Job.
Под создан, он выполнил полезную работу.

Что получается: CronJob создал Job, Job создал под, под отработал, завершился — всё здорово.
Ещё раз посмотрим на CronJob:

Last Schedule был 19 секунд назад. Если посмотреть на Job, то увидим, что у нас появился следующий Job и следующий под.
Возникает вопрос: а что будет, если CronJob отработает хотя бы пару недель? Неужели у нас в кластере будет столько же Job’ов и подов в статусе Completed, сколько в этой паре недель минут?
Когда CronJob’ы только появились и были на стадии альфа-тестирования, примерно это и происходило: делали CronJob раз в минуту, смотрели — работает, всё здорово, а через неделю кластер становился неработоспособным, потому что количество остановленных контейнеров на узлах было ошеломляющим. Теперь же ситуация изменилась.
Снова откроем манифест и посмотрим, что было добавлено:


Появились опции failedJobHistorLimit со значением 1 и successfulJobHistoryLimit со значением 3. Они отвечают за количество Job’ов, которые остаются одновременно в кластере. То есть CronJob не только создаёт новые Job’ы, но и удаляет старые.
Когда только контроллер CronJob создавался, эти опции не были установлены по умолчанию и CronJob за собой ничего не удалял. Было много возмущений от пользователей, и тогда поставили дефолтные лимиты.
И на сладкое — про startingDeadlineSeconds
В параметре startingDeadlineSeconds указывают количество секунд, на которое можно просрочить запуск Job. Если по каким-то причинам Job не создался и с момента, когда его надо было создать, прошло больше секунд, чем указано в этом параметре, то он и не будет создан. А если меньше, то хоть и с опозданием, Job будет создан.
Тут есть небольшая ловушка, если concurrencyPolicy разрешают одновременное создание Job, то при большом значении параметра startingDeadlineSeconds возможен одновременный запуск десятков пропущенных Job одновременно. Для уменьшения всплеска нагрузки в код Kubernetes захардкожены лимиты и запрещающие процедуры:
Если параметр startingDeadlineSeconds не указан в манифесте:
CronJob контроллер при создании Job смотрит на время последнего запуска — значение LastscheduleTime в status: и считает, сколько времени прошло с последнего запуска. И если это время достаточно велико, а точнее за этот промежуток времени CronJob должен был отработать 100 раз или больше, но у нее этого не получилось:
- например конкурент полиси стоит форбид, крон запускается раз в минуту, и один из запусков подзавис и работал 2 часа, то есть 120 минут;
- или у нас один мастер в кластере, который упал на пару часов.
В этом случае происходит нечто странное: CronJob перестает работать, новые Job’ы больше не создаются. Сообщение об этом приходит в Events, но хранится там недолго. Для восстановления работы приходится удалять CronJob и создавать его заново.
И еще более странное:
Если установлен параметр startingDeadlineSeconds, то поведение немного меняется. 100 пропущенных запусков должны уложиться в количество секунд, указанных в этом параметре. т. е. если в расписании стоит выполняться раз в минуту, а startingDeadlineSeconds меньше 6000 секунд, тогда CronJob будет работать всегда, но в этом случае при политике Allow возможен одновременный запуск множества Job.
И наконец, любопытный side-эффект:
Если установить опцию startingDeadlineSeconds равной нулю, Job’ы вообще перестают создаваться.
Особенность работы CronJob
A cron job creates a job object about once per execution time of its schedule. We say «about» because there are certain circumstances where two jobs might be created, or no job might be created. We attempt to make these rare, but do not completely prevent them. Therefore, jobs should be idempotent.
Вольный перевод на русский:
CronJob создаёт объект Job примерно один раз на каждое время исполнения по расписанию. Мы говорим «примерно», потому что иногда бывают случаи, когда создаются два Job’а одновременно или ни одного. Мы делаем всё, чтобы сделать подобные случаи как можно более редкими, но полностью избежать этого не получается. Следовательно, Job’ы должны быть идемпотентны.
Идемпотентны — должны выполняться на одной и той же среде несколько раз и всегда возвращать одинаковый результат.
В общем, используйте CronJob на свой страх и риск.
В качестве альтернативы CronJob можно использовать под, в котором запущен самый обычный crond. Без выкрутасов. Старый добрый cron работает без проблем, и мы всегда знаем, что задачи будут выполнены один раз. Надо только побеспокоиться, чтобы внутри пода с кроном не выполнялись одновременно несколько задач.
Изучить продвинутые абстракции и попрактиковаться в работе с Kubernetes можно с помощью видеокурса Kubernetes База. В октябре 2020 мы обновили курс, подробности здесь.
Автор статьи: Сергей Бондарев — практикующий архитектор Southbridge, Certified Kubernetes Administrator, один из разработчиков kubespray с правами на принятие pull request.
Заметки от Геннадия
«Job» , он же «джоб», он же «задание» — это отдельно стоящий кусочек кода; он независим от всех, как африканские племена независимы от системы центрального отопления. Похож на функцию, которая не пренадлежит ни одному классу. Предназначен для решения локальных задач разработчика (попробовать какой-то алгоритм, массово исправить данные, запорченные ошибкой в коде).
Далее я буду использовать термин «джоб».
Откройте дерево проектов и создайте новый проект «Blog45», и группу в нем (смотрите рисунок). У группы свойство «ProjectGroupType» должно быть равно «Jobs». 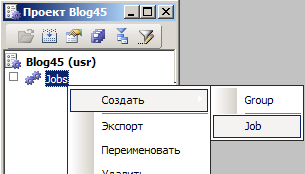 Для создания нового джоба нажмите на правую кнопку мышки на узле «Jobs» и выберите пункт «Создать», «Job». Откроется редактор X++ с объявленным джобом. Переименуйте его в BLG45_Job и напишите код на рисунке ниже:
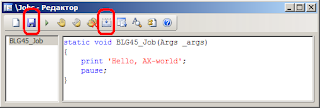 На рисунке выделены две кнопки: левая — сохранение изменений, правая — компиляция кода. Названия различные, суть одна: процессы сохранения и компиляции в Аксапте неотделимы («сохраняя, компилируем», «компилируя, сохраняем»).
В результате увидите белое окно с приветственным сообщением: 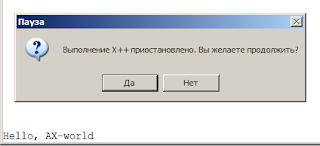
Создаем аналитическое хранилище данных командой из 2-3 спецов
Цепочка создания ценности в процессе работы с данными (источник):
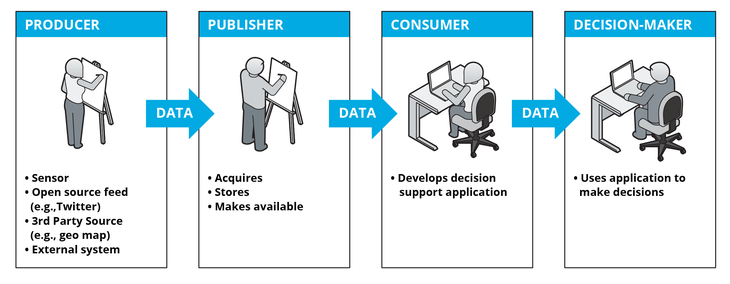
Ценность создается только на последнем шаге цепочки. Вы можете извлекать данные, обрабатывать их как угодно: чистить, обогащать, маршрутизировать по системам, накапливать в хранилищах, заливать в витрины и т.д. Все эти операции ценности никакой не приносят.
Ценность создается при принятии правильных решений. Поэтому, мне кажется, в начале пути нужно как можно быстрее научиться получать профит из данных и DWH, а затем постепенно улучшать модели данных и процессы разработки DWH.
Сейчас часто собирается всё что можно собрать в озеро, а на втором этапе начинается детальная проработка результирующих витрин. Считаю, что нужно мыслить от показателей к источникам данных, а не наоборот. Чем лучше вы проработаете показатели необходимые для анализа, разрезы в которых нужно анализировать показатели, тем меньше работы будет у дата инженеров (DE), а значит вы быстрее получите нужный результат. 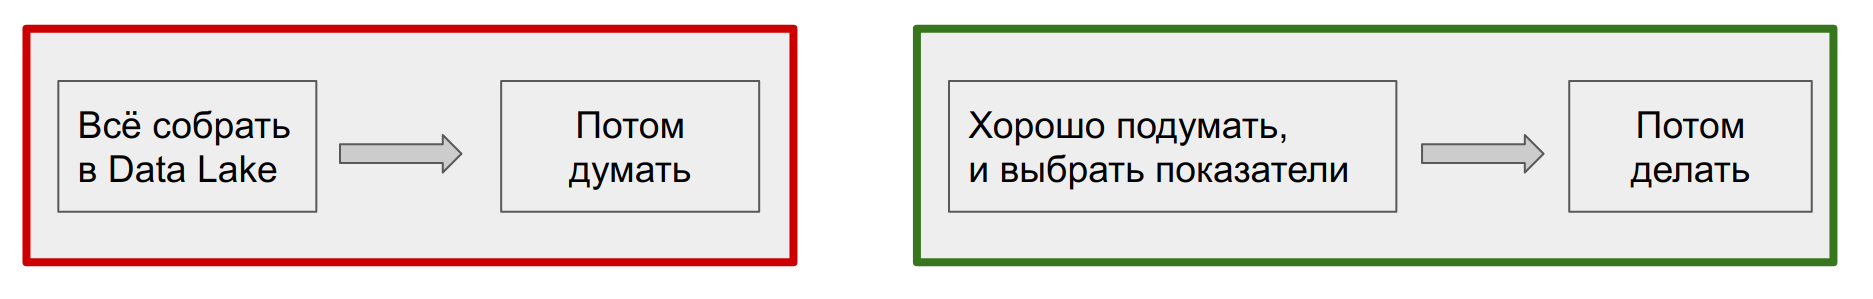
Подробнее на эту тему: Six Things You Need to Know About Data Governance, также в этой статье есть хороший раздел “Продуктовый подход к DWH” о том, какие вопросы нужно задавать пользователям при создании витрин.
Сначала логика и архитектура, потом инструменты
Часто на презентациях я вижу картинки наподобие этой →
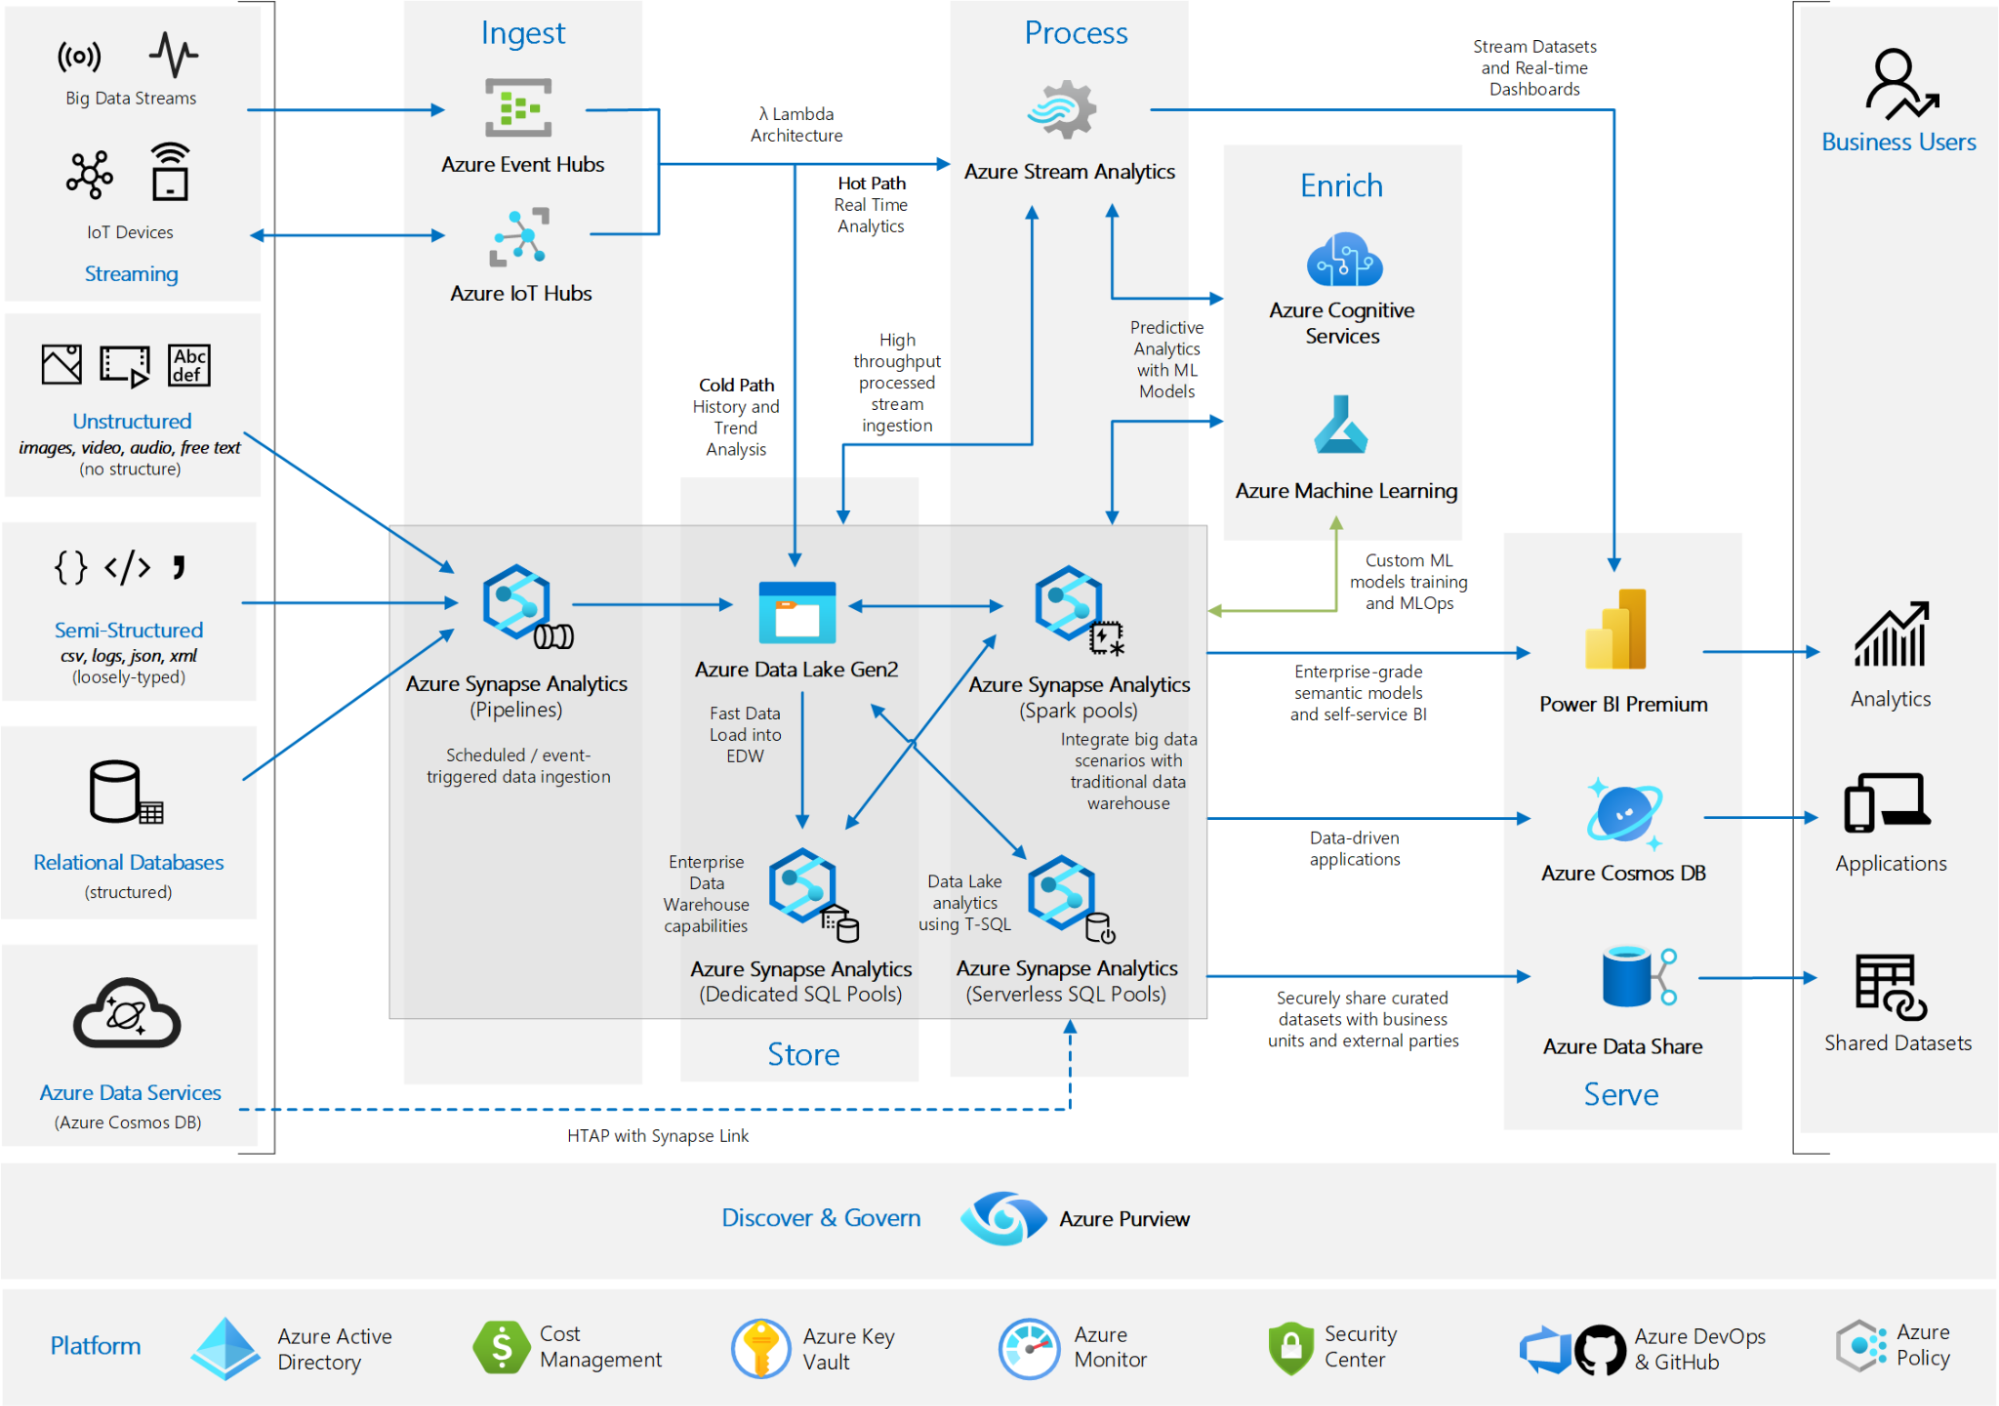
Важно помнить, что инструменты не дают методологии. Использование всего самого современного без проектирования увеличивает расходы и сложность системы.
Поэтому один из моих базовых принципов — сначала логика и архитектура, а потом инструменты. Именно логике построения DWH посвящена статья.
Основы логики и архитектуры DWH
Загрузить данные из источника А в результирующую таблицу (таргет) Б легко, но это нужно будет проделать для сотен таблиц: в стриминге и батче, инкрементами и полностью, с зависимостью одних таблиц от других, на тестовом и прод серверах и т.д. Таким образом, есть куча опций и если их не систематизировать, то скрипты загрузки DWH превратятся в страшный сон.
Поэтому, первая ключевая роль в создании DWH — архитектор, человек, который умеет думать и систематизировать. Через единообразие кода и правил нужно стремиться упростить жизнь DE. Большую часть времени DE должен тратить на создание продукта из данных.
- Подрезка (фильтрация) таблиц в источниках при получении инкремента.
- Типы загрузки таргета: append, upsert, full (snapshot), scd2, recreate.
- Типы таргетов: ods, mart, scd2, data vault сущности.
- Четко определить, что такое Джоб.
- Иметь возможность отлаживать любую джобу/расчет локально.
- Если есть ресурсы хранить “сырые данные” и историю их изменений, это упрощает исторические перерасчеты.
Джоба — основной кирпич системы. Джоба должна быть четко определена и проста.
Как лучше не делать джобы
- Большие джобы работают долго, а значит у вас меньше возможностей для маневров.
- При падении джобы её придется перезапускать полностью.
- Трудно дорабатывать джобу.
- Трудно развивать DWH.
- Частично или полностью недоступен Git: сравнение, слияние, версионность джобов и т.д.
- Ограничения на автогенерацию.
- Вендор-лок.
Первый принцип создания джоб (DAG’ов)
Одна джоба загружает один таргет (таблицу).
- Простой перезапуск или пропуск упавших джобов.
- Разделяй и властвуй — зная входные таблицы и таргет, легко управлять порядком и параллельностью запуска джобов.
Пример 1. Данные из источника попадают сразу в витрину DWH, т.е. для одного таргета нужна одна джоба. Дополнительные слои не дают ценности бизнесу, поэтому для начала я рекомендую делать именно так. Разработка такой джобы займет не больше дня.
Пример 2. Данные из источников сначала складируются в озере данных. Такой подход лучше масштабируется по данным и разработчикам, однако разработка пары джоб в такой модели займет уже 2-3 дня.
Пример 3. Если делать всё правильно по популярной методологии Data Vault 2.0, то первого полезного результата можно ждать несколько недель. Мощь Data Vault 2.0 в том, что он позволяет прозрачно масштабировать DWH на любое число таблиц и DE.
С возрастанием числа источников, таблиц в DWH и DE нужно двигаться от примера 1 к 3.
Второй принцип создания джоб (DAG’ов)
- job.py – инструкции исполнителю.
- getdata.sql – получение данных.
- recreate.sql – пересоздание таргета.
Исполнитель джобы
Когда приходит очередь выполнить определенный джоб, запускается команда
launcher.run_job(job_name=’marts.crm_bill’, method=’increment’)
Исполнитель джобы читает файл job.py из папки marts.crm_bill. Получает объект класса JobDag, и дальше выполняет задачи из него. Поскольку одна джоба загружает один таргет, все джобы маленькие – от одного до пяти шагов.
Функция ‘vertica_elt.load_data_vertica_to_vertica’ — обычная python функция, которая должна иметь следующие входные атрибуты:
Таким образом, все ELT/ETL процессы у нас запускает один исполнитель джобов. В исполнителе есть несколько хорошо отлаженных, документированных функций, которые делают всю работу.
По сути DE создает джобу декларативно. Такой подход резко снижает барьер входа для создания джобов и в разы — вероятность возникновения ошибок.
Оркестрация джобов
От исполнителя одной джобы переходим к их оркестрации.
Вариант 1. Более правильный, но сложный в поддержке. Если на уровне метаданных для каждой джобы определить источники и таргет, то можно автоматически создавать граф. Допустим job_2 уже отработал, тогда если job_3 закончит работу быстрее, чем job_1, то оркестратор запустит job_5, иначе job_4.
- Вариант 1 в идеальных условиях работает хорошо. Но бизнес может требовать много разных вещей типа “более приоритетных очередей”. Постоянное добавление логики в такую систему может сделать её очень непрозрачной.
- Одна джоба может сильно изменить граф.
В обоих вариантах есть глобальный параметр — Параллельность — количество джобов/тасков, которые можно выполнять одновременно.
Второй вариант проще в реализации и контроле, он лучше подходит на старте DWH, но глобально вариант 1 лучше, когда быстро увеличивается число таблиц и DE.
Инструменты и технологии
Данная статье не про инструменты, поэтому скажу лишь пару мыслей.
Если у вас меньше 4 терабайт данных, то не переусложняйте. Достаточно на мощном компьютере поднять PostgreSQL или ClickHouse для DWH. Плюс BI решение: Superset, Metabase или PowerBI.
Если данных больше 4 терабайт, или объемы быстро растут, то необходимо заложить горизонтальное масштабирование. Лучше, чтобы объем данных и вычислительные ресурсы можно было масштабировать по отдельности.
Hadoop — очень сложно и дорого. Почти всегда дешевле и быстрее облачная MPP + S3-совместимый storage.
Облачная MPP/Lakehouse система — ядро аналитического решения. Посмотрите на Google BigQuery, Snowflake, Databricks.
Итоги
В начале проекта как можно быстрее нужно создать ценность для бизнеса.
Сделайте хорошие витрины.
Учитесь получать профит из данных.
К более профессиональному моделированию DWH лучше переходить, когда есть первые успехи.
Сначала логика, потом инструменты – решите задачу на псевдокоде. Поймите и отработайте основные сценарии, а затем уже начинайте выбирать оркестраторы и всё остальное.
- Джоба — основной кирпич системы. Джоба должна быть четко определена и проста.
- Одна джоба загружает один таргет (таблицу).
- Джоба — это не визуальная схема, а код (мини-проект).
- job.py + унифицированный исполнитель джобов ускоряет разработку ELT/ETL процессов и снижает порог входа — инвестируйте в движок. Аналитики смогут делать джобы.
Приложение. Основные типы витрин.
- Транзакционная витрина – данные в строках не меняются.
- Витрина снимков – все данные на определенную дату.
- Накопительная витрина – у каждой строки есть дата начала и конца действия.
- Витрина на основе запроса.
Транзакционная витрина – данные в строках не меняются
Самая простая и популярная витрина. Записи из источника попадают в неё один раз и не меняются.
Преимущества этой витрины — по ней автоматически строятся правильные графики и считаются суммы, например, продажи товаров. 
Витрина снимков – все данные на определенную дату
Раз в месяц/квартал/год в такую витрину добавляются все данные из источника. Такая витрина позволяет анализировать данные которые меняются со временем, например, данные о клиентах. 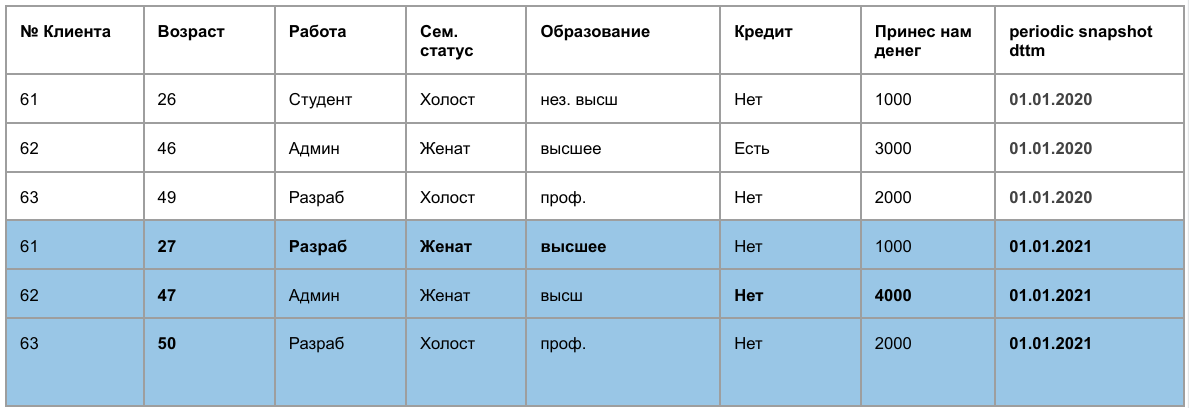
Накопительная витрина – у каждой записи есть интервал актуальности
- start_dttm, end_dttm – время актуальности записи.
- is_actual – признак актуальности записи.
- is deleted – признак удаления из источника.
Если в новых данных из источника приходит запись, которая уже есть в таргет-таблице DWH, то у записи в DWH проставляется end_dttm = NOW(), is_actual = false и после добавляется новая актуальная запись.
Таким образом в DWH есть все изменения конкретной записи, что удобно для анализа.
Витрина на основе sql запроса к источнику
К источнику делается произвольный запрос с фильтром source_table.update_dttm > MAX(target_table.update_dttm)
Чтобы не было дублей, из таргет таблицы стираются строки с id, которые пришли из источника. Опционально также могут стираться записи, удаленные из источника. Затем делается вставка всех пришедших записей в таргет.
Итоги по витринам
Все запросы к источнику обычно делаются не к продакшен базе, а к её реплике.
На мой взгляд, на старте создания DWH, описанные 4 типа витрин закроют почти все нужды бизнеса.
По мере взросления DWH, лучше переходить сразу к Data Vault минуя 3NF. Для начала крутое видео.
P. S. Чтобы статья не стала бесконечной, я сознательно исключил ряд тем, таких как: управление метаданными, генерация суррогатных ключей.
Интересно мне сообщества:
Чем отличается ваш подход?
Какие вещи я раскрыл слабо?