Joining three tables using MySQL
And what would be for normalized form, if I want to find who is manager over other:
And wants to get this result:
11 Answers 11
Use ANSI syntax and it will be a lot more clear how you are joining the tables:
For normalize form
join query with three tables and we want two values from the same column we set the alias name for every table in the joins. Same table name also declare as a different names.

Don’t join like that. It’s a really really bad practice. It will slow down the performance in fetching with massive data. For example, if there were 100 rows in each tables, database server have to fetch 100x100x100 = 1000000 times. It had to fetch for 1 million times. To overcome that problem, join the first two table that can fetch result in minimum possible matching(It’s up to your database schema). Use that result in Subquery and then join it with the third table and fetch it. For the very first join —> 100×100= 10000 times and suppose we get 5 matching result. And then we join the third table with the result —> 5×100 = 500. Total fetch = 10000+500 = 10500 times only. And thus, the performance went up.
SQL JOIN: руководство по объединению таблиц
Перевод первой части статьи «SQL Joins Tutorial: Cross Join, Full Outer Join, Inner Join, Left Join, and Right Join».
 Photo by Tim Johnson on Unsplash
Операции объединения в SQL позволяют нашим реляционным базам данных быть… хм… реляционными (англ. relational — «относительный»). Они дают нам возможность реконструировать наши отдельные базы данных с учетом отношений между ними, а это важно для наших приложений.
В этой статье вы рассмотрим все виды JOIN в SQL и расскажем, как ими пользоваться.
В первой части статьи:
(Спойлер: мы рассмотрим пять разных видов объединений, но на самом деле вам нужно знать только два из них!)
Что такое JOIN?
JOIN это операция объединения двух строк в одну. Эти строки обычно бывают из двух разных таблиц, но это не обязательно.
Прежде чем мы разберем, как писать JOIN-ы, давайте посмотрим, как выглядит объединение таблиц.
Возьмем для примера систему, в которой хранится информация о пользователях и их адресах.
Таблица, хранящая информацию о пользователях, может выглядеть следующим образом:
А таблица с адресами может быть такой:
Чтобы получить информацию и о пользователе, и о его адресе, мы можем написать два разных запроса. Но в идеале можно написать один запрос и получить все необходимые сведения в одном ответе.
Именно для этого, собственно, и нужны операции объединения!
Чуть позже мы рассмотрим, как составлять подобные запросы, а пока взгляните, как может вы глядеть результат объединения таблиц:
Мы видим всех наших пользователей сразу с их адресами.
Но операции объединения позволяют не просто выводить такие вот комбинированные сведения. У них есть еще одна важная функция: с их помощью можно получать отфильтрованные результаты.
Например, если мы хотим послать настоящие бумажные письма всем пользователям, живущим в Оклахоме, мы можем объединить таблицы и отфильтровать результаты по столбцу city .
Теперь, когда вы поняли, для чего вообще нужны операции объединения, давайте приступим к написанию запросов!
Настройка базы данных
Прежде чем писать какие-либо запросы, нужно настроить базу данных.
Для примеров в этой статье будет использоваться PostgreSQL, но запросы и концепции, показанные здесь, легко применимы в любой другой современной СУБД (MySQL, SQL Server и т. д.).
Для работы с нашей базой данных PostgreSQL мы будем пользоваться интерактивной cli-программой psql. Если у вас установлен другой клиент, вы прекрасно можете работать с ним!
Для начала давайте создадим нашу базу данных. Поскольку у нас уже установлена PostgreSQL, для создания новой базы данных мы можем запустить в терминале psql-команду createdb <имя-базы-данных> . Свою базу я назвал fcc :
Теперь давайте воспользуемся интерактивной консолью (запустив команду psql ) и подключимся к только что созданной базе данных при помощи команды \c <имя-базы-данных> :
Примечание: в примерах я подчистил вывод, чтобы их было легче читать. Поэтому не волнуйтесь, что показанный здесь output не в точности совпадает с тем, что вы видите в своем терминале.
Я советую вам прорабатывать запросы, которые мы будем составлять, писать их вместе со мной и запускать. Работая с примерами, вы поймете и запомните куда больше, чем если будете просто читать.
CROSS JOIN (перекрестное объединение)
Самое простое объединение, которое мы можем сделать, это CROSS JOIN (перекрестное объединение) или «декартово произведение».
При этом объединении мы берем каждую строку одной таблицы и соединяем ее с каждой строкой другой таблицы.
Если у нас есть два списка и в одном из них содержатся цифры 1, 2, 3 , а в другом — буквы А, В, С , то декартово произведение этих списков будет выглядеть так:
Каждое значение из первого списка соединено с каждым значением второго списка.
Давайте перепишем этот пример в виде SQL-запроса.
Для начала создадим две очень похожих таблицы и внесем в них данные:
Наши таблицы letters и numbers имеют по одному столбцу с простыми текстовыми полями.
Теперь давайте объединим эти таблицы, используя CROSS JOIN:
Это наипростейший вид объединения, но даже на этом примере мы можем видеть, как работает JOIN. Две разных строки (одна из таблицы letters , другая — из numbers ) объединяются друг с другом, образуя одну строку.
Хотя этот пример часто упоминается как чисто учебный, и для него есть практическое применение: покрытие диапазона дат.
CROSS JOIN с диапазонами дат
Хороший вариант использования CROSS JOIN — брать каждую строку таблицы и объединять ее с каждым днем из диапазона дат.
Скажем, вы создаете приложение, которое должно отслеживать ежедневную рутину (чистка зубов, завтрак, душ).
Если вы хотите генерировать запись для каждой задачи за каждый день прошлой недели, вы можете использовать CROSS JOIN с диапазоном дат.
Чтобы создать диапазон дат, мы можем воспользоваться функцией generate_series:
Функция generate_series принимает три параметра.
Первый параметр — стартовое значение. В этом примере мы использовали CURRENT_DATE — INTERVAL ‘5 day’ , то есть текущая дата минус пять дней (или «пять последних дней»).
Второй параметр — текущая дата ( CURRENT_DATE ).
Третий параметр — шаг. То есть, на сколько мы хотим инкрементировать значение. Поскольку это ежедневные задачи, мы устанавливаем в качестве интервала один день ( INTERVAL ‘1 day’ ).
Все вместе генерирует серию дат, начиная с даты пятидневной давности и заканчивая сегодняшним днем, по дню за раз.
Наконец, мы удаляем часть, касающуюся времени, преобразовывая вывод значений в дату при помощи ::DATE , и назначаем этому столбцу псевдоним (при помощи AS day ), чтобы сделать вывод красивее.
Результат запроса за последние пять дней плюс сегодняшний:
Возвращаемся к нашему примеру с ежедневными задачами. Давайте создадим простую таблицу, в которой будут содержаться наши задачи (и добавим несколько):
В нашей таблице tasks есть только один столбец — name — в который мы добавили несколько задач.
Теперь давайте осуществим перекрестное объединение наших задач с запросом на генерацию дат:
(Поскольку наш запрос для генерации дат по сути не является таблицей, мы просто написали его в виде подзапроса).
В результате мы получаем название задачи и день. Выглядит это следующим образом:
Как и ожидалось, мы получили по строке для каждой задачи на каждый день из нашего диапазона дат.
CROSS JOIN это простейшее объединение. Дальнейшие примеры потребуют более «жизненной» настройки таблиц.
Создание таблиц directors и movies
Чтобы проиллюстрировать следующие виды объединений, мы воспользуемся примером с фильмами (movies) и режиссерами (movie directors).
Каждый фильм имеет режиссера, но это не является обязательным условием. Может быть ситуация, когда фильм уже анонсировали, но режиссер еще не выбран.
В нашей таблице directors будут храниться имена всех режиссеров, а в таблице movies — названия фильмов, а также отсылка к режиссеру (если он известен).
Давайте создадим эти таблицы и внесем в них необходимые данные:
У нас есть пять режиссеров и пять фильмов, причем для трех фильмов указаны режиссеры. У режиссера с ID 1 есть два фильма, а у режиссера с ID 2 — один фильм.
FULL OUTER JOIN (полное внешнее объединение)
Теперь у нас есть данные, с которыми можно работать, так что переходим к следующему виду объединения — FULL OUTER JOIN.
FULL OUTER JOIN похоже на CROSS JOIN, но имеет важные отличия.
Первое отличие состоит в том, что для FULL OUTER JOIN требуется условие объединения.
Это условие определяет, как именно связаны строки разных таблиц и по какому критерию они должны объединяться.
В нашем примере в таблице movies есть ссылка на режиссеров через столбец director_id , который совпадает со столбцом id в таблице directors . Эти два столбца мы и будем использовать в качестве условия объединения.
Вот как это выглядит в коде:
Обратите внимание на то, как мы прописали условие, чтобы объединить фильм и его режиссера: ON movies.director_id = directors.id .
Наш результат выглядит, как некое странное декартово произведение:
Сначала идут несколько строк с фильмами, для которых указаны режиссеры: здесь наше условие явно соблюдается.
Но после мы видим оставшиеся строки из каждой таблицы, но со значениями NULL в тех местах, где в другой таблице не нашлось совпадений.
Примечание: если вы не знакомы со значениями NULL, объяснение можно почитать здесь.
Здесь мы также видим второе различие между перекрестным и полным внешним объединением. FULL OUTER JOIN соединяет одну строку первой таблицы с определенной строкой второй таблицы, а при CROSS JOIN каждая строка одной таблицы соединяется с каждой строкой другой.
INNER JOIN
Следующий вид объединения — внутреннее, INNER JOIN. Внутреннее объединение является наиболее используемым.
INNER JOIN возвращает только те строки, где соблюдается условие объединения.
Если брать наш пример с таблицами movies и directors, внутреннее объединение вернет только те записи, где у фильма есть указанный режиссер.
Синтаксис практически тот же:
В результирующую выборку попали только фильмы с режиссерами:
Поскольку внутреннее объединение дает нам только те строки, для которых соблюдается условие объединения, порядок указания таблиц не имеет значения.
Если мы поменяем местами названия таблиц в запросе, результат будет тот же:
Единственное отличие в том, что поскольку мы выбрали все столбцы ( SELECT * ) и сначала указали таблицу directors, то в результате первыми будут идти данные из этой таблицы, а дальше — из таблицы movies. Но данные, попавшие в выборку, те же.
Это полезное свойство операции внутреннего объединения: не у всех видов объединений оно есть.
Соединение таблиц
Нередко возникает необходимость в одном запросе получить данные сразу из нескольких таблиц. Для сведения данных из разных таблиц мы можем использовать разные способы. В данной статье рассмотрим не самый распространный, однако довольно простой способ, который представляет неявное соединение таблиц.
Допустим, у нас есть следующие таблицы, которые связаны между собой связями:
Здесь таблицы Products и Customers связаны с таблицей Orders связью один ко многим. Таблица Orders в виде внешних ключей ProductId и CustomerId содержит ссылки на столбцы Id из соответственно таблиц Products и Customers. Также она хранит количество купленного товара (ProductCount) и и по какой цене он был куплен (Price). И кроме того, таблицы также хранит в виде столбца CreatedAt дату покупки.
Пусть эти таблицы будут содержать следующие данные:
Теперь соединим две таблицы Orders и Customers:
При такой выборке каждая строка из таблицы Orders будет соединяться с каждой строкой из таблицы Customers. То есть, получится перекрестное соединение. Например, в Orders три строки, а в Customers то же три строки, значит мы получим 3 * 3 = 9 строк:
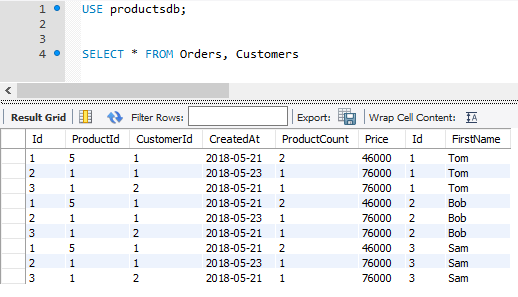
Но вряд ли это тот результат, который хотелось бы видеть. Тем более каждый заказ из Orders связан с конкретным покупателем из Customers, а не со всеми возможными покупателями.
Чтобы решить задачу, необходимо использовать выражение WHERE и фильтровать строки при условии, что поле CustomerId из Orders соответствует полю Id из Customers:
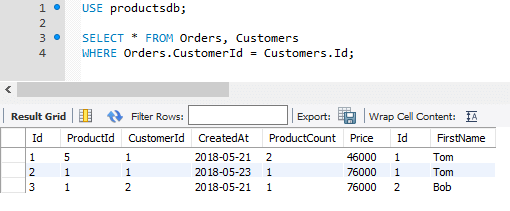
Теперь объединим данные по трем таблицам Orders, Customers и Proucts. То есть получим все заказы и добавим информацию по клиенту и связанному товару:
Так как здесь нужно соединить три таблицы, то применяются как минимум два условия. Ключевой таблицей остается Orders, из которой извлекаются все заказы, а затем к ней подсоединяется данные по клиенту по условию Orders.CustomerId = Customers.Id и данные по товару по условию Orders.ProductId=Products.Id
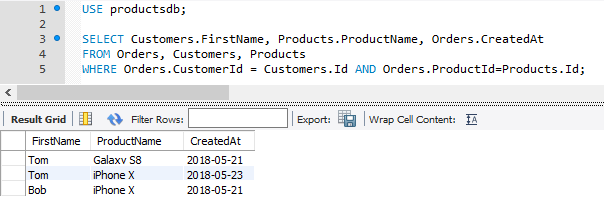
В данном случае названия таблиц сильно увеличивают код, но мы его можем сократить за счет использования псевдонимов таблиц:
Если необходимо при использовании псевдонима выбрать все столбцы из определенной таблицы, то можно использовать звездочку: